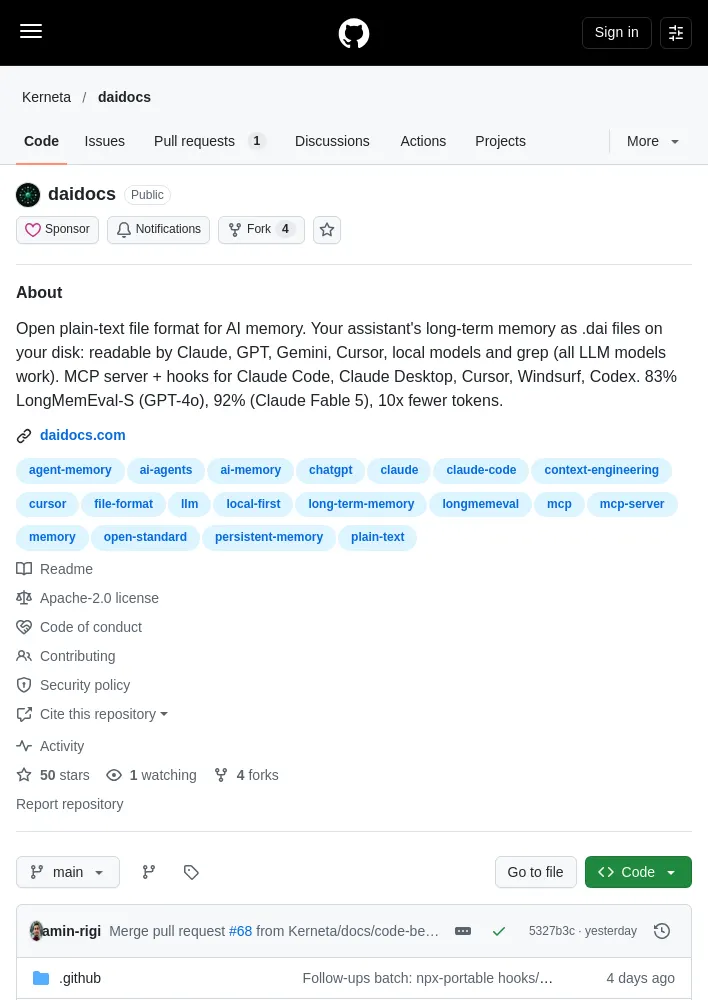
오픈소스 프로젝트 DaiDocs가 5.1.1 버전에서 대화 기록과 문서용 .dai에 코드 그래프용 .cai를 더했다. 제작자 Kerneta는 LongMemEval-S에서 GPT-4o 기준 83.00%를 기록했고, 코드 검색 벤치마크에서는 Graphify보다 적은 토큰으로 비슷하거나 높은 정확도를 냈다고 밝혔다.
DaiDocs는 기록을 로컬의 일반 텍스트 파일로 저장한다. .dai는 문서와 대화 기록을, .cai는 코드의 호출 관계·정의·의존성 등을 담는다. 두 형식은 각각 독립적으로 쓸 수 있으며, 함께 설치하면 질문에 맞춰 문서·기록 또는 코드 그래프를 조회하는 라우터가 작동한다. .cai 그래프는 tree-sitter로 생성하며, 제작자 설명에 따르면 모델이나 API 호출이 필요하지 않다.
벤치마크와 조건
Kerneta는 LongMemEval-S의 500개 질문에서 GPT-4o가 415개에 정답을 내 83.00%를 기록했다고 보고했다. 같은 모델에 메모리 시스템 없이 전체 대화 기록을 제공한 벤치마크 기준은 60.60%로, 차이는 22.40%포인트다. 질문당 읽은 토큰은 평균 10,065개로, 평균 103,601개인 기록 전체를 읽는 방식보다 약 10.3배 적었다. 이 결과는 벤치마크 제작자의 평가 도구로 채점한 수치이며, 제작자는 재현 가능한 메모리 시스템 가운데 2위라고 설명한다. Mastra Observational Memory의 84.80%가 더 높았고, 두 결과의 차이는 500회 단일 실행에서의 표준오차 범위 안이라고 덧붙였다.
코드 검색 비교에서 psf/requests 16개 질문은 .cai가 55토큰으로 16개 모두 맞혔고, Graphify는 689토큰으로 13개를 맞혔다. httpx의 import 관계 질문에서는 .cai가 22토큰으로 100% 정확도를 기록했고 Graphify는 4,696토큰으로 91%를 기록했다. 이는 프로젝트가 제시한 벤치마크 결과이며, 전체 조건과 재현 방법은 결과 문서와 코드 벤치마크 자료에서 확인할 수 있다.
설치와 이용 시 고려할 점
문서·대화 기록 기능은 Node 18 이상에서 npx daidocs setup으로 설치한다. 코드 그래프는 Python 3.10 이상에서 pip install kerneta-cai로 설치한다. 설치 안내와 전체 사용법은 빠른 시작과 가이드에 있다.
프로젝트는 로컬 저장과 일반 텍스트 파일 사용을 내세우지만, 과거 기록을 모델로 변환할 때는 API 키 사용 여부에 따라 비용이 발생할 수 있다. 짧은 기록에서는 메모리 검색의 이점이 작을 수 있고, 세션 시작 때 약 2,000~3,000토큰의 고정 문맥 비용이 든다고 프로젝트는 설명한다. 브라우저 확장 기능은 기본적으로 수집이 꺼져 있으며, 사용자가 동의해 켜야 한다. 설치 전 데이터와 설정을 백업하고 별도 환경에서 시험하라는 안전 평가 안내도 제공한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요