TL;DR
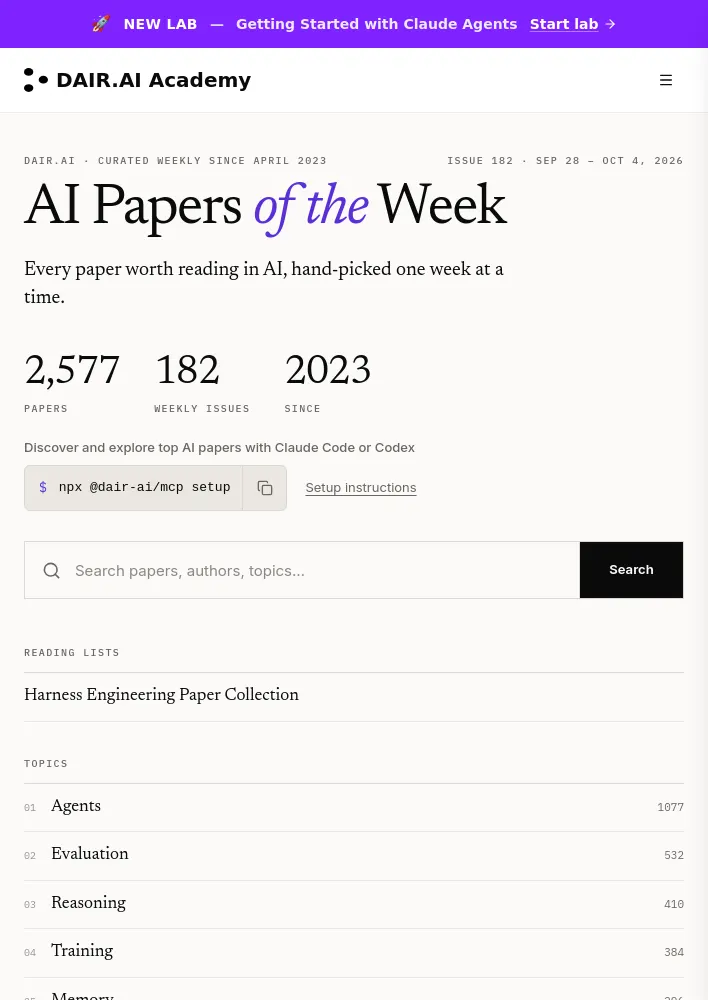
- DAIR.AI가 2023년 4월부터 매주 큐레이션한 AI 논문 2,577편과 182개 주간호를 Claude Code 또는 Codex에서 탐색하는 MCP 도구를 제공함.
- 이번 주 논문은 코딩 에이전트의 문맥 압축을 학습하는 AutoCompact로, SWE-bench Verified에서 9.2포인트, SWE-PolyBench Verified에서 5.0포인트의 통과율 상승을 보임.
- 이번 호는 다중 턴 도구 사용의 학습 시점을 찾는 Critical-State RL, 검증 가능한 에이전트 훈련 환경을 생성하는 AutoGym·SkillGym 등 에이전트 연구 10편을 다룸.
- SkillGym 환경으로 미세 조정한 Qwen3.5-35B-A3B는 Claude Code에서 Terminal-Bench 2.1 점수를 19.10포인트, SkillsBench v1.1 점수를 28.13포인트 높임.
- Agensh는 중앙 오케스트레이터 없이 코딩 에이전트 1,024개로 확장하며, Jev-Mem은 메모리 관련 결정을 경량 컨트롤러에 맡김.
주간 AI 논문
- DAIR.AI는 2023년 4월부터 매주 읽을 가치가 있는 AI 논문을 선별해 왔으며, 이번 호는 182호, 발행 기간은 2026년 9월 28일~10월 4일임.
- 누적 큐레이션 규모는 논문 2,577편, 주간호 182개임.
- Claude Code 또는 Codex에서 주요 AI 논문을 탐색하고 살펴볼 수 있으며, MCP 설정에는
npx @dair-ai/mcp setup명령을 사용함.
이번 주 논문
- 이번 호는 논문 10편으로 구성되며, 주간 논문으로 코딩 에이전트의 문맥 압축을 학습하는 연구를 선정함.
- AutoCompact: 장기 코딩 에이전트에서 문맥 압축 시점 학습
- 코딩 에이전트가 자체 정책의 일부로 문맥을 언제 압축할지, 어떤 작업 상태를 보존할지, 압축 후 어떻게 이어갈지를 결정하도록 학습함.
- 심판 모델이 기본 에이전트의 압축 결정을 검토하고 실행 전에 결함 있는 결정을 대체함. 수정된 궤적을 지도 미세 조정(SFT)에 사용한 뒤, 과제 성공률을 기준으로 코딩과 압축을 함께 최적화하는 강화학습(RL)을 수행함.
- SWE-bench Verified 통과율이 9.2포인트, SWE-PolyBench Verified 통과율이 5.0포인트 상승함. 오버플로가 발생하지 않는 256K 문맥 창과 강제 압축으로 전환되는 16K 문맥 창 모두에서 성능 향상이 유지됨.
- Context Language Models
- 에이전트 하네스는 보통 요약이나 압축 같은 고정 규칙으로 모델의 문맥을 관리함. Meta 연구진과 공동 연구진은 실시간 문맥을 모델이 자유롭게 편집하는 파일로 취급하는 문맥 언어 모델(CLM)을 제안함.
- 모델이 문맥에서 무엇을 유지하고, 다시 쓰고, 제거할지 직접 결정함.
- Critical-State RL: 다중 턴 도구 사용을 위한 학습 가능한 상태 진단
- Salesforce AI Research의 Critical-State RL은 다중 턴 도구 사용 상호작용에서 학습이 도움이 되는 단 하나의 호출을 찾음. 이후 턴에 좌우되는 보상 변동은 현재 행동보다 후속 과정의 무작위성에서 비롯되는 경우가 있기 때문임.
- 중첩 샘플링으로 행동에 따른 보상 변동과 후속 과정의 잡음을 분리한 다음, 선택된 호출만 문맥적 밴딧 업데이트로 학습함.
- BFCL v4의 누락 함수 과제에서 선택된 턴을 학습하면 성능이 약 14포인트 상승하지만, 다른 턴을 학습하면 정확도가 그대로이거나 낮아짐.
- AutoGym: 청사진 우선 방식의 검증 가능한 에이전트 훈련 환경 생성
- 강화학습(RL)으로 에이전트를 훈련하려면 과제, 에이전트가 과제를 수행할 실행 환경, 성공과 실패를 안정적으로 구분하는 검증기로 구성된 훈련 환경이 필요함.
- 이런 환경은 여전히 수작업으로 구축되고, 모델 성능이 향상되면 포화되며, 오염에 노출됨. Amazon AGI 연구진은 최소한의 도메인 시드 또는 기존 모델 궤적에서 완전한 훈련 환경을 생성하는 AutoGym을 제시함.
- SkillGym: 실제 문제 해결을 위한 인간 기술의 대형 언어 모델 내재화
- 인간이 작성한 에이전트 기술을 12개 범주, 검증 가능한 훈련 환경 2,756개로 변환하고, 코드 기반 검사기를 각 환경에 적용함. 미세 조정에 사용할 성공 궤적 8,364개도 수집함.
- Claude Code 환경에서 Qwen3.5-35B-A3B를 미세 조정한 결과, Terminal-Bench 2.1 점수가 19.10포인트, 기술을 활용하는 SkillsBench v1.1 점수가 28.13포인트 상승해 51.47%에 도달함. 이는 보고된 Claude Sonnet 4.6 및 GPT-5.4 Mini 점수를 웃돎.
- 기술을 불러오지 않은 상태에서도 훈련 모델은 기술이 문맥에 포함된 기본 모델보다 높은 성능을 보임.
- Harness as a Language: 최대 표현력을 위한 미니멀리스트 에이전트 프레임워크
- 장기 기억과 자기 개선 기능은 보통 에이전트 루프 주변에 별도 시스템으로 구축됨. MIT CSAIL 연구진은 에이전트 루프 자체에 가까운 최소 하네스가 이 시스템들이 겨냥하는 과제에서 어디까지 가능한지 시험하기 위해 JAZ를 구축함.
- The Tasteful Agent: 장기 과제에서 에이전트의 안목 측정 및 개선
- 장기 과제에서는 어떤 가설을 시험할지, 어떤 구현을 기반으로 삼을지 같은 결정이 전체 실행 결과를 좌우함.
- Microsoft 연구진과 공동 연구진은 이런 결정을 잘 내리는 능력을 에이전트의 안목(taste)이라 부르고, 이를 측정하는 Taste-Bench를 구축함.
- 코딩 에이전트는 강력한 프롬프트 최적화 도구임
- GEPA 같은 검색 기반 프롬프트 최적화 도구는 편집안을 제시하고, 새 롤아웃을 실행해 점수를 매긴 뒤 검증 지표를 개선하는 편집안만 유지함.
- Microsoft 연구진은 에이전트 궤적 자료집이 이미 있는 경우 이 반복 과정이 불필요할 수 있음을 보임.
- Agensh: 조직 지능을 에이전트 1,024개로 확장
- 다중 에이전트 하네스는 보통 작업을 배정하고 작업자를 조율하는 중앙 오케스트레이터에 의존하며, 이 오케스트레이터가 시스템에서 사용할 수 있는 에이전트 수를 제한함.
- Microsoft Research는 중앙 오케스트레이터가 없는 자기 조직화 다중 에이전트 하네스 Agensh를 소개하고, 이를 코딩 에이전트 1,024개 규모로 확장함.
- Jev-Mem: 효율적인 AI 에이전트를 위한 시스템 1 제어 에이전트 메모리
- 많은 에이전트 메모리 시스템은 자기회귀 대형 언어 모델(LLM)이 메모리의 구성, 검색, 활용 방식을 결정하게 함. 이로 인해 모든 메모리 작업의 핵심 경로에 비용이 높은 생성 과정이 놓임.
- Jev-Mem은 시스템 1·시스템 2 인지에서 설계를 가져와 해당 결정을 경량 컨트롤러에 맡김.
주간호 기록
- 이번 호는 2026년 9월 28일~10월 4일 주간의 논문 10편을 포함함.
- 시각화는 2023년 4월부터 2026년 9월까지의 주별 AI 연구 논문을 보여주며, 주간 항목에 마우스를 올려 내용을 확인하고 선택해 열 수 있음.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요