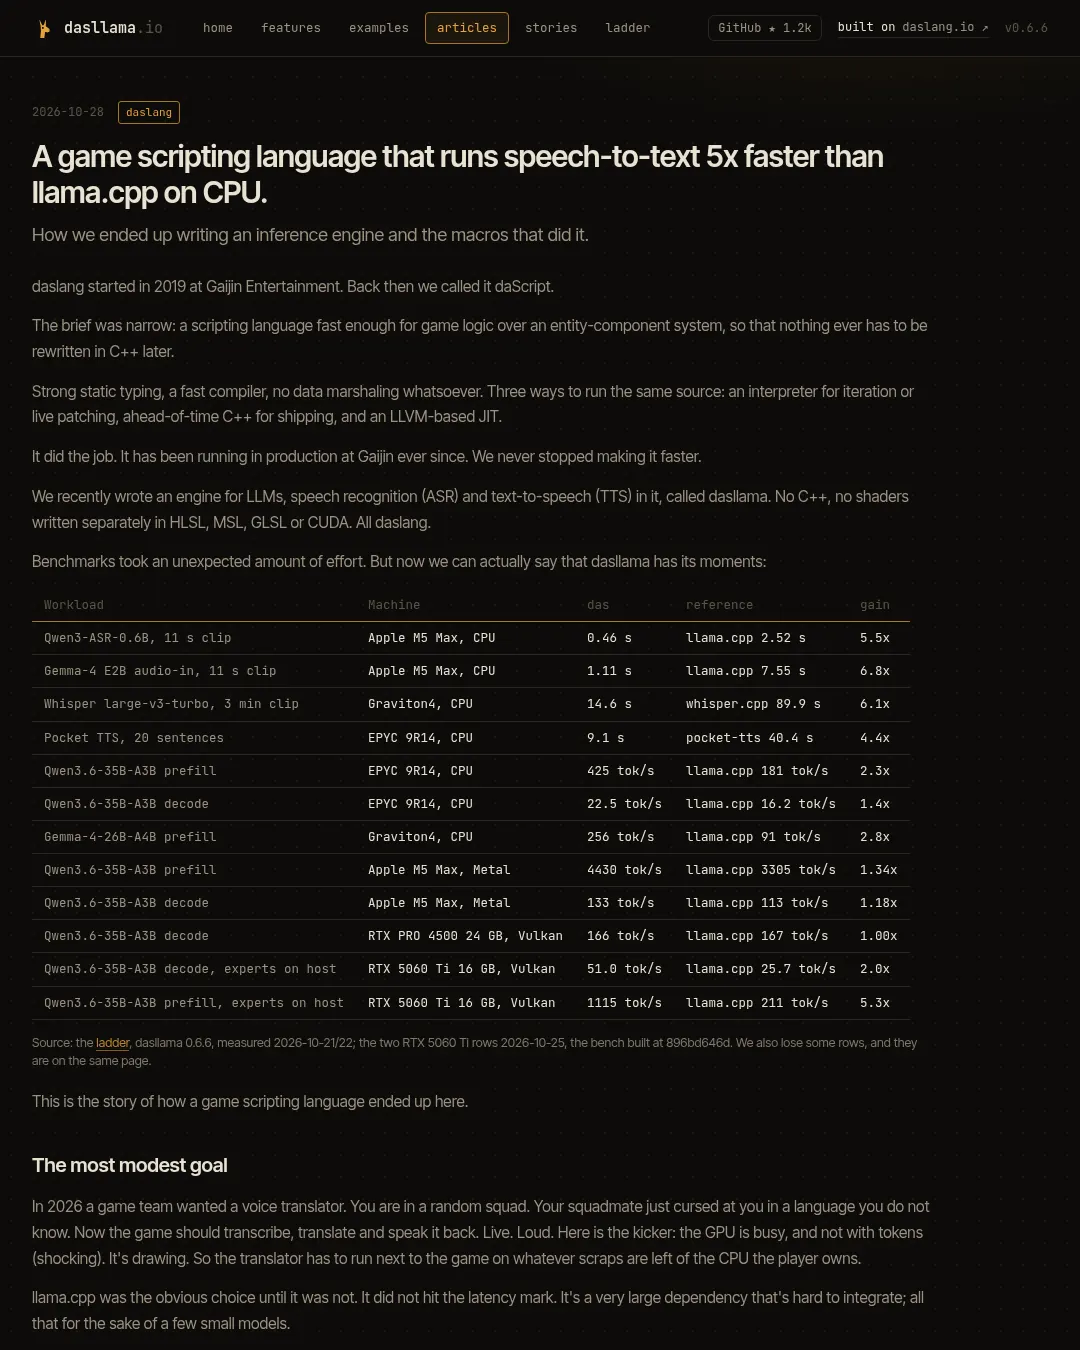
Gaijin Entertainment가 개발한 게임 스크립트 언어 daslang으로 만든 추론 엔진 dasllama가 일부 CPU 음성 인식·음성 합성 작업에서 llama.cpp나 각 작업의 기준 엔진보다 높은 처리 속도를 기록했다. 제작진이 공개한 측정치로, 모델과 하드웨어에 따라 차이가 크며 모든 작업에서 앞서는 것은 아니다.
dasllama 0.6.6의 2026년 10월 21~22일 측정에서 Apple M5 Max CPU로 11초짜리 Qwen3-ASR-0.6B 오디오를 처리하는 데 0.46초가 걸렸다. llama.cpp의 2.52초보다 5.5배 빠르다. 같은 기기에서 11초 분량의 Gemma-4 E2B 오디오 입력은 1.11초로, llama.cpp의 7.55초보다 6.8배 빨랐다. Graviton4 CPU에서 3분짜리 Whisper large-v3-turbo는 14.6초로, whisper.cpp의 89.9초보다 6.1배 빨랐다. 반면 RTX PRO 4500의 Vulkan 환경에서 Qwen3.6-35B-A3B 디코딩은 llama.cpp와 거의 같은 속도였다.
제작진은 게임 중 GPU가 그래픽 처리에 쓰일 때 남는 CPU 자원으로 음성 번역을 실행하려는 요구에서 개발을 시작했다고 설명한다. 엔진은 음성 인식(ASR), 대형 언어 모델(LLM), 음성 합성(TTS)을 지원한다. daslang의 매크로는 여러 커널 조합을 생성하고 성능을 시험해 기기와 모델에 맞는 조합을 고른다. 선택 결과는 JSON 파일로 저장되며, CPU 종류별 사전 튜닝 파일도 제공한다. GPU 커널은 공통 템플릿에서 변형을 만들고 Vulkan·Metal·CUDA용으로 내보낸다.
성능은 작업과 기기에 따라 다르다. 16GB RTX 5060 Ti에서 전문가 가중치를 호스트 메모리에 두고 실행한 Qwen3.6-35B-A3B는 프리필에서 llama.cpp보다 5.3배, 디코딩에서 2배 빨랐지만, 4개 스트림 디코딩은 llama.cpp보다 느렸다. 제작진은 일부 CPU 경로가 아직 튜닝되지 않았고, Qwen3-ASR은 Granite Rapids에서 llama.cpp보다 느리며 x86 서버의 Kitten TTS nano도 기준 엔진보다 느린 구간이 있다고 밝혔다. CUDA 지원은 개발 중이며 아직 공개 벤치마크가 없다.
설치 방법과 지원 모델은 dasllama 사이트와 기능 목록에서 확인할 수 있다. 측정 결과 전체는 벤치마크 사다리에 공개돼 있다. 소스 코드는 BSD 3-clause 라이선스로 GitHub 저장소에서 제공한다.
부록: 원문 예시
[hint(unsafe_range_check, noalias=x, noalias=w)] def dv_w16u4(w, x : float const?; n : int64) { var acc = 0.0 for [vectorize, vectorize_width=16, unroll_count=4] (j in range64(n)) { acc += unsafe(w[j]) * unsafe(x[j]) } return acc }
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요