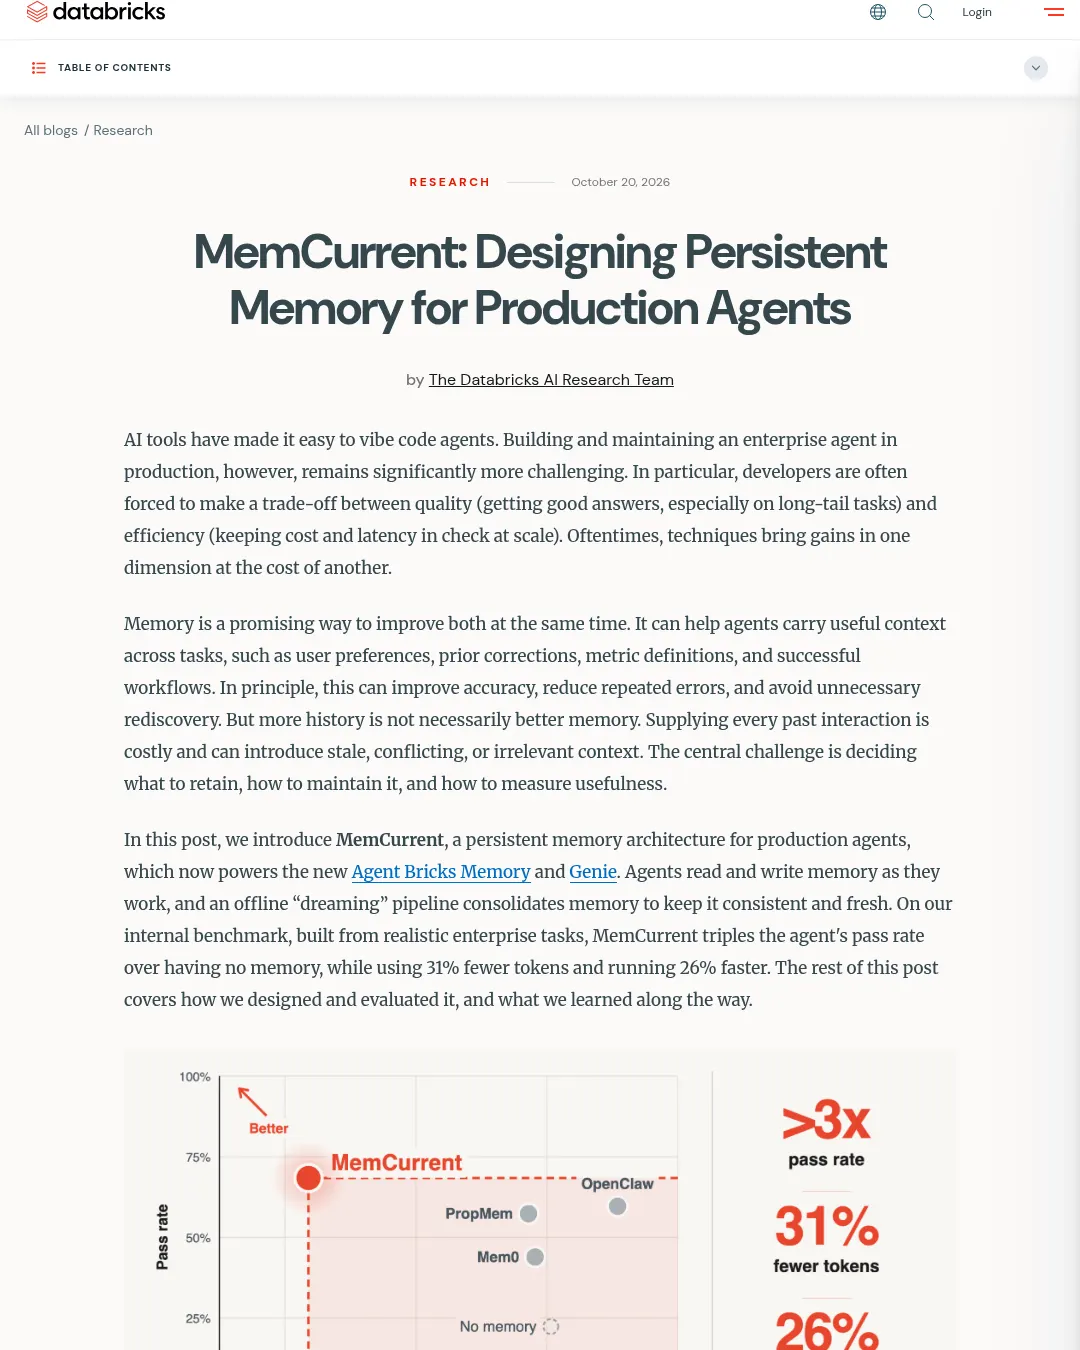
Databricks는 운영 환경의 에이전트가 여러 작업에서 얻은 정보를 기억하도록 하는 메모리 구조 MemCurrent를 공개했다. Databricks 내부 벤치마크에서 MemCurrent는 메모리가 없는 경우보다 에이전트의 작업 통과율을 세 배 높였고, 토큰 사용량은 31% 줄이며 실행 속도는 26% 높였다고 밝혔다.
MemCurrent는 과거 대화 전체를 매번 에이전트에 제공하는 대신, 원시 대화 기록과 그 기록에서 추린 지식을 함께 저장한다. 에이전트는 작업 중 메모리를 읽고 쓸 수 있으며, 별도의 백그라운드 처리 과정이 저장된 정보를 정리한다. 이 구조는 Databricks의 Agent Bricks Memory와 Genie에 적용됐다.
메모리 저장과 활용 방식
MemCurrent는 에피소드 메모리와 파생 메모리로 구성된다. 에피소드 메모리는 세션에서 발생한 원시 기록을 저장하고, 파생 메모리는 기록에서 추린 지식을 구조화된 파일 형태로 보관한다. 자동 생성되는 memory.md 색인에는 파일 구조와 각 파일의 내용이 담긴다.
세션이 진행되는 동안 플러그인이 각 단계를 에피소드 메모리에 기록한다. 파생 메모리는 두 경로로 갱신된다. 에이전트 도구 add_memory, update_memory, delete_memory는 “/tmp 디렉터리에 스크립트를 쓰지 말라”와 같은 명시적 요청을 반영한다. 오프라인 ‘드리밍’ 파이프라인은 새 세션에서 암묵적으로 드러난 지식을 관련 파일에 정리하고, 파일 분할과 중복 병합, 충돌 해결도 수행한다.
세션 시작 시 플러그인이 메모리 색인을 에이전트에 제공한다. 작업 중에는 search_memory로 관련 기록이나 메모리 파일의 일부를 찾고, fetch_memory로 세션 ID나 파일 경로에 해당하는 전체 항목을 불러올 수 있다. Databricks는 자동 플러그인, 에이전트가 호출하는 도구, 오프라인 파이프라인을 함께 사용한다. 플러그인과 도구는 변경 사항을 바로 반영할 수 있지만 실행 비용과 지연이 늘 수 있고, 오프라인 파이프라인은 비용과 지연을 줄이는 대신 갱신 내용이 늦게 반영될 수 있다.
벤치마크와 결과
Databricks는 공개 벤치마크인 LoCoMo, LongMemEval, ConvoMem과 자체 내부 메모리 벤치마크에서 MemCurrent를 평가했다. 공개 벤치마크는 합성 대화에서 앞서 나온 사실을 기억하는지를 측정한다. 내부 벤치마크는 실제 Genie 대화에서 만들었다. 1만 2,000개가 넘는 세션에서 메모리 활용 가치가 있는 후보 3,000개를 추리고, 후속 질문과 평가 기준을 만들었다. 같은 사용자의 다른 세션을 테스트 사례에 추가했으며, 적대적 평가자 검토와 수동 검토를 거쳐 29명의 사용자, 과거 세션 2,233개를 포함한 114개 사례를 구성했다.
내부 벤치마크는 실제 데이터 작업을 다루며, 과거 대화에서 답을 찾아내는 데 그치지 않고 그 지식을 여러 단계의 작업에 적용해야 한다. 사례는 사용자 프로필, 선호, 도메인 지식, 프로젝트, 작업 흐름 등 5가지 메모리 유형과 직접 지시, 변경되거나 오래된 사실, 여러 세션의 정보 결합, 메모리와 무관한 질문 등을 포함한 11가지 시나리오로 구성됐다.
공개 벤치마크에서는 같은 기반 언어 모델을 사용해 MemCurrent를 Mem0, PropMem, OpenClaw memory와 비교했다. 메모리를 전혀 쓰지 않는 기준과 모든 과거 세션을 넣는 기준도 함께 측정했다. 세 벤치마크의 평균에서 MemCurrent의 정확도는 88.1%로 전체 문맥을 넣은 방식의 87.8%와 비슷했으며, 질문당 입력 토큰은 약 12분의 1인 8,400개 대 10만 3,000개였다. 과거 기록이 가장 긴 두 벤치마크에서는 전체 기록을 프롬프트에 넣는 방식보다 높은 점수를 얻었다고 Databricks는 밝혔다.
내부 벤치마크에서 MemCurrent의 통과율은 68.4%였고, 평균 지연 시간은 252초, 토큰 사용량은 41만 8,000개였다. 메모리를 쓰지 않은 경우 통과율은 22.3%, 정답 메모리만 제공한 기준은 78.6%였다. Databricks는 MemCurrent가 메모리 없는 기준보다 통과율을 세 배 높이고, 1.35배 빠르며 비용을 1.44배 줄였다고 보고했다. 비교에는 에이전트 모델로 Claude Opus 4.6, 메모리 모델로 GPT 5.6 sol을 사용했으며, 세 차례 반복 측정했다.
구성 요소별 분석과 적용
Databricks의 구성 요소별 분석에서 에피소드 메모리만 사용했을 때 통과율은 35.8%였다. 파생 메모리만 사용하면 66.1%로 올랐고, 두 메모리를 함께 쓰면 68.4%였다. 파생 메모리의 색인이 에이전트에 저장된 정보와 찾아볼 시점을 알려줘, 원시 기록만 사용하는 경우보다 더 큰 효과를 냈다는 설명이다. 에피소드 메모리는 요약 과정에서 빠진 세부 사항을 보충했다.
파생 메모리 추출 방식만 비교하면 오프라인 드리밍은 63.5%, 온라인 도구는 53.9%의 통과율을 기록했고, 두 방식을 결합했을 때 66.1%로 가장 높았다. Databricks는 명시적 요청은 온라인 도구로 즉시 반영하고, 암묵적 학습과 메모리 정리는 드리밍에 맡기는 구성이 효과적이었다고 설명했다.
Databricks가 소개한 사례에서는 한 사용자의 피드백을 메모리에 저장한 뒤, 에이전트가 다음 작업에서 실제 SQL 실행 결과를 읽도록 했다. 또 다른 사례에서는 SDP 고객 분석 작업의 절차를 메모리에 저장해 관련 후속 질문에 재사용했다. Databricks에 따르면 첫 작업은 도구 호출 11회와 하위 에이전트 8개를 사용해 약 6분이 걸렸고, 이후 관련 작업은 도구 호출 2회와 하위 에이전트 1개로 41초 만에 끝났다. 두 사례는 내부 Genie 세션을 익명화해 제시한 것이다.
MemCurrent는 Agent Bricks Memory에서 Lakebase를 기반으로 제공된다. 구성에는 에피소드 메모리용 세션 저장소, 파생 메모리 저장소, 자동 드리밍 파이프라인, 메모리가 에이전트 품질에 미치는 영향을 포함한 추적·평가 기능이 들어간다. Databricks는 전체 기능을 갖춘 예제 에이전트를 10분 이내에 시작하도록 돕는 CLI도 제공한다고 밝혔다. 자세한 내용은 Agent Bricks Memory 문서에서 확인할 수 있다. Genie에서는 MemCurrent가 응답 품질을 높이고 지연 시간과 비용을 줄이는 데 쓰이고 있다고 Databricks는 설명했다. Genie 문서에서 관련 내용을 확인할 수 있다.
Databricks는 MemCurrent가 특정 에이전트나 언어 모델에 묶이지 않는 지식 기반으로 활용될 수 있으며, 사용자가 다른 에이전트나 모델로 옮길 때 함께 이동하거나 조직 내 공유 지식의 바탕이 될 가능성을 살펴보고 있다고 밝혔다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요