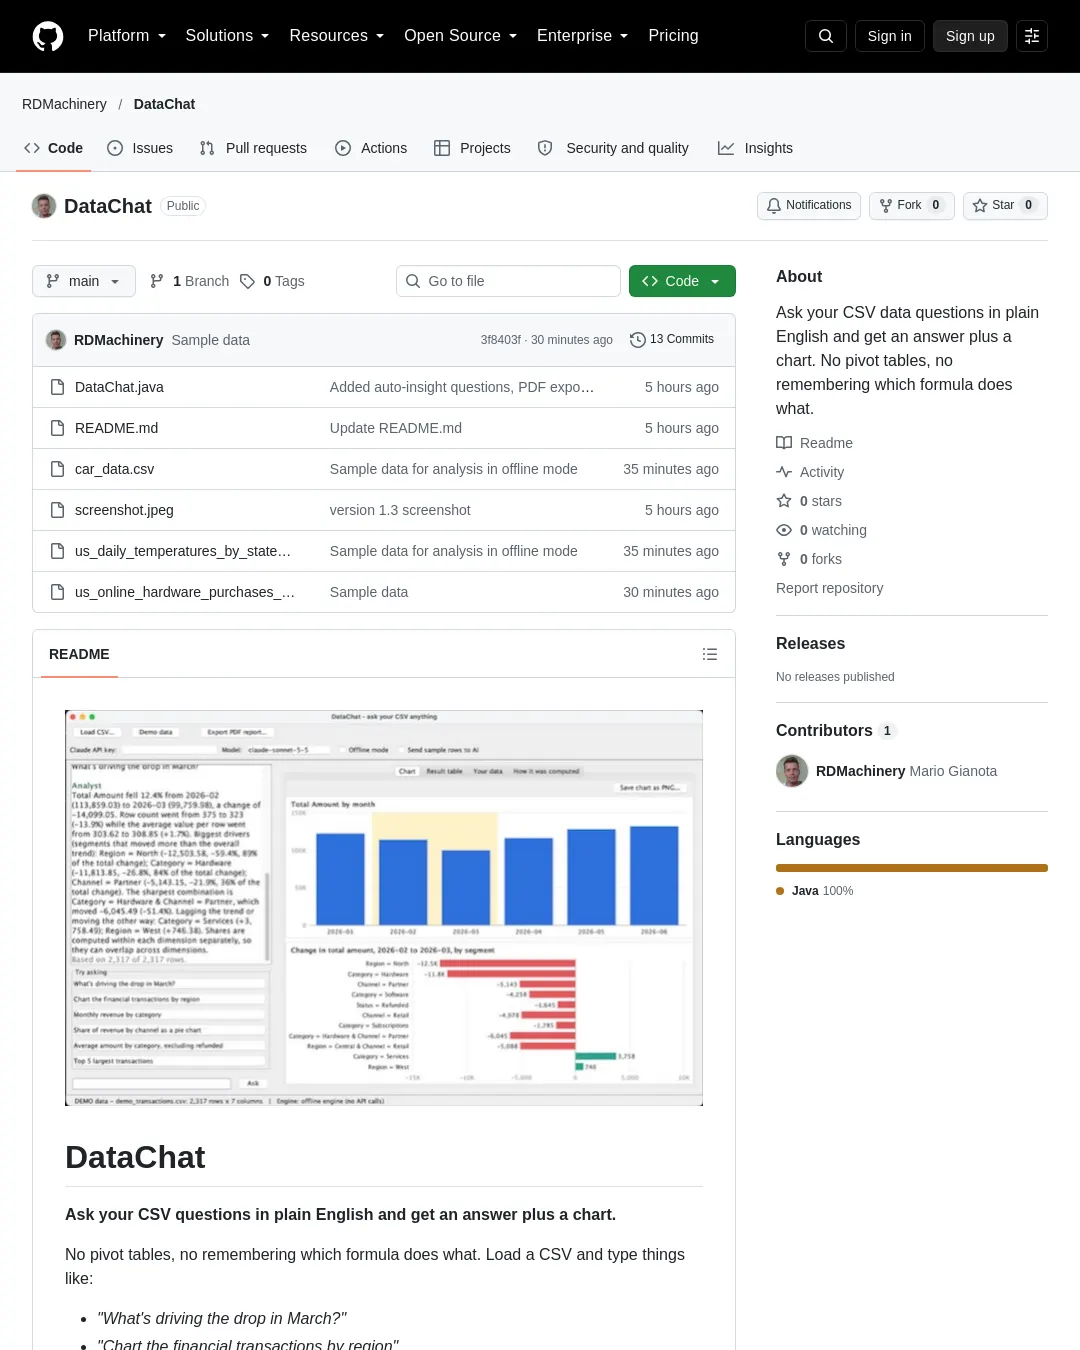
DataChat은 CSV 파일을 불러온 뒤 자연어로 질문하면 답변과 차트를 제공하는 Java 데스크톱 앱이다. 피벗 테이블을 만들거나 수식을 외울 필요 없이 “3월 매출 하락의 원인은 무엇인가?”, “지역별 금융 거래를 차트로 보여줘”처럼 질문할 수 있다.
앱은 외부 의존성 없는 단일 Java 파일로 구성된다. 자연어 이해에는 Anthropic API를 통한 Claude를 사용할 수 있고, API 키 없이 체험할 수 있도록 내장 오프라인 엔진과 데모 데이터도 제공한다.
설치와 시작
Java 17 이상이 필요하며, 아래 명령을 실행하려면 JDK가 있어야 한다. 저장소는 Java 11 이상 소스 실행기도 사용할 수 있다고 안내한다.
# Run directly from source (Java 11+ source launcher)
java DataChat.java

# or compile first
javac DataChat.java
java DataChat
앱을 열면 데모 데이터가 이미 불러와져 있어 예시 질문을 바로 클릭할 수 있다.
Claude를 선택적으로 사용하려면 도구 모음의 Claude API key 입력란에 키를 붙여 넣거나, 실행 전에 환경 변수를 설정한다.
export ANTHROPIC_API_KEY="sk-ant-..."
export ANTHROPIC_MODEL="claude-sonnet-5-5" # optional; this is the default
java DataChat.java
API 키는 메모리에만 보관하고 디스크에는 저장하지 않는다. 키가 없거나 Offline mode를 선택하면 내장 규칙 기반 엔진이 답변한다.
CSV 파일은 Load CSV...를 눌러 불러오거나 .csv, .tsv, .txt 파일을 창에 끌어다 놓으면 된다. Demo data를 누르면 내장 샘플을 불러오거나 다시 불러온다. 데모는 2026년 1월부터 6월까지의 합성 금융 거래 2,317건으로, 열은 TransactionID, Date, Region, Category, Channel, Status, Amount다. 이 데이터에는 3월 하락이 North 지역의 매장 폐쇄와 Hardware 범주의 공급 부족으로 발생했다는 의도된 사례가 들어 있다. “What's driving the drop in March?”라고 물으면 두 요인이 분석에 나타나도록 구성돼 있다.
창의 도구 모음에는 CSV 불러오기, 데모 데이터, PDF 보고서 내보내기가 있다. PDF 내보내기는 질문을 한 번 이상 해야 활성화된다. 도구 모음 아래쪽에서는 Claude API 키와 모델 이름, 오프라인 모드, AI에 샘플 행을 보낼지 여부를 설정한다. 왼쪽 채팅 영역에는 질문과 쉬운 말로 쓴 답변, 자동 인사이트, 클릭 가능한 예시 질문이 표시된다. 차트 탭에서는 최신 답변의 차트를 보고 값에 마우스를 올려 정확한 수치를 확인하거나 PNG로 저장할 수 있다. 결과 표 탭에서는 답변의 수치를 확인하고 CSV로 저장한다. Your data 탭에는 불러온 CSV를 스크롤해 볼 수 있는 화면이 있고, How it was computed 탭에는 실행한 JSON 분석 계획, 사용한 행 수, 계산된 사실이 표시된다. 상태 표시줄은 파일 이름, 행·열 수와 활성 엔진(Claude 또는 오프라인)을 보여준다.
채팅 아래 입력란에 질문을 쓰고 Enter를 누르거나 Ask를 클릭하면 된다. Claude를 사용할 때는 “이제 채널별로 나눠줘”, “North 지역만 보여줘”처럼 앞선 질문을 이어서 물을 수 있다. 이전 대화 중 최근 세 차례가 문맥으로 전송된다.
질문과 분석 결과
예를 들어 “Chart the financial transactions by region”은 지역별 Amount 합계 막대 차트를, “Monthly revenue by category”는 범주별 선을 그린 월별 차트를 요청한다. “What's driving the drop in March?”는 추세 차트와 하락을 일으킨 세그먼트의 순위별 분석을 제공한다. “Why did revenue rise in May?”는 상승에 같은 분석을 적용하고, “Compare February and March”는 지정한 두 기간을 비교한다. “Share of revenue by channel as a pie chart”는 비율을 표시한 원형 차트를, “Average amount by category, excluding refunded”는 환불 건을 제외한 범주별 평균을 요청한다.
그 밖에 “How many transactions per month?”는 월별 행 수를, “Revenue by weekday”는 월요일부터 일요일까지의 합계를, “Show amount by region for Q2”는 날짜를 필터링한 지역별 합계를 보여준다. “Top 5 largest transactions”는 가장 큰 거래 다섯 건을 표로, “Describe this data”는 열별 개요를 제공한다.
파일을 불러오면 DataChat은 데이터를 살펴보고 더 확인해 볼 만한 항목을 채팅에 표시한다. 각 인사이트에는 탐색 링크가 붙으며, 클릭하면 입력 없이 전체 분석과 표, 차트, 설명을 실행한다. 최대 다섯 개를 정해진 우선순위대로 보여준다.
- 가장 큰 하락: 주요 측정값의 기간별 하락이 10% 이상이면 표시한다. 탐색을 누르면 바로 그 두 기간을 대상으로 원인 분석을 실행한다.
- 가장 큰 상승: 가장 큰 기간별 상승을 같은 방식으로 표시한다.
- 비중이 두드러지는 세그먼트: 측정값에서 차지하는 비율과 행에서 차지하는 비율의 차이가 10%포인트 이상인 세그먼트를 찾는다. 예를 들어 Services가 전체 행의 16%지만
Total Amount의 33%를 차지하는 경우다. 숫자 열이 없으면 전체 행의 절반 이상을 차지하는 세그먼트를 표시한다. - 특이값: 주요 숫자 열에서 제3사분위수(Q3)에 사분위 범위(IQR)의 3배를 더한 값보다 큰 값이 전체 행의 5% 미만일 때 표시한다.
- 전체 추세: 첫 기간과 마지막 기간의 차이가 5% 이상일 때 표시한다.
- 결측 데이터: 비어 있는 값이 20% 이상인 열을 표시한다.
주요 측정값은 이름이 금액을 나타내는 첫 번째 숫자 열(amount, revenue, sales, price, cost, profit 등)이다. 그런 열이 없으면 첫 번째 숫자 열을 사용한다. 숫자 열이 없으면 인사이트는 행 수를 센다. 마지막 달이 중간까지만 기록된 경우 하락 탐지에서 제외해 미완성 달이 가짜 급락으로 표시되지 않게 한다. 인사이트는 로컬에서 계산하므로 API를 호출하지 않는다. 탐색 링크를 눌렀을 때 API 키가 설정돼 있으면 설명을 위해 Claude를 사용한다. 인사이트는 PDF 보고서에도 포함된다.
DataChat은 언어 모델에 산술 계산을 맡기지 않는 구조를 택했다. 먼저 Claude가 질문과 표의 간단한 스키마를 읽고 작은 JSON 분석 계획을 만든다. 앱은 필터링, 그룹화, 집계, 비교를 전체 데이터에 직접 적용하고, Claude는 계산 결과 표를 바탕으로 자연어 설명을 작성한다. 차트는 앱이 그린다. 제작자는 모든 수치가 모델의 추정이 아니라 전체 행을 처리하는 Java 코드에서 나온다고 설명한다. Claude에는 원본 행이 아니라 스키마와 작은 집계 결과만 전달하며, How it was computed 탭에서 실행한 계획을 확인할 수 있다. API 호출이 실패하면 앱은 오프라인 엔진으로 전환하고 이를 알린다.
Claude에 보내는 계획 요청에는 표 이름과 행 수, 열마다 NUMBER, DATE, TEXT로 표시한 유형이 포함된다. 열별로 숫자의 최솟값·최댓값·평균, 날짜 범위, 또는 텍스트 열의 고유값(최대 25개, 그보다 많으면 일부 예시)도 전달한다. Send sample rows to AI를 선택한 경우에만 첫 세 행을 추가로 보낸다. 최근 세 번의 질문·계획 쌍과 오늘 날짜도 포함된다. 설명 요청에는 질문, 실행한 계획, 계산된 사실과 결과 표의 최대 첫 30행이 들어간다. 두 요청 모두 Java 기본 HttpClient로 https://api.anthropic.com/v1/messages에 보낸다.
분석 계획과 변화 요인
Claude 또는 오프라인 계획기가 JSON 객체 하나를 만들고 엔진이 이를 실행한다. 저장소에 실린 계획 예시는 다음과 같다.
{
 "intent": "aggregate",
 "title": "Total Amount by month and Category",
 "metric": "Amount",
 "agg": "sum",
 "x": "Date",
 "bucket": "month",
 "series": "Category",
 "filters": [{ "column": "Status", "op": "!=", "value": "Refunded" }],
 "sort": "none",
 "limit": null,
 "chart": "line"
}
intent는 그룹화·차트 작성을 위한 aggregate, 변화 설명을 위한 drivers, 개별 행 목록을 위한 rows, 열 개요를 위한 describe 중 하나다. metric은 측정할 숫자 열이며, null이면 행을 센다. agg는 sum, avg, count, min, max, median 중 하나다. x는 x축 또는 그룹화에 사용할 열이고, null이면 전체 값 하나를 계산한다. 날짜 열의 bucket은 day, weekday, week, month, quarter, year이며 지정하지 않으면 날짜 범위에 따라 자동 선택한다. series는 색을 나눌 두 번째 그룹화 열로 최대 8개 시리즈를 지원한다.
filters에는 column, op, value를 지정한다. op은 =, !=, >, <, >=, <=, contains, in, not in을 지원하며 날짜 필터에는 2026-03 같은 일부 ISO 날짜를 쓸 수 있다. sort와 limit은 정렬 및 상위 N개 표시를 정한다. 범주는 기본적으로 값이 큰 순서로 정렬하고, 범주가 많으면 20개로 제한한다. chart는 bar, line, pie, none을 지정하며 생략하면 자동 선택한다. drivers에는 비교할 기간을 나타내는 from과 to(예: 2026-02, 2026-03), 그리고 drop 또는 rise를 지정하는 direction이 쓰인다.
차트 유형을 자동 선택할 때 x축이 시간이라면 선 차트를 사용하고, 점이 아주 적으면 막대 차트를 쓴다. 범주형 데이터에는 막대 차트를 사용하며 범주가 많거나 라벨이 길면 가로 막대로 표시한다. 원형 차트는 요청된 경우에만 사용하며 양수 조각이 10개 이하여야 한다. 계획의 열 이름이 정확히 일치하지 않으면 엔진은 대소문자를 무시한 일치와 유사 문자열 일치를 시도하고, 그래도 찾지 못하면 사용 가능한 열을 알린다.
“3월 하락의 원인은 무엇인가?” 같은 질문에서 엔진은 우선 데이터를 기간별로 묶고 측정값을 합산한다. 기본 기간 단위는 월이다. 비교 기간을 하나만 지정하면 그 직전 기간과 비교한다. 기간을 지정하지 않으면 기간별 최대 하락 또는 상승을 찾는다. 그런 다음 고유값이 2~40개인 각 텍스트 열에서 두 기간의 세그먼트별 값을 계산한다. 세그먼트가 전체 추세를 그대로 따랐다면 나타났을 움직임과 실제 움직임의 차이를 기준으로 순위를 정한다. 이에 따라 데이터 대부분을 차지하는 Status = Completed처럼 규모가 크지만 안정적인 세그먼트가 단지 크다는 이유만으로 상위에 오르는 것을 막는다.
엔진은 Region = North & Category = Hardware 같은 두 열 조합도 살펴본다. 두 부분 각각보다 적어도 10%포인트 더 뚜렷하게 움직인 조합만 남긴다. 전체 추세를 밑돌거나 반대 방향으로 움직인 세그먼트를 보고하고, 변화량을 행 수 변화와 행당 평균값 변화로 나눈다. 결과에는 두 기간을 강조한 추세 차트와 세그먼트별 변화를 보여주는 가로 막대 차트가 포함된다. 막대는 상승을 초록색, 하락을 빨간색으로 표시한다. 표에는 세그먼트별 변화량과 변화율, 전체 변화에서 차지하는 비율이 나온다. 비율은 각 차원 안에서 따로 계산하므로 서로 다른 차원 사이에서는 겹칠 수 있다. 데이터의 마지막 기간이 월 중간에 끝나면 결과가 미완성일 수 있다는 경고를 표시한다.
개인정보와 오프라인 사용
CSV는 로컬에서 읽고 처리한다. 집계, 필터링, 차트 작성은 모두 사용자의 컴퓨터에서 Java로 수행한다. Claude에는 스키마 요약과 집계 결과 표(최대 30행)만 전달하며, Send sample rows to AI를 선택한 경우에만 데이터의 첫 세 행도 보낸다. 텍스트 열 요약에는 열마다 최대 25개의 고유값이 포함되므로 값이 민감한 열이 있다면 Claude를 사용하지 않거나 오프라인 모드를 선택해야 한다. 오프라인 모드에서는 어떤 데이터도 기기 밖으로 전송되지 않는다.
API 키가 없거나 오프라인 모드를 선택하면 내장 규칙 기반 계획기가 질문을 같은 JSON 계획으로 바꾼다. 질문에 적힌 열 이름과 average, median, max, min, how many, count 같은 말에서 측정값을 찾는다. 측정값을 지정하지 않으면 금액처럼 보이는 숫자 열을 선택하고 그 사실을 알린다. by, per, each, across, 열 이름과 복수형, monthly, per week, over time, trend, weekday 같은 시간 표현을 그룹화에 활용한다. 질문에 나온 North, Hardware 같은 범주값, excluding refunded, without retail 같은 제외 조건, in March, Q2, 2026 같은 날짜도 필터링에 사용한다. top 5, bottom 3, lowest, best 같은 순위 표현과 pie·line·bar 차트 지정도 처리한다. drop, fell, decline, rise, why, driving, compare X and Y 같은 표현은 변화 분석에 쓰인다.
저장소는 이 엔진이 데이터 탐색과 데모에 적합하다고 설명한다. 키워드 기반이므로 드문 표현이나 앞선 질문을 이어가는 대화는 Claude를 켰을 때 더 잘 처리된다. 오프라인 엔진은 이전 질문에 의존하는 후속 질문을 해결하지 못한다.
파일 처리와 내보내기
CSV 구분자는 쉼표, 세미콜론, 탭, 파이프 중에서 자동 감지한다. 따옴표로 묶인 필드와 이스케이프된 따옴표를 지원한다. UTF-8을 사용하며 BOM을 처리하고, 유효하지 않은 바이트가 있으면 Windows-1252로 대체한다. 숫자를 읽을 때 통화 기호와 천 단위 구분자, 퍼센트 기호를 제거한다. 예를 들어 $1,200.50, £99, 12%를 처리하며 (20)은 -20으로 읽는다.
유럽식 숫자 표기법은 열마다 판별한다. 1.234,56, 12,5, 1 234,5 €, (300,40)을 읽을 수 있다. 1.234.567,89나 12,5는 유럽식 표기의 근거로, 1,234.56이나 1,234,567은 미국식 표기의 근거로 사용한다. 단독으로는 어느 쪽인지 모호한 1,234나 1.200은 나머지 열과 파일의 표기를 따른다. 다른 근거가 전혀 없으면 미국식으로 처리한다. 01.03.2026 같은 점으로 구분한 날짜는 숫자가 아니라 날짜로 인식한다. 모호한 열을 잘못 읽었다면 1.200,00처럼 명확한 값 하나를 넣거나 파일 형식을 다시 지정해야 한다.
날짜는 yyyy-MM-dd, yyyy-MM, yyyy/MM/dd, d/M/yyyy, M/d/yyyy, d-M-yyyy, d.M.yyyy, d MMM yyyy, MMM d, yyyy 형식을 자동으로 감지한다. d/M/yyyy에서는 월보다 일을 먼저 해석한다. 시간 부분은 무시한다. 비어 있지 않은 값의 95% 이상을 해석할 수 있으면 열 유형을 NUMBER 또는 DATE로 판정한다. Customer ID, OrderID, zip, phone처럼 ID로 보이는 열은 합계에 포함되지 않도록 텍스트로 유지한다. 헤더가 비어 있으면 Column N으로 이름을 붙이고, 중복 헤더에는 숫자 접미사를 추가한다.
질문 이력을 포함한 현재 세션의 내용을 하나의 A4 문서로 저장하려면 도구 모음의 Export PDF report...를 누른다. 질문을 한 번 이상 해야 버튼이 활성화된다. 보고서에는 데이터셋 이름, 행·열 수, 날짜, 열 목록이 있는 제목 영역과 파일을 불러올 때 찾은 주요 인사이트가 들어간다. 각 질문에 대해 질문, 자연어 답변, 사용한 행 수와 적용 필터, 차트, 결과 표의 첫 25행도 순서대로 포함한다.
새 파일을 불러오면 새 세션이 시작되므로 보고서는 현재 데이터셋만 다룬다. 차트는 이미지로 삽입하고 표는 선택 가능한 텍스트로 저장한다. 긴 표는 페이지에 걸쳐 이어지며 헤더를 반복한다. PDF 작성 기능은 프로그램에 내장돼 있고 별도 PDF 라이브러리를 사용하지 않는다. 표준 Helvetica 글꼴을 사용하므로 서유럽 문자 이외의 문자(중국어, 키릴 문자, 아랍어 등)는 ?로 표시된다. 답변의 전체 표를 저장하려면 Save result as CSV...를 사용한다.
최신 답변의 표는 Result table 탭에서 Save result as CSV...를 눌러 저장한다. 질문을 한 번 이상 해야 버튼이 활성화된다. 파일 이름은 답변 제목에서 제안한다. 숫자는 +12,503.58이 아니라 12503.58처럼 일반 값으로 저장해 Excel, Numbers, Google Sheets에서 열기 쉽게 한다. -59.4% 같은 백분율 열은 텍스트로 유지한다. 파일은 UTF-8 BOM을 포함하므로 Excel에서 비ASCII 문자를 올바르게 표시할 수 있고, 쉼표·따옴표·줄바꿈이 들어간 필드는 따옴표로 묶는다. 차트는 CSV에 포함되지 않으므로 Save chart as PNG...로 별도 저장해야 한다.
제약과 문제 해결
데이터는 메모리에 보관되므로 수백만 행에 이르는 매우 큰 파일에는 더 큰 힙이 필요하다. 저장소는 java -Xmx4g ...를 예로 든다. 한 번에 하나의 표만 처리하며 여러 파일을 조인할 수 없다. 모호한 날짜는 일을 먼저 해석한다. 예를 들어 03/04/2026처럼 일이 12 이하인 값은 일·월 순서로 본다. 파일 안의 다른 근거가 없고 열의 숫자가 모두 1,234 또는 1.200처럼 모호하면 미국식 숫자로 읽는다.
누적 차트와 여러 y축은 지원하지 않는다. 다중 시리즈 데이터는 그룹 막대 또는 여러 선으로 그린다. 변화 원인 분석은 텍스트 열(열마다 고유값 최대 40개)과 고유값이 최대 12개인 열의 2개 조합을 살펴본다. 숫자 열은 분석 차원으로 사용하지 않는다. PDF 보고서는 내장 글꼴로 서유럽 문자만 지원한다. 언어 모델이 질문을 잘못 해석할 수 있으므로 답변이 이상하면 How it was computed 탭을 확인해야 한다.
상태 표시줄에 오프라인 엔진이 표시되면 API 키가 입력되지 않았거나 Offline mode가 켜진 것이다. Claude 계획을 사용할 수 없다는 알림은 잘못된 키나 모델 이름, 네트워크 문제 같은 API 오류 또는 유효하지 않은 계획을 뜻한다. 알림에는 HTTP 오류가 포함되며 답변은 오프라인 엔진에서 나온다. I couldn't find a column called ...라는 메시지가 나오면 계획이 존재하지 않는 열을 참조한 것이므로 채팅에 표시된 열 이름을 사용해 질문을 바꾼다. ... isn't numeric은 텍스트나 날짜 열을 합산·평균 내려고 했다는 뜻이므로 숫자 열을 사용하거나 개수를 센다.
날짜가 인식되지 않으면 Your data 탭과 “Describe this data” 답변에서 감지된 유형을 확인하고 열을 yyyy-MM-dd로 바꾼다. 문자가 깨지면 파일을 UTF-8로 다시 저장한다. 메모리가 부족하면 더 큰 힙을 지정해 실행한다.
java -Xmx4g DataChat.java
숫자가 1,000배 작거나 크게 읽히면 1.200 또는 1,234 열이 잘못된 표기로 판정됐을 수 있다. CSV 처리 설명에 따라 확인한다. 자동 인사이트가 나타나지 않으면 데이터가 기준값을 넘지 않았거나(예: 시간 구간이 3개 미만), 날짜·숫자 열이 없는 경우일 수 있다. 평소처럼 질문하면 된다. PDF에 ?가 표시되면 해당 문자가 내장 PDF 글꼴이 지원하지 않는 서유럽 문자 밖의 문자다.
코드 구성과 확장
모든 코드는 DataChat.java에 있으며 중첩 클래스로 구성된다. DataChat은 도구 모음, 채팅 기록, 탭, 드래그 앤 드롭, 백그라운드 SwingWorker 작업을 맡는 Swing UI다. DataTable과 Column은 메모리 내 표, CSV 파싱, NUMBER·DATE·TEXT 유형 판별, 모델용 스키마 설명을 담당한다. Plan과 Filter는 JSON 변환을 포함한 분석 계획을 나타낸다. Engine은 필터링, 그룹화, 집계, 변화 원인 분석, 사실 생성을 실행한다. Result와 ChartData는 엔진의 표 행, 차트 사양, 자연어 사실을 담는다. LocalPlanner는 오프라인 자연어 질문을 계획으로 바꾸고 오프라인 답변을 작성한다. Claude는 Anthropic Messages API 클라이언트와 계획·설명용 시스템 프롬프트를 포함한다. Json은 라이브러리 없이 JSON을 읽고 쓴다. ChartPanel은 도구 설명을 포함한 막대·가로 막대·선·원형 차트를 Java2D로 그리며 PDF용 차트 렌더링에도 쓰인다. Insights와 Insight는 파일을 불러올 때 가장 큰 하락·상승, 비중이 두드러지는 세그먼트, 특이값, 추세, 결측 데이터를 검사하고 탐색 링크에 연결할 계획을 만든다. Pdf와 ReportBuilder는 텍스트, 선, JPEG 이미지, Flate 압축 페이지를 지원하는 간단한 PDF 1.4 작성기와 보고서 레이아웃을 담당한다. DemoData는 합성 거래 데이터와 예시 질문을 생성한다.
기능을 확장할 때는 새 집계를 Acc.get, Engine.aggOf, measureLabel에 추가하고 Claude.PLAN_SYSTEM에도 적어야 한다. 새 시간 단위는 Engine.bucketLabel에 사례를 추가하고 Engine.bucketOf의 허용 목록을 고친다. 새 차트 유형은 ChartType과 ChartPanel의 그리기 메서드, Engine.chartType의 규칙에 반영한다. 새 인사이트는 Insights에 Insight(headline, plan)을 만드는 메서드를 추가하고 Insights.generate에서 호출한다. 탐색을 누르면 이 계획은 일반 엔진을 통해 실행된다. 보고서 레이아웃은 ReportBuilder.build에서 수정하며, Pdf 도우미에는 para, table, image, rule과 자동 페이지 나누기가 있다. 다른 모델을 쓰려면 Model 입력란을 바꾸거나 ANTHROPIC_MODEL을 설정한다. 자체 데모 데이터는 DemoData.create()와 DemoData.examplesFor()를 수정한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요