!원문 캡처 · swapniltalekar.substack.com
Jev가 응답을 생성하는 대신 선택·점수·예/아니요와 신뢰도를 내놓는 ‘의사결정 모델’ 범주를 선보인 지 2주 만에 Amazon, OpenAI, Cloudflare 등이 경쟁 제품을 내놨다. 모델이 빠르게 늘어나는 만큼, 실제 도입을 검토하는 팀은 특정 모델의 순위보다 입력 데이터와 지연 시간, 정확도, 비용, 운영 조건을 따져야 한다.
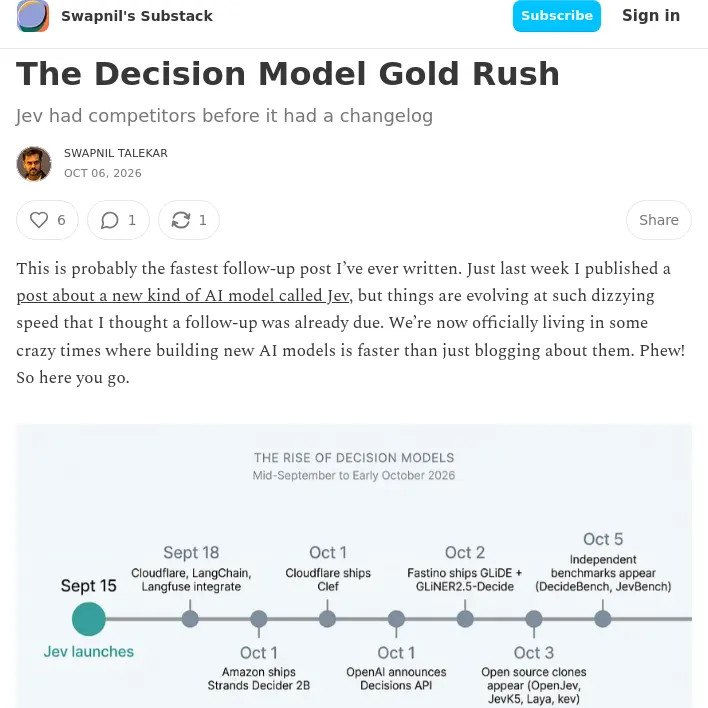
Jev를 만든 TypeSafe는 9월 15일 제품을 출시했다. 같은 주 2억 달러 기업가치로 4,000만 달러 시드 투자를 유치했고, 14만 명의 대기자 명단을 36시간 만에 처리했다. 하루 만에 Vercel 유료 AI Gateway 고객의 13%가 Jev를 워크플로에 연결했고, 사흘 안에 Cloudflare, LangChain, Langfuse가 연동 기능을 내놨다.
하지만 경쟁 제품도 곧 등장했다. 10월 1일까지 Amazon은 Qwen3.5-2B 기반 오픈소스 모델 Strands Decider 2B를 출시했고, OpenAI는 GPT-6 Luna 기반 Decisions API를 발표했다. Decisions API는 Jev와 달리 이미지를 입력으로 받을 수 있다. Cloudflare의 Clef는 Jev API를 대체할 수 있는 오픈 가중치 모델로 공개됐으며, 출시 당일 Hacker News에서 465점을 얻고 Jev가 공개한 일부 벤치마크에서 Jev보다 높은 점수를 기록했다. Fastino는 GLiDE와 GLiNER2.5-Decide를 추가했다. GitHub에는 OpenJev, JevK5, von, Laya 등 대체 모델을 표방하는 오픈소스 프로젝트도 올라왔다. TypeSafe의 최고경영자는 경쟁 제품의 잇따른 등장을 “멋진 아키텍처를 구현하고 싶어 하는 ML 사람들”의 움직임이라고 평했다.
이전 글인 Jev와 분류 모델의 귀환 이후 변화가 너무 빨라, 어떤 모델을 쓸지 단정하기보다 실제 도입 때 살펴볼 기준과 주의점을 짚는다.
벤치마크는 비교 조건을 확인해야 한다
Fastino가 GLiDE와 GLiNER2.5-Decide를 Jev와 비교한 결과에서는 Fastino가 테스트와 비교 모델을 직접 선택했다. TypeSafe도 자사 수치가 가장 유리한 조건에 치우칠 수 있다고 밝힌 바 있다.
독립 벤치마크인 DecideBench는 개발자 Cho Yin Yong이 만들었다. 지원 요청 분류, 콘텐츠 조정, 주장 확인, 에이전트 라우팅 등 8개 작업군에서 객관식 의사결정 400건을 평가한다. 이 테스트에서 Jev는 정확도 98%를 기록했고, 작업 100만 건당 비용은 32달러였다. 정확도 95%를 넘긴 모델 가운데 가장 저렴했으며, 정확도만 보면 Jev를 앞선 범용 대규모 언어 모델은 운영 비용이 6~14배 높았다.
반면 Laya를 포함한 소형 인코더 기반 모델은 가장 빠르고 저렴한 선택지였지만 정확도는 35~59%에 그쳤다. 테스트에서는 이미지 입력을 받을 수 있고 직접 호스팅할 수 있는 오픈 모델 Imajev-4B도 확인됐다. 정확도 95%로 평가 대상 가운데 가장 뛰어난 오픈 의사결정 모델로 꼽혔다. 비슷한 시기에 두 번째 독립 벤치마크 JevBench도 등장했다.
도입 전에 따져볼 조건
- 어디에서 실행할지: Jev와 OpenAI Decisions API는 호스팅형이다. Clef, Strands Decider 2B, GLiNER2.5-Decide, Imajev-4B와 다른 오픈소스 모델은 직접 호스팅하거나 엣지에서 실행할 수 있다. 민감한 데이터를 주요 AI 기업에 보내기 어렵다면 자체 호스팅이 대안이 될 수 있다.
- 어떤 입력을 처리할지: Jev는 텍스트, 문자열, JSON, 문자열 배열을 받는다. Decisions API와 Imajev-4B는 이미지도 처리한다. 스크린샷, 스캔 문서, 파손된 제품 사진처럼 시각 정보의 라우팅이나 점수화가 필요하다면 이미지 입력 지원 여부가 선택 기준이다.
- 결과가 얼마나 빨리 필요한지: Jev가 내세우는 지연 시간은 70~500밀리초다. GLiNER2.5-Decide는 GPU에서 38밀리초, Laya는 질문당 약 33밀리초라고 밝힌다. 지원 티켓 분류에서는 70밀리초와 500밀리초의 차이가 크지 않을 수 있지만, 실시간 게임이나 거래 시스템에서는 지연 시간이 중요하다. 이때는 속도와 정확도의 균형을 봐야 한다.
- 자체 데이터에서도 신뢰도가 맞는지: 모델이 보고하는 신뢰도가 실제 데이터에서도 유효한지 확인해야 한다. 과거 결정 사례 수백 건을 뽑아 모델의 신뢰도 구간을 10%포인트 단위로 나누고, 각 구간에서 실제 적중률을 비교하는 방법이 제시된다. 모델이 90% 신뢰도를 보고한 사례들의 실제 적중률이 65%라면 다른 모델을 검토할 이유가 된다.
- 실제 처리량에서 비용이 얼마인지: Jev의 가격은 입력 토큰 100만 개당 0.042달러이며 출력은 무료다. 하루 결정 건수가 많으면 총비용이 달라진다. 대량 처리에서는 오픈 가중치 모델의 자체 호스팅을 고려할 수 있지만, API 비용이 컴퓨팅 자원과 유지관리 비용으로 바뀌는 것이므로 항상 더 저렴한 것은 아니다.
- 나중에 교체하기 쉬운지: Cloudflare는 고객이 Jev와 Clef를 쉽게 바꿔 비교하도록 Clef를 Jev API의 대체품으로 만들었다. 다른 모델은 API가 호환되지 않는 경우가 많아 교체에 추가 작업이 들 수 있다.
작업에 따라 우선순위가 달라진다
하루 수천 건의 지원 티켓을 결제, 기술 문제, 이탈 위험으로 분류하는 경우를 보자. 잘못 분류해도 담당자가 1~2분이면 바로잡을 수 있으므로, 정확도를 마지막 몇 퍼센트포인트까지 끌어올리기보다 작업당 비용과 지연 시간이 중요할 수 있다. 이 조건에서는 DecideBench에서 정확도 98%, 작업 100만 건당 32달러를 기록한 Jev가 기본 선택지가 될 수 있다. 이미 AWS를 폭넓게 사용하고 자체 호스팅으로 비용을 낮추려는 팀이라면 Strands Decider 2B도 검토할 만하다. 오분류의 영향이 작기 때문에 신뢰도 보정의 중요성도 상대적으로 낮다.
반면 실시간 게임이나 거래 시스템에서 에이전트가 다음에 실행할 도구를 고른다면 수백 밀리초의 지연이 큰 비용으로 이어질 수 있다. 이 경우 GLiNER2.5-Decide의 GPU 기준 38밀리초와 Laya의 약 33밀리초는 매력적이지만, 인코더 모델의 DecideBench 정확도가 35~59%라는 점도 함께 고려해야 한다. 빠르더라도 결정이 세 번 중 한 번꼴로 틀리면 유용성이 떨어질 수 있다. 지연 시간 제한이 매우 엄격하다면 Jev가 내세우는 70밀리초가 실제 환경에서 충분한지 시험하고, 그렇지 않으면 정확도가 낮은 모델을 고려할 수 있다고 설명한다.
2026년 10월 첫째 주의 제품 현황은 한 달 뒤면 낡을 수 있다. 이 범주가 Jev처럼 도구 연동을 먼저 확보한 모델을 중심으로 통합될지, 아니면 저렴한 오픈 가중치 모델은 대량 분류에, 설명 기능이 필요한 작업은 호스팅 API에 쓰이는 식으로 용도별 분화가 이어질지는 아직 단정하기 어렵다. 다만 입력 유형, 실행 위치, 지연 시간, 데이터별 신뢰도, 총비용, 교체 난이도는 모델이 바뀌어도 도입 시 확인할 기준으로 제시된다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요