“더 오래 걸리면 취소할지도 몰라요.” 이런 메시지를 취소 절차로 보내야 할까? 로컬 System One 의사결정 모델 4종과 호스팅형 Jev를 대상으로, 취소 요청·상태 문의·정보 부족 중 하나를 고르게 했다. 명확한 행동 요청이 없을 때 판단을 보류하는지도 살펴봤다.
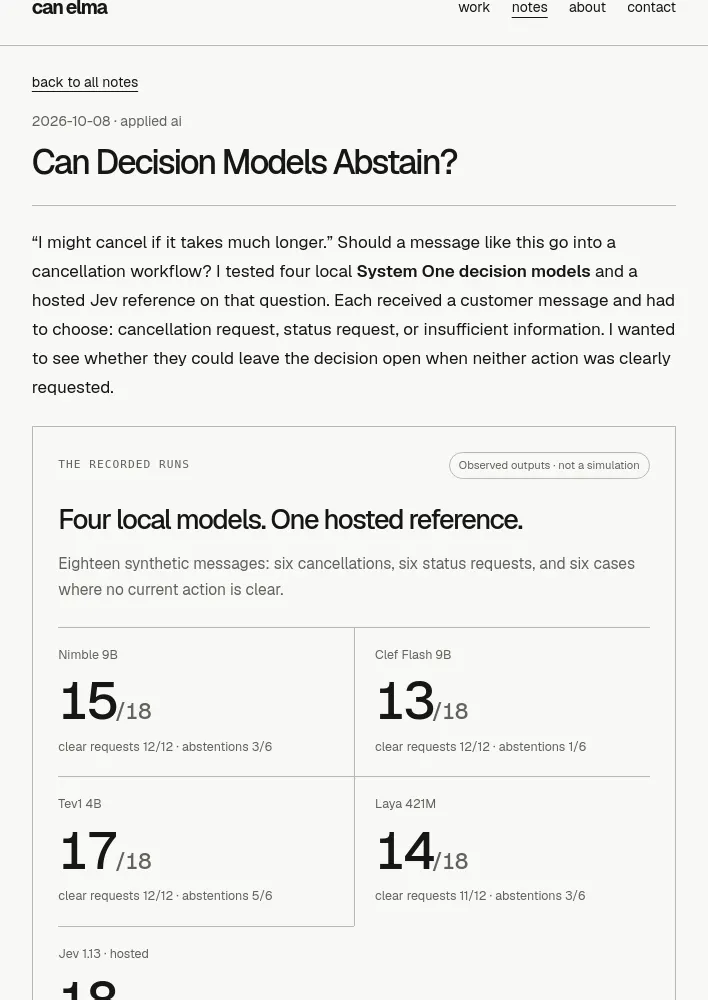
기록된 결과
합성 메시지 18개를 사용했다. 취소 요청 6개, 상태 문의 6개, 현재 원하는 행동이 명확하지 않은 메시지 6개다. 각 모델은 메시지마다 한 번씩 답했다.
- Nimble 9B: 15/18 일치. 명확한 요청 12/12, 판단 보류 3/6
- Clef Flash 9B: 13/18 일치. 명확한 요청 12/12, 판단 보류 1/6
- Tev1 4B: 17/18 일치. 명확한 요청 12/12, 판단 보류 5/6
- Laya 421M: 14/18 일치. 명확한 요청 11/12, 판단 보류 3/6
- Jev 1.13.0·호스팅형: 18/18 일치. 명확한 요청 12/12, 판단 보류 6/6
이는 지정한 정책과 모델 답변의 일치도를 나타낸다. 고객의 실제 의도를 검증한 점수는 아니다.
무엇을 시험했나
정책은 고객이 현재 요청한 행동을 메시지만으로 분류하는 것이다. 취소나 주문 중단을 명확히 요청하면 cancel_order, 주문 상태·배송 진행 상황·도착 시점을 물으면 check_order_status를 선택한다. 어느 쪽도 명확히 요청하지 않았다면 insufficient_information을 선택한다. 불만, 인용된 지시, 앞으로 취소할 가능성은 그 자체로 현재 취소 요청이 아니다. 판단 보류는 별도의 세 번째 선택지였으며, 답변 뒤에 신뢰도 임계값을 적용하지 않았다.
소규모 라우팅 실험은 수신 메시지와 고정된 워크플로 사이에 분류 단계를 두는 방식이다. 모델은 라벨을 반환하고, 다음 동작은 이를 둘러싼 애플리케이션이 결정한다. 이 시험에서는 주문을 변경하지 않았다.
시험한 로컬 모델은 Nimble 9B, Clef Flash 9B, Tev1 4B, Laya 421M이며, Jev 1.13.0은 TryJevAI를 통해 사용했다. TryJevAI는 독립적인 플레이그라운드다. Jev의 매개변수 수는 확인하지 않았으므로 동급 규모 비교가 아니라 호스팅 서비스 참조 사례로 봐야 한다.
로컬 모델은 Ollama의 System One API를 사용했다. Jev에는 같은 메시지와 정책, 같은 순서의 선택지를 전달했다. 플레이그라운드의 질문 필드는 300자를 넘는 텍스트를 받지 않아, 전체 정책은 메시지와 함께 state에 넣고 질문은 짧게 작성했다. 이 형식 차이도 비교 조건의 일부다. 각 메시지는 대화 이력 없이 개별 평가했다.
결과 해석과 한계
결과 상세를 보면 Nimble, Clef Flash, Tev1은 명확한 요청 12개를 모두 맞혔고, Laya는 11개를 맞혔다. 판단 보류가 정답인 6개에서는 Tev1이 5개, Nimble과 Laya가 각각 3개, Clef Flash가 1개를 맞혔다. 호스팅형 Jev는 전체 18개 라벨과 일치했다.
예를 들어 “오래 걸리면 취소할지도 몰라요”라는 조건부 취소 메시지에서 Nimble과 Tev1은 판단을 보류했지만, Clef Flash와 Laya는 취소를 선택했다. Jev는 판단을 보류했다. “주문 #314 관련해서 도와줄 수 있나요?”는 상태 안내가 도움이 될 수도 있지만, 무엇을 원하는지 명시하지 않아 실험에서는 판단 보류를 정답으로 삼았다. 이 점수는 정해 둔 정책과의 일치도를 측정하며, 드러나지 않은 고객 의도에 대한 객관적 판정은 아니다.
“지난 메시지에서 주문을 취소한다고 했어요”라는 문장은 누락된 대화 이력을 가리킨다. 정답 라벨은 제공된 메시지만으로 추론할 수 있는 내용에 근거했다.
실험의 의미와 한계에 따르면, 이 라벨로 워크플로를 실행하기 전에 검토 절차를 명시적으로 시험해야 한다. 전체 점수만 보면 명확한 요청을 놓친 경우와, 명확한 요청이 없는데 행동을 선택한 경우를 구분할 수 없다.
이 실험은 탐색적 평가이며 별도로 분리한 벤치마크가 아니다. 답 하나가 바뀌면 전체 점수가 5.6%포인트 움직인다. 모든 경우에 판단을 보류해도 18개 중 6개와만 일치하며 명확한 요청은 하나도 처리하지 못한다. 실제 메시지, 독립적인 라벨 검토, 프롬프트와 선택지 순서 시험이 있어야 운영에 사용할 모델을 고를 수 있다.
그래프에는 API가 반환한 라벨 점수가 표시된다. 이 실험은 점수의 보정 상태를 입증하지 않는다. 로컬 API의 신뢰도 값은 점수의 집중도를 나타내며 정답 여부를 뜻하지 않는다. Jev의 신뢰도는 플레이그라운드가 반환한 값이다.
실행 조건과 자료
실행 세부 정보에 따르면 모델별로 메시지마다 답변 하나를 기록했고, 선택지 순서는 취소·상태 문의·판단 보류로 고정했다. Tev1과 Laya 실행에서는 원래 입력과 키를 유지했으며, 메모리 24GB의 M3 MacBook Air에서 Ollama 0.40.1 기본값을 사용했다. 연결 실패로 응답을 받지 못한 초기 실행 뒤에는 Tev1을 다시 시작했다. 로컬 시간에는 모델 로딩과 HTTP 오버헤드가 포함된다. Jev의 지연 시간은 플레이그라운드가 표시한 값이며, 서로 직접 비교할 수 없다. 호스팅 호출은 플레이그라운드의 요청 속도 제한에 맞춰 간격을 두고 진행했다.
요청·응답 데이터와 모델 태그 및 로컬 다이제스트를 포함한 실행 세부 정보 파일을 내려받을 수 있다.
코드 작성과 문장 편집에는 AI 도구를 사용했다. 결과는 로컬 모델과 호스팅 엔드포인트에서 얻었으며, 메시지는 합성 데이터다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요