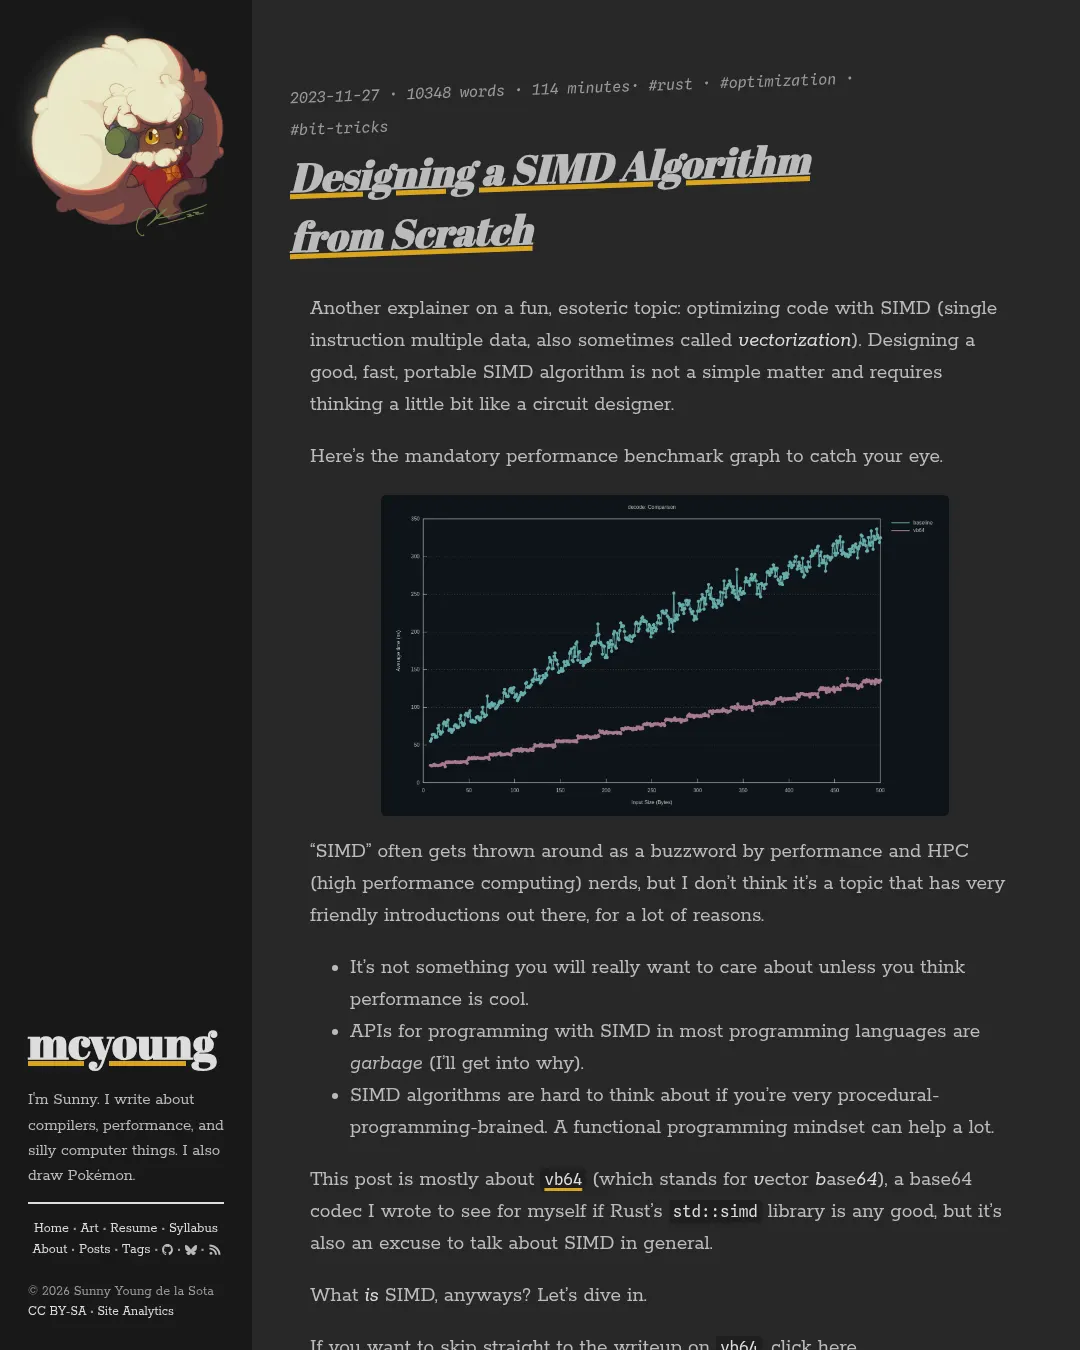
SIMD(단일 명령어 다중 데이터)로 Base64 디코더를 만드는 과정을 단계별로 설명한 글이다. Rust의 std::simd로 만든 vb64를 crates.io의 기준 구현과 비교했으며, -Zbuild-std, -Ctarget-cpu=native로 컴파일하고 SIMD 레인 수를 32로 조정한 벤치마크에서 대부분의 입력 길이에 걸쳐 약 두 배 빠른 결과를 얻었다고 소개한다. 이는 특정 구현과 컴파일 조건에서 나온 결과이며, Base64 디코딩이 실제로 병목인 경우는 거의 없다고 글은 덧붙인다.
SIMD 알고리즘을 생각하는 방식
SIMD는 하나의 명령으로 여러 데이터 레인(lane)에 같은 연산을 수행하는 방식이다. 글은 이를 데이터 묶음 처리에 비유한다. CPU가 분기나 메모리 접근을 기다리며 멈추는 시간을 줄이려면 입력에 따라 실행 경로가 달라지는 코드를 줄이고, 여러 값을 한꺼번에 처리하도록 설계해야 한다. 이를 위해서는 절차를 한 줄씩 따라가기보다 데이터를 나누고 다시 조합하는 방식으로 생각하는 편이 유용하다고 설명한다.
정수의 1 비트 개수를 세는 popcnt 예제에서는 비트를 하나씩 더하는 대신 인접한 비트부터 쌍으로 묶어 합산하고, 다시 합친다. 이 분할 정복 방식은 비트 수에 대해 로그 수준의 합산 단계로 처리할 수 있다. SIMD 프로그래밍에서도 벡터를 여러 크기의 데이터 묶음으로 재해석하고, 셔플로 각 값을 필요한 위치에 옮기는 일이 핵심이다.
SIMD 명령어의 지원 범위와 성능은 대상 아키텍처와 활성화된 기능에 따라 달라진다. 예를 들어 x86의 AVX2는 256비트 ymm 벡터를 제공하며, 컴파일러는 +avx2가 활성화됐을 때 해당 레지스터를 쓰는 코드를 생성한다. -march=native나 -Ctarget-cpu=native는 빌드한 컴퓨터에 맞는 코드를 만들 수 있지만 다른 프로세서와의 호환성을 보장하지 않는다. 실행 중 CPU 기능을 확인해 구현을 고르는 방법도 있지만, 이를 올바르게 구현하는 일은 어렵다고 설명한다. C++의 인트린식은 명령어 집합별 저수준 연산을 직접 표현해야 하므로 여러 대상에 맞춰 코드를 반복 작성하기 쉽다. 이 글은 컴파일러가 많은 명령어 선택을 처리하는 Rust의 이식 가능한 SIMD 라이브러리를 시험한다.
Base64 디코딩을 벡터화하는 과정
Base64는 임의의 바이너리 데이터를 ASCII 문자로 표현한다. 입력의 비트를 6비트 단위인 셉텟(sextet)으로 나누고, 0~25는 A~Z, 26~51은 a~z, 52~61은 0~9, 62는 +, 63은 /에 대응시킨다. 글은 입력 길이가 4의 배수가 아닐 수 있고, 패딩 =이 올바르지 않은 경우도 처리해야 한다고 짚는다. 디코딩된 길이는 입력 길이의 나머지에 따라 계산한다.
일반적인 구현은 문자마다 match로 셉텟을 찾고, 4개씩 모아 최대 3바이트로 변환한다. 이를 SIMD로 바꾸는 첫 목표는 분기 제거다. 글은 특히 입력 바이트마다 실행되는 내부 반복문과 문자별 유효성 검사 분기에 주목한다. 길이 계산에 있던 match는 나머지 길이에 대한 계산식으로 바꿔 분기 없이 처리한다. 내부 루프에서는 네 문자를 한꺼번에 변환하고, 잘린 마지막 입력은 A로 채운다. A는 셉텟 값이 0이므로 이 보충은 값에 영향을 주지 않는다.
문자에서 셉텟을 찾는 방법도 바꾼다. 먼저 문자 범위를 비교해 각 레인의 오프셋을 선택하는 방식을 설명하지만, 비교 연산이 여덟 번 필요하고 여러 값이 동시에 살아 있어 레지스터 압박이 생길 수 있다고 지적한다. 대신 문자 바이트의 상위 4비트와 / 여부를 이용해 범위를 구분하는 완전 해시를 소개한다. 이 해시를 셔플의 인덱스로 사용해 작은 벡터 조회표에서 오프셋을 얻는다. 이 아이디어는 base64simd의 GitHub 이슈에 익명 사용자가 제시한 것이라고 밝힌다. 이 방식은 셉텟 계산만으로 유효성 검사를 해 주지 않으므로, 글에서는 별도의 블룸 필터를 사용한다. 구현은 vb64의 simd.rs에 공개돼 있다.
네 셉텟을 세 바이트로 묶는 과정에서는 비트가 각 출력 바이트의 어느 위치로 이동하는지 확인한다. 단순한 셔플은 바이트 단위로만 값을 옮기므로, 먼저 각 레인을 u16으로 확장해 필요한 만큼 시프트한다. 이어 16비트 값의 낮은 바이트와 높은 바이트를 분리하고, 레인을 회전한 뒤 OR 연산으로 결과를 합친다. 출력 벡터에는 사용하지 않을 여분 레인이 생길 수 있어 셔플로 이를 건너뛴다. 이 처리를 레인 수에 대해 일반화하면 decode_hot이 한 번에 32개의 Base64 입력 바이트를 처리할 수 있다.
바깥쪽 반복문에는 여전히 길이 검사, 메모리 복사, 오류 검사, 메모리 할당이 남는다. 출력 공간을 미리 예약하고 여분 공간도 확보해, 반복마다 벡터 전체를 저장하도록 바꾼다. 마지막에 실제로 디코딩한 길이만 Vec::set_len()으로 확정한다. 유효하지 않은 입력이 발견됐을 때는 즉시 반환하지 않고 오류 여부를 기록한 뒤 반복문이 끝난 후 검사한다. 따라서 오류 분기는 남지만 뜨거운 반복문 밖으로 옮겨진다.
입력 복사에는 chunks_exact()를 이용해 전체 길이의 벡터 청크와 나머지 부분을 나눈다. 전체 청크는 Simd::from_slice()로 불러오고 나머지는 별도로 처리한다. 처음 벤치마크에서는 입력 길이를 32로 나눈 나머지에 따라 성능 그래프가 크게 흔들렸다. Simd::gather_or()를 시도했지만 더 나쁜 어셈블리가 나와 사용하지 않았다. 대신 가능한 곳에서 u128 단위로 읽고, 남은 길이는 겹치는 u64, u32, u8 읽기를 조합하는 로딩 함수를 직접 작성했다. 이 로딩 방식은 Abseil에 기여하면서 익힌 기법이며, 코덱이나 해시 함수처럼 데이터 로딩이 많은 알고리즘에도 유용하다고 설명한다.
이후 같은 벤치마크에서 새 로딩 코드를 적용하자 기준 구현보다 대부분의 구간에서 약 두 배 빠른 결과를 얻었고, 측정 편차도 작았다고 글은 보고한다. 비교 대상은 crates.io의 기준 Base64 구현이며, 측정은 길이가 0부터 약 200~500바이트까지인 메시지를 대상으로 했다. N = 32가 가장 좋은 설정이었다. 이 값은 내부 반복문에서 한 번에 YMM 레지스터 하나를 사용했다. 결과는 -Zbuild-std와 -Ctarget-cpu=native로 컴파일한 조건에 한정된다.
vb64는 인코딩 기능도 제공하지만 웹 안전 Base64는 지원하지 않는다. 웹 안전 형식은 +와 / 대신 -와 _를 쓰며, 이에 맞는 해시를 새로 만들어야 한다. 글은 이 지원을 아직 추가하지 않은 이유가 작업할 기회가 없었기 때문이라고 설명한다. 라이브러리와 구현은 vb64 저장소에서 볼 수 있고, 인코더의 SIMD 구현과 유틸리티 코드도 연결돼 있다.
글의 결론은 성능 수치보다 구현 과정에 있다. Base64 디코딩은 글에서 아는 한 병목이 아니지만, 분기 없는 SIMD 코드를 작성하면 하드웨어와 컴파일러가 무엇을 잘 처리하고 무엇을 자동으로 찾아내지 못하는지 살펴볼 수 있다. std::simd는 전반적으로 좋은 코드를 생성했지만, SIMD 코드 작성을 더 간단하게 만들 개선점도 남아 있다고 평가한다. SIMD는 아키텍처별 명령어와 데이터 배치에 대한 이해가 필요한 복잡한 주제이며, 글은 이 과정을 전체 설명에 풀어 썼다. 이식성과 대상 기능에 관한 주의점은 Dennard scaling 설명, Rust 이슈 118306에서도 확인할 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요