DGX Spark에서 로컬 모델 5종을 각각 5회씩 코드 작성 과제에 투입한 결과, Qwen3.8-27B가 테스트 통과율 28/30으로 가장 안정적이었다. 토큰 생성 속도만으로 모델을 고르면 실제로 쓸 만한 모델을 놓칠 수 있다는 결과다.
테스트 구성과 결과
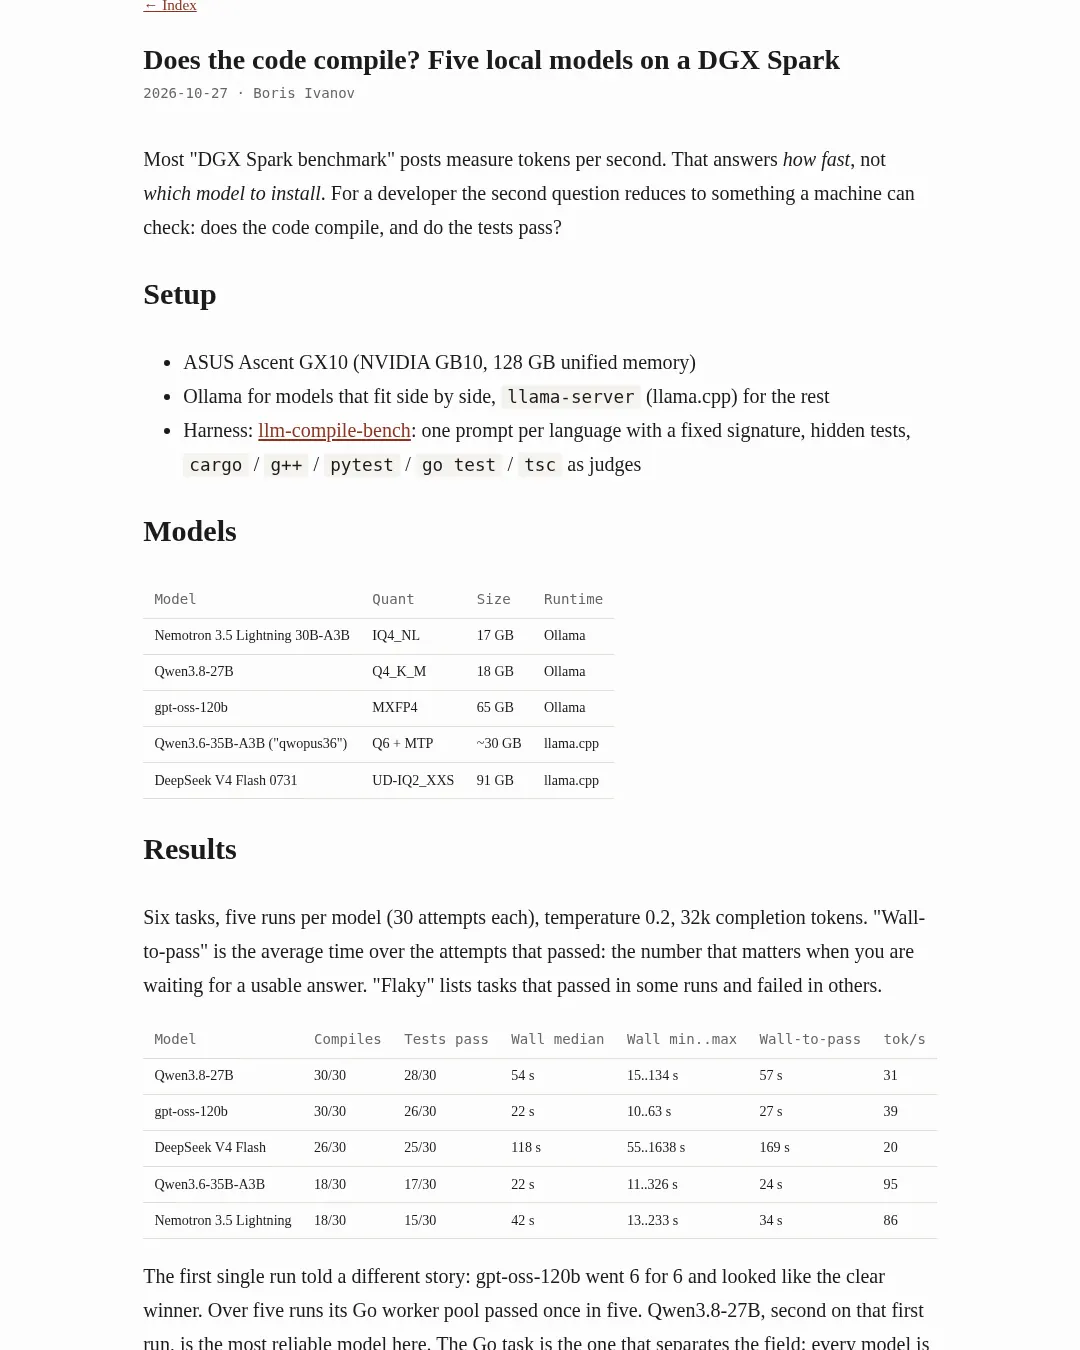
보리스 이바노프(Boris Ivanov)는 ASUS Ascent GX10(NVIDIA GB10, 통합 메모리 128GB)에서 모델을 평가했다. 함께 실행할 수 있는 모델에는 Ollama를, 나머지에는 llama.cpp의 llama-server를 사용했다. 하네스는 llm-compile-bench이며, 언어마다 고정된 시그니처와 숨겨진 테스트를 포함한 프롬프트 하나를 제시하고 cargo, g++, pytest, go test, tsc로 결과를 판정했다.
| 모델 | 양자화 | 크기 | 실행 환경 |
|---|---|---|---|
| Nemotron 3.5 Lightning 30B-A3B | IQ4_NL | 17 GB | Ollama |
| Qwen3.8-27B | Q4_K_M | 18 GB | Ollama |
| gpt-oss-120b | MXFP4 | 65 GB | Ollama |
| Qwen3.6-35B-A3B ("qwopus36") | Q6 + MTP | ~30 GB | llama.cpp |
| DeepSeek V4 Flash 0731 | UD-IQ2_XXS | 91 GB | llama.cpp |
모델마다 과제 6개를 5회씩 실행해 총 30회 시도했다. 온도는 0.2, 완료 토큰 한도는 32k였다. ‘통과까지 걸린 시간’은 통과한 시도들의 평균이며, 사용할 수 있는 답을 기다리는 시간을 나타낸다. ‘실행별 편차’에는 실행에 따라 통과와 실패가 갈린 과제를 적었다.
| 모델 | 컴파일 성공 | 테스트 통과 | 전체 시간 중앙값 | 전체 시간 최솟값..최댓값 | 통과까지 걸린 시간 | 토큰/초 | 실행별 편차가 있는 과제 |
|---|---|---|---|---|---|---|---|
| Qwen3.8-27B | 30/30 | 28/30 | 54 s | 15..134 s | 57 s | 31 | go_worker_pool 4/5, rust_iso8601 4/5 |
| gpt-oss-120b | 30/30 | 26/30 | 22 s | 10..63 s | 27 s | 39 | go_worker_pool 1/5 |
| DeepSeek V4 Flash | 26/30 | 25/30 | 118 s | 55..1638 s | 169 s | 20 | go_worker_pool 3/5, react_counter 4/5, rust_iso8601 3/5 |
| Qwen3.6-35B-A3B | 18/30 | 17/30 | 22 s | 11..326 s | 24 s | 95 | rust_iso8601 2/5 |
| Nemotron 3.5 Lightning | 18/30 | 15/30 | 42 s | 13..233 s | 34 s | 86 | cpp_lru 2/5, go_worker_pool 2/5, ts_debounce 1/5 |
첫 실행만 보면 gpt-oss-120b가 6개 과제를 모두 통과해 확실한 우승 모델처럼 보였다. 하지만 5회 실행에서는 Go 작업자 풀 과제를 5번 중 1번만 통과했다. 첫 실행에서 2위였던 Qwen3.8-27B는 전체 결과에서 가장 안정적이었다. 모든 모델이 Go 과제에서 실행별 편차를 보였으며, 동시성을 다루는 과제는 이 항목 하나뿐이었다.
첫 수동 테스트와 해석
하네스를 만들기 전에는 ISO-8601 날짜를 파싱하는 Rust 함수를 작성하라는 한 줄 프롬프트를 네 모델에 직접 보냈다.
Nemotron 3.5 Lightning 93 tok/s 27 s answered in English, date-only
gpt-oss-120b 44 tok/s 95 s invented "chrono 0.5", missing dep
Qwen3.8-27B 30 tok/s 73 s clean; one missing `use Datelike`
DeepSeek V4 Flash 17 tok/s 659 s best code, 11k tokens of thinking
DeepSeek의 추론을 2048토큰으로 제한하자 속도는 4배 빨라졌지만 답변이 컴파일되지 않았다. 이 테스트에서는 추론이 답변 품질에 기여하는 요소였다고 보리스 이바노프는 설명한다.
토큰 생성 속도 순위는 코드 과제 결과와 맞지 않았다. 가장 빠른 Qwen3.6(초당 95토큰)과 Nemotron(초당 86토큰)은 시도의 절반 정도만 통과했고, 토큰 생성 속도가 가장 느린 두 모델이 가장 높은 신뢰도를 보였다. 따라서 처리량만 측정하면 선택을 잘못할 수 있다는 것이 이 테스트의 결론이다.
이바노프는 품질을 우선할 때 Qwen3.8-27B, 속도와 품질의 균형을 원할 때 gpt-oss-120b를 추천했다. Qwen3.8-27B는 디스크에서 17GB를 차지하면서 30회 중 28회 통과해, 다른 모델을 함께 둘 여지도 남긴다. gpt-oss-120b는 30회 중 26회 통과했고 통과까지 걸린 시간은 27초로 Qwen3.8-27B의 57초보다 약 절반이었다. 다만 이바노프는 Go 동시성 과제가 아니라는 조건에서 gpt-oss를 일상 작업에 계속 로드해 둘 모델로 꼽았다.
DeepSeek V4 Flash는 추론 능력이 가장 뛰어나지만 일상적으로 쓰기에는 가장 불편한 모델로 평가됐다. 다른 모델이 풀지 못하는 문제를 해결하지만 대기 시간이 5~10배 길고, 같은 프롬프트의 실행 시간도 55초에서 27분까지 벌어졌다. 추론을 제한하면 빨라지지만 답이 틀렸다는 결과도 나왔다.
소형 MoE 모델은 특히 Rust와 Go에서 실패했다. Python, TypeScript, React 과제는 대체로 통과했지만 타입 시스템과 동시성 모델을 다룰 때 차이가 드러났다.
이바노프는 첫 실행에서 발생한 실패의 절반은 모델이 아니라 테스트 환경 문제였다고 밝혔다. 장비에 도구 체인이 없어 Rust·Go·TypeScript 과제가 모두 0점 처리될 수 있었고, 하네스가 마크다운 코드 울타리 없이 반환된 코드를 읽지 못한 경우도 있었다. 추론 모델에 토큰 한도를 너무 낮게 설정한 문제도 있었다. 이에 따라 판정 도구가 설치돼 있는지 확인하는 사전 점검을 스크립트의 첫 단계로 두었다고 설명했다.
한 번의 실행만으로는 측정이 되지 않는다는 점도 강조했다. 첫 실행에서는 gpt-oss가 6/6을 기록하고 Qwen3.8이 그 뒤를 이었지만, 다섯 번 실행한 결과에서는 순위가 뒤집혔다. 이바노프는 평균만이 아니라 결과의 편차도 함께 보고해야 한다고 주장한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요