Stockfish가 깊이 10에서 평가한 체스 포지션 10억 개로 7,900만 매개변수 신경망을 학습한 실험이 공개됐다. 제작자는 손실이 학습 내내 감소해 더 많은 데이터가 성능 개선에 기여할 여지가 있다고 봤으며, 데이터셋을 Gigafish on Hugging Face에 공개했다.
데이터와 모델 구성
데이터셋은 Lichess Open Database에서 37개월간의 대국을 가져와 포지션을 추출하고 중복을 제거한 뒤, 남은 각 포지션을 Stockfish 깊이 10으로 평가해 만들었다. 전체적으로 39억 개 포지션의 FEN과 평가를 추출했으며, 학습에는 계산 자원 제약으로 10억 개를 사용했다. 학습에는 약 3일이 걸렸다.
모델은 ResNet 블록 6개 뒤에 Transformer 블록 16개를 연결한 하이브리드 구조로, AdamW와 1e-4 학습률을 사용했다. 입력은 양쪽 기물의 8×8 비트보드와 캐슬링 권리·전체 수 같은 정보를 담은 메타 평면 6개로 구성된다. 출력은 승률 구간 101개와 강제 체크메이트를 위한 구간 2개, 총 103개 로짓이다.
제작자는 순수 Vision Transformer, 순수 ResNet, 하이브리드 모델을 시험했다. 4,000만 매개변수 파일럿에서는 Vision Transformer가 ResNet과 하이브리드보다 뒤처졌고, 8,000만 매개변수 파일럿에서는 하이브리드가 합성곱의 공간 패턴 학습과 어텐션의 전체 보드 관계 학습을 함께 활용했다고 설명했다.
학습 결과와 대국 성능
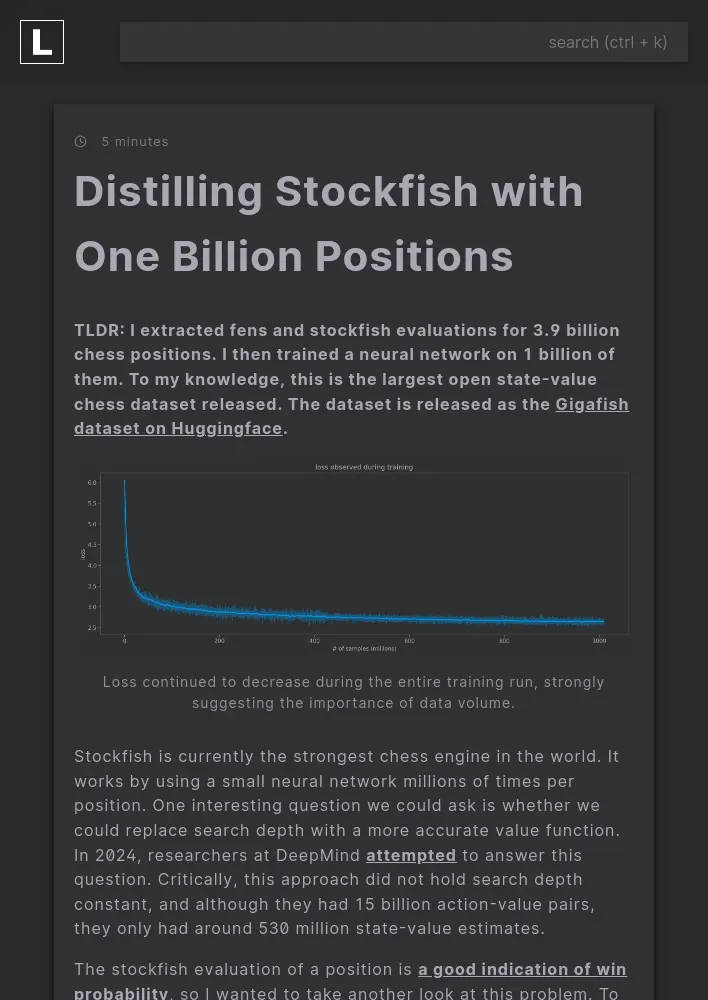
약 5만 포지션으로 구성한 검증 세트에서 손실은 2.648이었다. 모델이 어느 쪽이 우세한지 Stockfish와 같은 방향으로 판단한 비율은 92.97%였고, 강제 체크메이트가 아닌 포지션의 승률 예측은 평균 약 4~5%포인트 차이를 보였다. 이를 Stockfish의 센티폰으로 환산한 평균 절대 오차는 거의 패배에서 거의 승리까지 이르는 포지션 범위에서 64cp였다.
Stockfish 깊이 10 평가를 교사로 사용했으므로 모델도 대체로 깊이 10 수준을 기대할 수 있지만, 작은 오차가 있을 것으로 제작자는 설명한다. 깊이 7 전후까지는 비교적 잘 대국했지만 깊이 9에서는 대부분 패하거나 비겼다. 제작자는 학습 손실 곡선이 계속 낮아졌다는 점을 들어 데이터 규모를 늘리면 개선 여지가 남아 있다고 봤다.
데이터셋 구축과 비교
FEN 중복 제거에는 해시의 앞 12비트에 따라 포지션을 4,096개 파일로 나누고, 각 파일을 메모리의 해시 집합으로 처리하는 방식을 사용했다. 이후 Stockfish 깊이 10 평가를 붙이는 데 24개 코어를 사용하고도 하루 넘게 걸렸다고 설명한다.
제작자는 Gigafish를 공개된 포지션·평가 체스 데이터셋 가운데 아는 범위에서 가장 큰 데이터셋이라고 소개한다. ChessBench는 데이터 포인트가 더 많지만, 포지션·수·평가로 이루어진 상태-행동-가치 데이터이며 고정된 탐색 깊이로 계산된 것은 아니라고 덧붙였다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요