TL;DR
- 실제 오픈소스 저장소의 문서화 과제 292개를 평가한 DoGBench에서 논문에 보고된 모델·하네스 7개 조합의 최고 점수는 홀드아웃 세트에서 47.3점이며, 클라우드 에이전트 최고 종합 점수는 54.8점임.
- 과제 중 205개는 문서 변경이 필요하고 87개는 변경이 불필요하며, 주 평가 세트는 변경 필요 과제 82개와 불필요 과제 35개로 구성됨.
- 별도 제출물 1,267개 감사에서 45.5%는 작업 완료에 필요한 내용이 빠졌고 36.6%는 기술적 부정확성이 있었으며, 범주가 서로 겹침.
- 환각 콘텐츠는 제출물의 6.1%에서 발견됐고, 실제 기능의 범위 왜곡·기본값 오기·조건부 동작의 보편화도 기술적 부정확성으로 분류됨.
- 업데이트 필요 여부 판단과 패치 품질을 따로 평가하고, 치명적 기준(P0) 하나라도 실패하면 점수를 60점으로 제한하는 전문가 검토 기준임.
문서 생성 벤치마크 DoGBench
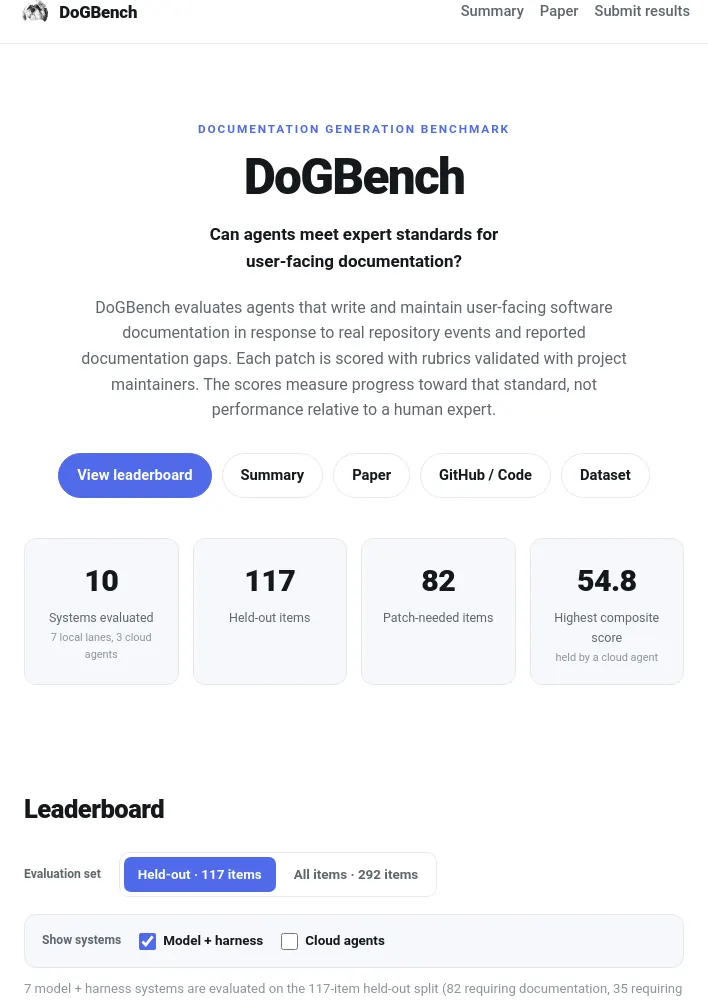
- DoGBench는 실제 저장소 변경이나 보고된 문서 공백에 대응해 사용자 대상 소프트웨어 문서를 작성·유지하는 에이전트를 평가함.
- 각 패치는 프로젝트 유지관리자가 검증한 루브릭으로 채점하며, 점수는 인간 전문가와의 상대 성능이 아니라 해당 기준에 대한 진척도를 측정함.
- 벤치마크에는 Helm, PostHog, Mautic, Doc Detective를 포함한 실제 오픈소스 프로젝트의 과제 292개가 포함됨. 문서 변경이 필요한 과제는 205개, 변경하지 않아야 하는 과제는 87개임.
- 과제에는 새 문서 작성, 기존 안내 업데이트, 오래됐거나 중복된 콘텐츠 삭제가 포함됨.
- 재현성을 위해 클라우드 기반이 아닌 에이전트 7개의 전체 실행 궤적 735개를 공개함.
- 평가 대상은 총 10개 시스템이며, 로컬 실행 레인 7개와 클라우드 에이전트 3개임. 페이지에 표시된 최고 종합 점수는 클라우드 에이전트의 54.8점임.
리더보드와 평가 세트
- 주 평가 세트는 무작위 층화 방식으로 나눈 홀드아웃 과제 117개이며, 변경 필요 과제 82개와 변경 불필요 과제 35개로 구성됨. 전체 과제는 292개임.
- 논문에 보고된 모델·하네스 7개 레인 가운데 홀드아웃 세트 최고 합산 점수는 Qwen3.8 Max와 OpenCode 조합의 47.3점임.
- 리더보드에는 같은 홀드아웃 세트에서 평가한 클라우드 에이전트 시스템 3개도 포함됨.
- Promptless는 모든 Promptless 고객이 이용할 수 있는 동일한 프로덕션 에이전트로 평가됐으며, DoGBench 작업에 맞춘 별도 개선은 적용하지 않음.
- 클라우드 에이전트에는 인터넷을 사용하지 말라는 지침이 주어짐. Promptless가 오염 가능성이 있는 정보를 찾기 위해 인터넷을 탐색하지 않았다는 점은 검증했지만, 다른 클라우드 에이전트는 검증할 수 없었음.
연구 요약
에이전트는 문서 업데이트 필요 여부를 판단하는 데 어려움을 겪음
- 문서화 작업은 코드 변경이 사용자에게 영향을 주는지, 새 안내가 필요한지를 판단하는 일에서 시작됨.
- 에이전트는 내부 리팩터링이나 성능 최적화처럼 새 사용자 안내가 필요 없는 변경도 문서화하는 한편, 기능을 다루는 기존 페이지가 없다는 사실 자체가 해결해야 할 문서 공백인데도 필요한 업데이트를 놓치기도 함.
- 논문에 보고된 모델·하네스 7개 레인 중 홀드아웃 세트 최고 합산 점수는 Qwen3.8 Max와 OpenCode 조합의 47.3점임.
매끄러운 문장도 독자의 작업 완료를 보장하지 않음
- 패치가 명확하고 사실에 부합해도 선행 조건, 선택 지점 또는 필수 절차가 빠질 수 있으며, 독자가 찾기 어려운 페이지에 배치되거나 다른 곳의 안내와 모순될 수도 있음.
- 별도로 제출물 1,267개를 폭넓게 감사한 결과, 45.5%에 누락된 선행 조건·절차·검증 단계·복구 경로 등 작업 완료 공백이 있었음.
- 36.6%에는 기술적 부정확성이 있었고 32.5%는 핵심 개념이나 참조 정보의 일부를 누락함. 범주들은 서로 겹침.
- 클래스·플래그·엔드포인트 등을 지어낸 콘텐츠는 제출물의 6.1%에서 나타남.
- 최첨단 에이전트의 환각은 실제 기능의 범위를 늘려 설명하거나 기본값을 잘못 기술하고, 특정 조건에서만 성립하는 동작을 보편적 사실처럼 제시하는 더 미묘한 형태로도 나타남. 감사에서는 이러한 왜곡을 기술적 부정확성으로 분류함.
- 실행 궤적 분석에서는 에이전트가 결정적인 증거를 자주 놓치거나, 편집할 만한 첫 페이지를 찾은 뒤 조사를 멈추는 경향도 확인됨.
전문가 검토는 여전히 필요함
- 패치가 루브릭상 치명적 결함을 하나도 포함하지 않을 때 P0 클린(P0-clean)으로 분류함.
- 논문에 보고된 7개 레인 중 P0 클린 패치 제공률이 가장 높은 레인은 39.0%임. GPT-5.6 Sol과 Codex 조합은 업데이트가 필요한 홀드아웃 과제 82개 중 32개에서 P0 클린 패치를 제공함.
- 문서 담당자는 코드 변경만으로는 드러나지 않을 수 있는 독자, 독자의 목표, 변경이 작업 흐름에 미치는 영향을 파악함. 이러한 맥락은 업데이트 필요 여부와 문서에 포함해야 할 내용을 판단하는 데 도움이 됨.
- 에이전트 초안을 검토할 때는 독자가 안내를 찾고, 절차를 완료하고, 결과를 검증할 수 있는지 확인해야 함. 기술적 주장의 전제 조건을 확인하고 관련 페이지의 모순이나 오래된 지침도 살펴야 함.
에이전트 평가 방법
- 각 에이전트에는 변경 전 상태의 저장소와 코드 풀 리퀘스트 또는 보고된 문서 공백 같은 촉발 신호가 제공됨. 병합된 문서는 에이전트에게 공개되지 않음.
- 동일한 과제 세트에서 에이전트 레인 7개를 평가함. 과제별 루브릭은 정확성, 완전성, 독자 안내, 배치, 문체, 저장소 규칙 준수 여부를 평가함.
- 문서 변경이 필요한 과제 205개에 대한 현재 루브릭에는 기준 3,273개가 있으며, 이 가운데 798개는 P0 기준임.
- DoGBench는 업데이트 판단과 패치 품질을 별도로 보고함.
- 제공된 패치 품질은 업데이트가 필요한 홀드아웃 과제 82개 전체에서 패치 품질을 평균함. 업데이트를 놓쳤거나 빈 패치를 낸 경우 점수는 0점임.
- 올바른 보류는 업데이트가 필요하지 않은 홀드아웃 과제 35개에서 문서를 변경하지 않은 비율을 측정함.
- 합산 점수는 제공된 패치 품질과 보류 재현율의 조화평균인 2DN / (D + N)임. 한쪽 성능이 높아도 다른 쪽의 낮은 성능을 완전히 상쇄할 수 없음.
- 치명적 실패가 있으면 패치 점수는 100점 만점에 60점으로 제한됨. 각 루브릭 기준의 가중치는 같지만 P0 기준 하나라도 실패하면 상한이 적용되므로, 부차적 기준의 강점으로 치명적 결함을 평균 상쇄할 수 없음.
문서 담당자를 위한 자료
- 기술 문서 작성의 어려움과 현재 AI 에이전트의 한계를 팀이나 리더십과 논의하려는 문서 담당자를 위해 간결한 슬라이드 자료가 준비됨.
- 기타 자료로 WTD Bay Area Meetup 발표 자료(2026년 9월 30일, PDF)와 WTD Australia(2026년 12월 3~4일, 예정)가 안내됨.
인용
- DoGBench를 연구에 사용할 때 인용할 논문 정보는 다음과 같음.
- 제목: DoGBench: Can Agents Meet Expert Standards for User-Facing Documentation?
- 저자: Frances Liu, Manny Silva, Paige Calvert, Ayu Adiati, Sarah Sanders
- 연도: 2026
- 유형: 원고
- URL: https://dogbench.ai/paper
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요