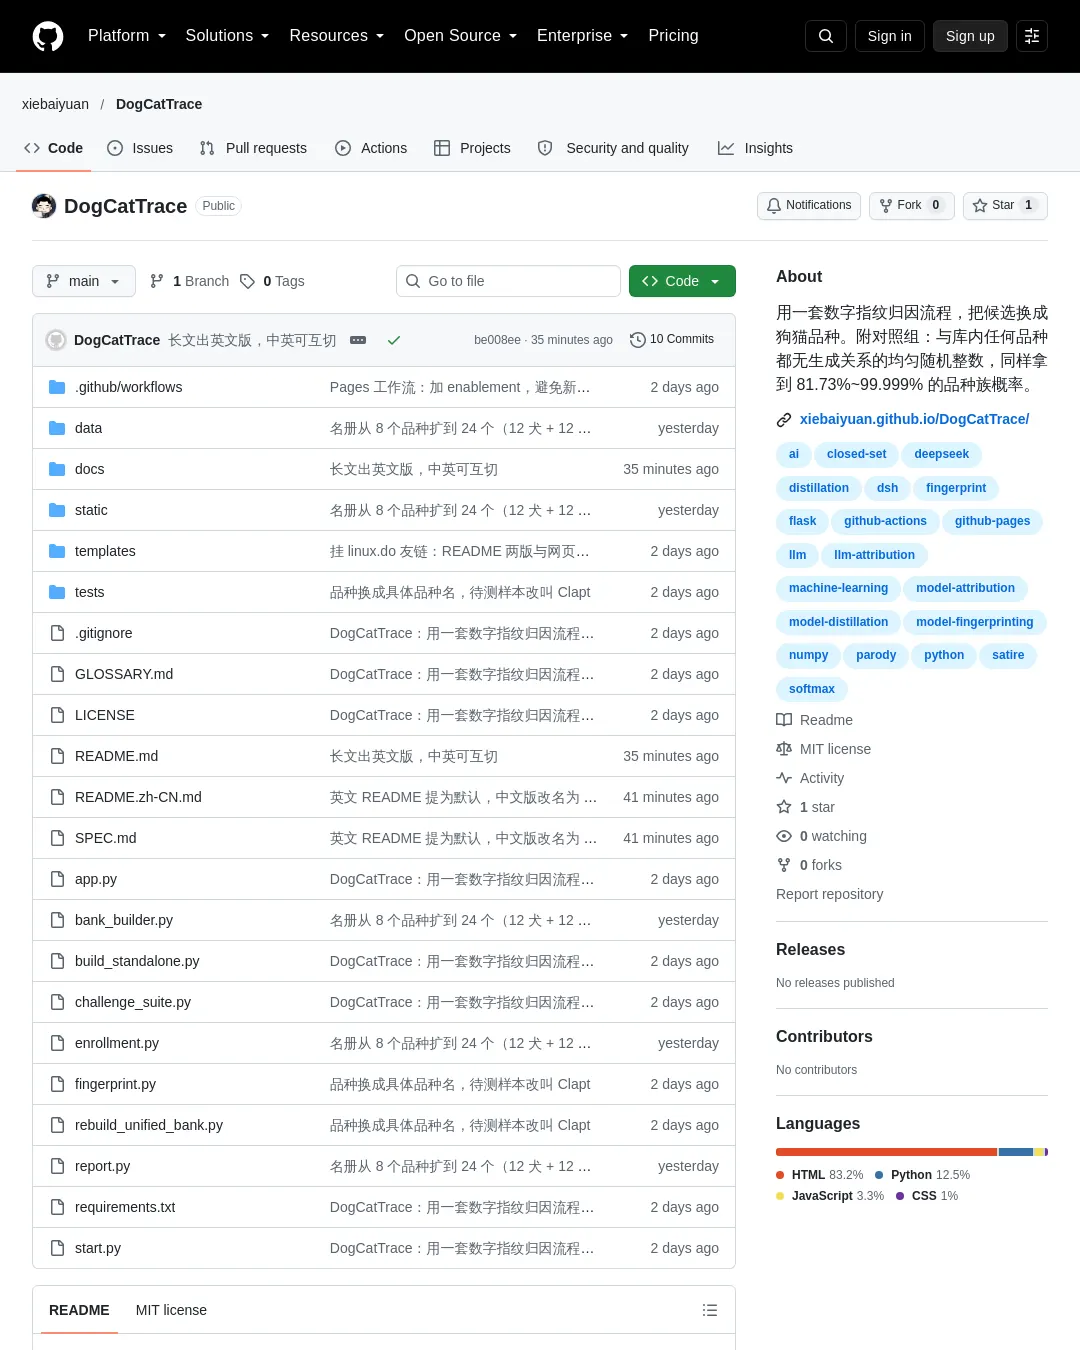
DogCatTrace는 연구 도구가 아니라 농담 프로젝트다. 숫자 분포의 유사도와 닫힌 집합 소프트맥스(softmax)로 어떤 모델이 다른 모델이나 모델 계열에서 증류됐는지 판정하는 것은 우스운 일이며, 유사성이 같은 출처를 뜻하지 않는다는 점을 보여주기 위해 그 수학적 절차를 그대로 실행한다.
저장소의 ‘품종’, ‘품종 계열’, ‘증류’는 모두 장치다. 숫자는 합성 데이터이고, 테스트 샘플은 허구이며, 지문 라이브러리의 24개 품종은 존재하지 않는다. 어떤 백분율도 실제 모델에 대한 판단 근거가 되지 않는다. 영어판 README도 제공한다.
DogCatTrace는 세 가지 독립적인 정수 생성 과제로 출력 지문을 추출하고, 통합 후보 라이브러리에서 개·고양이 계열과 구체적인 품종을 자동으로 판정하는 품종 귀속 도구를 표방한다. 사용자는 웹페이지에서 세 가지 과제를 복사해 같은 모델에 그대로 보내고, 도구를 사용하지 않은 채 첫 반응으로 1부터 355까지의 정수열을 내놓게 한 뒤, 세 번의 전체 출력을 붙여 넣는다. 결과에는 개 계열 또는 고양이 계열과 품종별 설정이 표시된다. 품종 설정은 해당 모델의 ‘2차원 캐릭터’라는 농담이다.
도구는 다음 품종 설정을 제시한다.
- 개 계열: 허스키(활력이 지나쳐 꼬리를 프로펠러처럼 흔들고, 한 번 부르면 세 번 답함), 래브라도(버전은 올라도 차분함은 별로 늘지 않고 아는 사람을 보면 제자리에서 뜀), 슈나우저(훈련된 엘리트견처럼 지시를 알아듣지만 지켜보는 사람이 없으면 집을 어지럽힘), 코기(다리가 짧아도 자신감이 넘치고 누구에게나 친근하지만 고양이에게 혼나면 사람 뒤로 숨음), 골든 리트리버(누가 끌고 가도 따라가는 순한 성격으로 장난감을 빼앗겨도 꼬리를 흔듦), 보더콜리(모든 지시를 배우고 사람을 속이는 법까지 익히는 지능형), 시바견(부르면 모른 척하지만 사진 찍을 때는 협조하는 밈 그 자체), 사모예드(미소 천사지만 하얀 털로 진흙탕을 찾아 구름), 알래스칸 말라뮤트(덩치가 크고 말수는 적으며 위풍당당해 보여도 천둥을 무서워함), 비글(코가 머리보다 빨라 냄새를 맡으면 사라짐), 푸들(미용사가 가장 좋아하며 털을 깎고 나면 사람보다 더 세련됨), 불독(겉보기와 달리 하루 스무 시간 자고 아파트가 울릴 정도로 코를 곪).
- 고양이 계열: 랙돌(세 번 부르면 한 번 돌아보는데 그때도 싫은 표정), 샴(붙고 싶을 때만 붙고 그렇지 않을 때는 사람을 가구처럼 여김), 치즈태비(계속 야옹거리며 말투도 꽤 퉁명스럽고 밤중에 몰래 이불로 들어옴), 브리티시 쇼트헤어(먹고 자는 것 말고는 움직임이 없고 버전 번호와 함께 체중이 늘어나는 게으름의 정점), 메인쿤(고양이 중 거인이고 개처럼 사람을 문 앞까지 배웅함), 페르시안(하루 세 번 털을 빗고 납작한 얼굴로 모두를 화난 듯 바라봄), 아메리칸 쇼트헤어(활력이 넘쳐 한밤중에 거실을 뛰어다님), 러시안 블루(낯을 가려 사흘간 숨다가 넷째 날 갑자기 무릎에 앉음), 스코티시 폴드(접힌 귀와 앉은 모습이 작은 노인 같음), 스핑크스(털이 없어 추위를 타고 겨울에는 사람에게 붙어 손난로처럼 지냄), 벵갈(집안 재산을 다 써도 감당하기 어려울 만큼 말썽을 부리고 혼자 수도꼭지를 틀기도 함), 노르웨이 숲(두꺼운 털이 패딩처럼 보이고 겨울에는 창가에 누워 눈을 구경함).
저장소는 이 판정이 카드를 뽑는 것과 마찬가지로 계산된 결과일 뿐, 실제로 측정한 결과가 아니라고 강조한다.
이용 방법과 실행 조건
온라인판은 설치가 필요 없고 귀속 계산과 지문 라이브러리 읽기가 브라우저 안에서 이뤄져 백엔드에 연결하지 않는다. 오프라인판은 static/DogCatTrace-standalone.html을 더블클릭해 실행하는 단일 파일이며 네트워크 연결 없이 쓸 수 있다. 전체 인터페이스를 포함한 로컬 서비스도 제공한다.
로컬 서비스를 실행하는 명령은 다음과 같다.
python3 -m pip install -r requirements.txt python3 start.py
페이지 주소는 http://127.0.0.1:7860/다. DOGCATTRACE_NO_BROWSER=1 환경 변수를 설정하면 시작할 때 브라우저가 자동으로 열리지 않게 할 수 있다.
전체 파이프라인은 다음 다섯 명령을 순서대로 실행한다.
python3 enrollment.py --seed 20261017 python3 bank_builder.py --responses data/dog_reference.jsonl --output data/dog_bank.json python3 bank_builder.py --responses data/cat_reference.jsonl --output data/cat_bank.json python3 rebuild_unified_bank.py python3 report.py
첫 단계에서 합성 참조 말뭉치 두 개를 만들고, 두 번째와 세 번째 단계에서 각각 개 계열과 고양이 계열의 지문 라이브러리를 맞춘다. 네 번째 단계는 두 라이브러리를 통합 전역 라이브러리로 합치며, data/unified_bank.json과 static/data/unified_bank.json에 바이트 단위로 동일한 파일을 쓴다. 마지막 단계는 귀속을 한 차례 실행해 docs/归因报告.md 보고서를 만든다. 테스트는 python3 -m pytest tests/로 실행한다.
수동 테스트에서는 페이지의 세 과제를 복사해 같은 테스트 샘플에 각각 전달하고, 각 응답 전체를 붙여 넣는다. 도구는 세 응답을 제출받아 정수열을 파싱하고 지문을 추출한 다음, 통합 라이브러리에서 품종별 확률과 품종 계열별 확률을 계산한다. 페이지에서 통합 라이브러리의 모델 목록, 샘플 수, 보정 매개변수도 확인할 수 있다.
각 응답에서 1부터 355 사이의 정수를 최소 80개 파싱해야 해당 응답을 유효한 입력으로 인정한다. 유효한 응답이 세 개보다 적으면 실제 응답 수에 맞는 보정 온도를 사용하고, 결과에 실제로 사용한 질의 수를 표시한다.
지문 계산과 결과 해석
모든 품종은 동일한 전역 특성 공간과 특성·가중치를 사용한다. 핵심 알고리즘은 0.75 × 환경 방향을 제거한 Hellinger 품종 중심 유사도 + 0.25 × 순서가 있는 블록 숫자열 특성이다.
각 출력은 먼저 정수열로 파싱한 뒤 두 특성을 계산한다. 주변 분포 특성은 길이 355의 계수 벡터에 α = 0.5의 Hellinger 변환을 적용한다. 순서 특성은 정수열을 위치에 따라 네 블록으로 나누고 각 블록을 16개 값 구간으로 나눈 뒤, 마지막 자리 숫자 분포를 더해 총 74차원으로 만든다. 이 특성에도 Hellinger 변환을 적용한다.
라이브러리를 만들 때는 환경을 공유하는 평균 편차로 간섭 방향을 추정한다. 귀속 단계에서는 두 특성에서 그 방향을 투영해 제거한 뒤 모든 품종 중심과의 코사인 유사도를 동시에 계산한다. 세 응답은 각각 점수를 낸 뒤 계열별로 평균을 구하고, 질의 수에 해당하는 보정 온도로 확률을 변환한다.
구체적인 품종 확률은 한 번의 전역 소프트맥스로 산출하며, 품종 계열 확률은 해당 계열에 속한 품종들의 확률을 더해 구한다.
P(具体品种) = softmax(β × 全局品种得分) P(品种族) = Σ P(该族中的具体品种)
β는 그룹 교차 검증의 음의 로그 가능도를 최소화하도록 탐색하며 탐색 구간은 [0.05, 12.0]이다. 보고서 요약에 기재된 이번 실행 결과는 다음과 같다.
| 항목 | 값 |
|---|---|
| 질의 수 | 3 |
| 보정 온도 β | 12.000000 |
| 교차 검증 정확도 cv_accuracy | 98.26% |
| 등록 품종 수 | 24 |
| 등록 샘플 수 | 864 |
이번 세 질의의 β는 12.000000으로 탐색 구간의 오른쪽 끝에 걸렸다. 질의가 한 개일 때는 상한에 도달하지 않았으며 β는 8.010150이었다. 결과는 현재 후보 라이브러리 안에서 균등 사전확률을 가정한 닫힌 집합 확률이다. 라이브러리에 없는 샘플도 기존 후보 중 가장 유사한 항목으로 분류된다.
대조군에서는 라이브러리의 어떤 품종과도 생성 관계가 없는 균등 무작위 정수를 같은 귀속 절차에 넣어도 품종 계열 확률이 높게 나왔다. 다섯 개 시드의 결과는 docs/归因报告.md의 ‘대조군’ 절에 있다.
라이브러리와 합성 데이터
저장소의 현재 통합 라이브러리는 두 품종 계열과 24개 품종으로 구성되며, 각 계열에 12개 품종이 있다. 개 계열의 품종은 허스키, 래브라도, 슈나우저, 코기, 골든 리트리버, 보더콜리, 시바견, 사모예드, 알래스칸 말라뮤트, 비글, 푸들, 불독이다. 고양이 계열은 랙돌, 샴, 치즈태비, 브리티시 쇼트헤어, 메인쿤, 페르시안, 아메리칸 쇼트헤어, 러시안 블루, 스코티시 폴드, 스핑크스, 벵갈, 노르웨이 숲이다.
각 품종에는 36개의 참조 말뭉치가 있다. 12개 환경에서 질의를 세 개씩 생성하며 두 계열을 합쳐 총 864개가 된다. 다만 라이브러리 설명 뒤쪽에는 두 계열의 구성원 수가 각각 4라고 적혀 있다. 구성원 수를 늘릴 때는 두 계열을 함께 늘려야 하며, 그렇지 않으면 계열 확률의 크기가 유사도가 아니라 구성원 수를 반영한다는 설명도 나온다.
테스트 샘플 Clapt(clapt)는 라이브러리에 들어 있지 않다. 그 가중치 벡터는 개 계열 기준 벡터 0.80개 분량과 고양이 계열 기준 벡터 0.20개 분량을 혼합하고, 111 위치의 봉우리를 더해 만든다.
참조 말뭉치는 매개변수화된 생성기로 합성하며 생성 중에는 네트워크 요청을 하지 않는다. 각 품종은 355차원 가중치 벡터 하나를 갖는다. 가중치는 가우스 봉우리, 값 구간 상승, 마지막 자리 편향, 위치 이동의 네 요소를 곱해 만든다. 표본을 뽑을 때는 각 위치의 가중치를 정규화한 뒤 범주형 표본 추출을 한다. 품종 간 차이는 결정론적 위상 교란으로 구현하며, 같은 시드를 쓰면 항상 같은 말뭉치가 나온다.
저장소의 반례와 한계
이 도구는 결과가 그럴듯한 백분율로 보이더라도 그것을 증류의 증거로 간주하는 것이 프로젝트가 보여주려는 농담이라고 설명한다. 이 주장을 자세히 다룬 글은 ‘softmax는 증류를 도출하지 않는다’다. 이 절과 docs/satire-targets.md를 제외한 저장소의 다른 파일은 앞서 설명한 방법으로 해석하라고 안내한다.
보고서의 대조군 결과에 따르면, 라이브러리의 어떤 품종과도 생성 관계가 없는 균등 무작위 정수에 같은 귀속 절차를 적용했을 때 다섯 개 시드의 품종 계열 확률은 78.4612%에서 99.9999% 사이에 있었다. 판정은 개 계열과 고양이 계열 모두에서 나왔다. 자세한 결과는 docs/归因报告.md의 ‘대조군’ 절에 있다.
저장소는 계산 과정에서 생기는 네 가지 추론의 비약을 설명한다.
- T1, 숫자 분포의 유사도가 확률의 입력이다. 소프트맥스 입력은 무작위 숫자에서 계산한 코사인 유사도이고 출력에는 ‘확률’이라는 이름이 붙는다. 하지만 유사도에는 출처 정보가 없다. 같은 프롬프트 템플릿, 샘플링 온도, 토크나이저, 포장 문구도 유사성을 만들 수 있고, 서로 독립적인 출처도 우연히 같은 숫자에 치우칠 수 있다. ‘숫자 분포가 후보 A와 비슷하다’에서 ‘샘플을 후보 A가 만들었다’로 넘어가는 과정은 채워져 있지 않다. 도구는 학습 데이터, 가중치, 증류 기록을 전혀 확인하지 않는다.
- T2, 품종 계열 확률은 구성원 확률의 합이다. 합산은 확률을 더하는 것이지 계열을 식별하는 일이 아니다. 한 계열에 구성원이 12개씩 있더라도 합계가 어느 계열이 출처인지 알려주는 논리적 연결은 없다. 계열 내 한 구성원이 특히 비슷한 경우와 모든 구성원이 조금씩 비슷한 경우도 같은 합계로 압축될 수 있다. 이번 실행에서 불독의 품종 귀속 확률은 63.72%였지만 개 계열의 확률은 99.9999%였다. 두 수치는 서로 다른 내용을 나타낸다. ‘이 계열 구성원의 확률 합이 가장 크다’에서 ‘이 계열이 테스트 샘플의 조상이다’로 가는 단계도 빠져 있다.
- T3, 온도 β의 탐색 상한이다. β의 탐색 구간은 [0.05, 12.0]이며 로그 간격으로 균등한 801개 지점을 살핀다. 통합 라이브러리의 보정 결과에서 질의가 한 개일 때 β는 8.010150, 두 개와 세 개일 때는 모두 11.99999999999999였다. 두 질의와 세 질의의 β가 상한에 닿았으므로 최적값은 탐색 구간 바깥에 있지만 탐색이 잘린 셈이다. β가 커질수록 소프트맥스는 뾰족해진다. β가 무한대에 가까워지면 소프트맥스는 원-핫 분포로 퇴화해 점수가 가장 높은 후보가 확률을 모두 가져간다. 교차 검증 정확도가 이미 상한에 가까운 경우에도 음의 로그 가능도는 β가 커질수록 계속 낮아질 수 있어, 적합 과정이 경계까지 β를 밀어 올린다. 따라서 확률의 절대 크기는 데이터가 아니라 탐색 구간의 오른쪽 끝에 좌우될 수 있다. 이런 방식으로 나온 백분율을 ‘확신도’로 읽으면 상한에 잘린 배율을 확신도로 오해하게 된다. 이번 세 질의에서 사용한 β 12.000000은 바로 그 상한이다.
- T4, 닫힌 집합과 균등 사전확률이다. 후보 집합은 미리 정한 24개 품종이며 소프트맥스의 분모는 이 후보만으로 정규화된다. 따라서 24개 확률의 합은 반드시 1이다. 라이브러리 밖의 샘플도 가장 비슷한 후보에 배정되어 확률처럼 보이는 값을 얻으며, 분모에는 ‘해당 없음’이 없다. 균등 사전확률은 후보 8개가 사전에 모두 똑같이 가능하다고 취급하는 가정이다. 현실의 품종 인기도, 버전 간 반복 관계, 계열 내 구성원 수 등에 따른 사전확률 차이는 계산에 반영하지 않는다.
cv_accuracy는 환경을 기준으로 그룹을 나누고 질의를 제외한 뒤, 제외한 라이브러리 내부 샘플을 원래 품종으로 다시 식별할 수 있는지를 측정한다. 이번 세 질의의 값은 98.26%지만, 이는 라이브러리 내부 샘플을 다시 알아보는 능력만 나타내며 라이브러리 외부 샘플에 관한 수치는 아니다. ‘8개 후보 중 A가 가장 비슷하다’에서 ‘샘플은 A다’로 가는 연결은 여전히 없다. 분모가 항상 8인 닫힌 집합 가정이 이 빈틈을 가려 입력이 무엇이든 확신에 차 보이는 답을 내게 한다.
네 가지 반례는 같은 동작을 반복한다. 유사도를 계산하거나 합산하고, 구간에 잘릴 수 있는 배율로 값을 키운 다음, 닫힌 후보 집합에서 정규화한다. 마지막에는 그 소수를 확률이라고 부르고 인과관계의 주장으로 읽는다. 각 단계만 따로 보면 타당해 보이지만, 유사성에서 같은 출처라는 결론으로 넘어가는 마지막 단계는 어디에도 보충되어 있지 않다. 자세한 설명은 docs/satire-targets.md, 용어 네 가지의 정의는 GLOSSARY.md에서 확인할 수 있다.
프로젝트 파일과 추가 설정
저장소의 파일 구성은 다음과 같다.
app.py Web 接口 start.py 本地服务启动 fingerprint.py 指纹提取与归因 bank_builder.py 指纹库构建与概率校准 challenge_suite.py 建库挑战套件 enrollment.py 合成品种语料生成 rebuild_unified_bank.py 重建统一全局库 report.py 归因报告生成 data/ 参考语料与指纹库 docs/ 归因报告、靶子拆解、ADR static/ 页面资源 templates/ 页面模板 tests/ 契约测试
도전 과제 모음에는 환경 12개와 환경별 질의 3개, 총 36개 질의가 있다. 환경마다 바꾸는 것은 바깥쪽 포장 문구(포장 없음, system 접두사, user 접두사)와 목표 계수뿐이며 과제 내용은 고정돼 있다.
도구의 테스트 결과는 참고용이며 품종 출처를 판정하는 결정적 증거가 아니다. 이 도구는 지문 라이브러리에 있는 품종 중 무엇에 속하는지 가능한 한 판별하려고 한다. 테스트 샘플이 라이브러리에 없으면 어떤 결과든 나올 수 있다. 결과는 닫힌 집합 확률이므로 분모는 라이브러리 안의 후보 수로 고정되고, 라이브러리 밖의 입력도 그럴듯하게 확정된 답을 받는다. 확률의 입력은 숫자 분포의 유사도이며, 도구는 학습 데이터와 가중치, 출처 기록을 읽지 않는다.
보고서의 각 백분율은 실제 실행에서 나온 값이며 수작업으로 작성하지 않았다고 저장소는 설명한다. report.py를 다시 실행하면 그때의 말뭉치와 시드에 대응하는 결과가 나온다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요