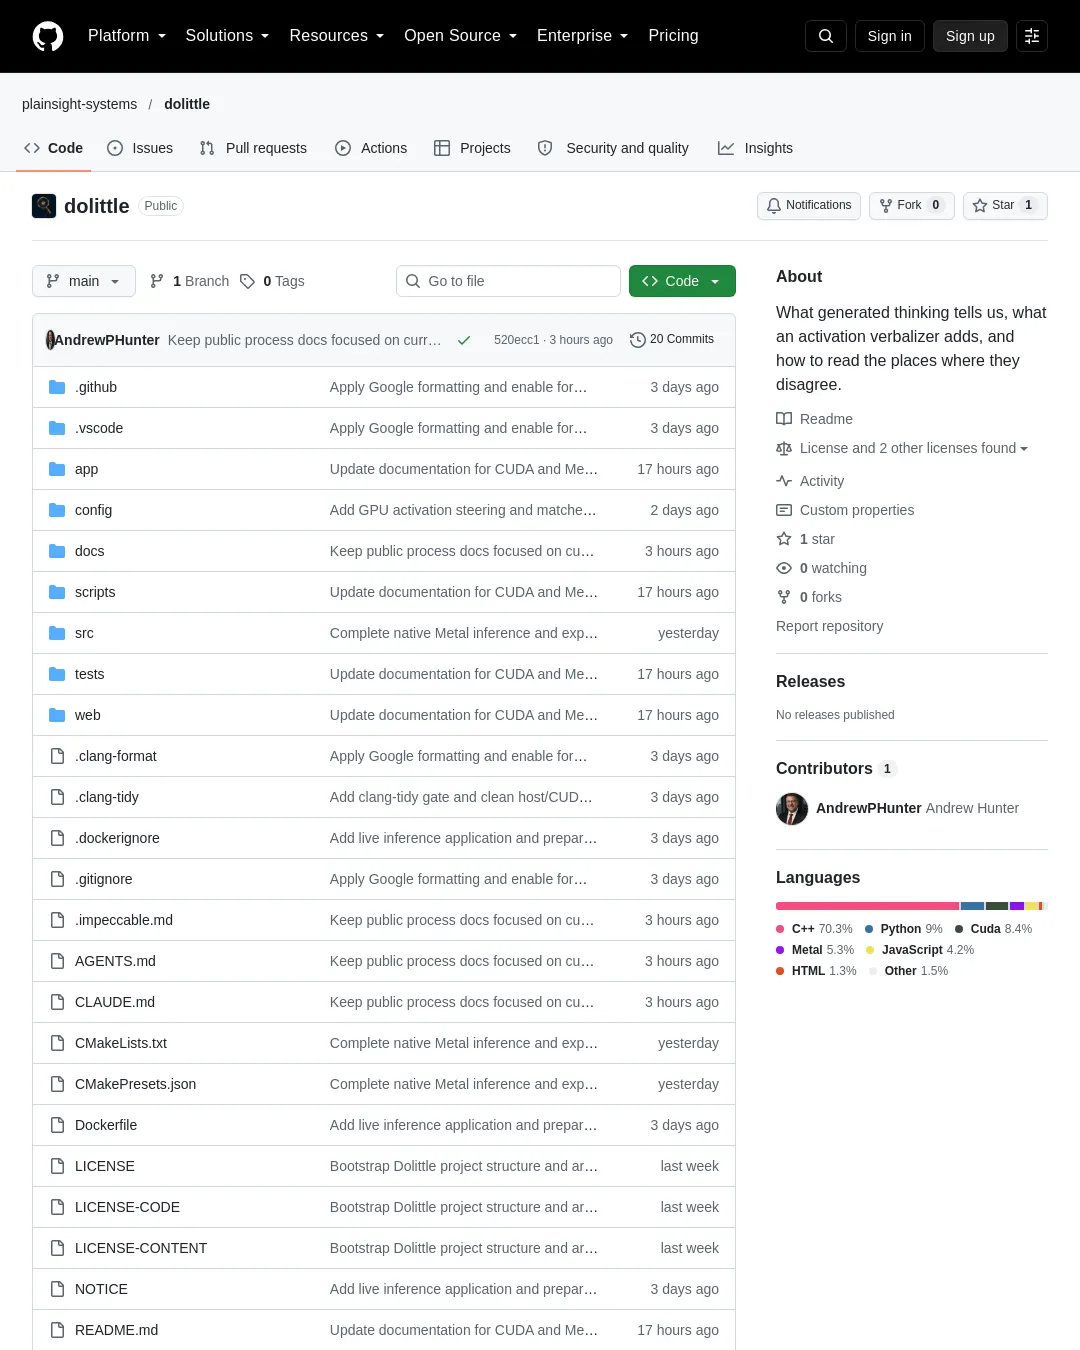
Dolittle 저장소는 Qwen3 8B가 생성한 추론 텍스트와 내부 활성화에 대한 자연어 설명을 함께 보여준다. 프롬프트를 입력하고 토큰을 선택해 설명을 살펴본 뒤, 설명을 수정해 변경 전후의 모델 응답을 비교할 수 있다.
이 도구는 C++20 엔진과 marco-bazzani의 자연어 오토인코더를 사용해 0부터 세는 블록 24의 출력을 포착한다. 생성·해석·조작은 CUDA와 Metal에서 같은 브라우저 인터페이스로 실행된다. 각 실험에는 원래 응답, 해석 샘플, 조작 결과 비교가 남는다. 다만 오토인코더가 활성화 벡터를 텍스트로 바꾸고 그 텍스트에서 벡터를 재구성해 만든 설명은 틀릴 수 있는 해석이며, 모델이 직접 생성한 추론 텍스트와 구분해야 한다.
설치와 지원 환경
Python 3.11 이상과 Git을 준비한 뒤 지원되는 호스트에서 다음 명령을 실행한다.
git clone https://github.com/plainsight-systems/dolittle.git
cd dolittle
python3 scripts/run.py
| 플랫폼 | 상태와 실행 방식 | 테스트 하드웨어 |
|---|---|---|
| Linux/NVIDIA | 사용 가능. NVIDIA Container Toolkit을 이용해 Docker에서 빌드·실행 | RTX 3090 Ti, VRAM 24 GB |
| macOS/Apple Silicon | 사용 가능. Metal로 네이티브 빌드·실행. macOS 26 이상, Metal 도구 체인이 포함된 Xcode 26, CMake 3.24 이상, OpenSSL 3 필요 | M3 Max, 통합 메모리 128 GB |
| Windows/NVIDIA | 네이티브 빌드 계획 중 | — |
| AMD | 미정 | — |
실행 도구는 소스에서 빌드하고 모델 파일 약 45 GB를 내려받은 뒤 해시를 확인한다. 이후 실행에서는 파일과 검증 결과를 재사용한다. --verify-models 옵션을 사용하면 모든 파일을 다시 확인하고 캐시를 복구한다. 실행 도구가 출력하는 전체 Open Dolittle 링크를 열고 터미널을 계속 실행해 둬야 한다. 다른 컴퓨터의 브라우저도 해당 서비스에 연결할 수 있다. 자세한 사전 조건과 원격 접속 방법은 애플리케이션 설정 안내를, 조작 절차는 단계별 안내를 참고하면 된다.
엔진은 BF16 텐서와 FP32 축약 연산을 사용한다. 다음 모델과 캐시, 작업 버퍼를 담을 공간이 있으면 모델 가중치를 요청 사이에도 GPU에 유지하며, 생성마다 새 KV 캐시를 만든다. CUDA 빌드에는 네이티브 Ampere 코드와 호환되는 NVIDIA 드라이버가 최신 카드용으로 컴파일할 수 있는 PTX가 포함된다.
프로젝트는 Plainsight Systems LLC의 R&D다. 과거 4B/8B 비교는 엔진을 만들기 전에 PyTorch로 모델 쌍을 비교한 작업이며, 8B 실행에서는 모델을 별도의 BF16 단계로 실행할 때 최대 15.4 GiB를 할당했다. 비교 내용은 연구 기록에 공개돼 있다. 배경 자료로는 Anthropic의 자연어 오토인코더 소개, 논문, 원본 구현과 체크포인트, Qwen3 8B 오토인코더 모델 쌍을 볼 수 있다.
코드와 설정은 Apache-2.0, 문서와 자체 제작 아트워크는 CC BY 4.0 라이선스를 따른다. 제3자 가중치와 구성 요소에는 각각의 라이선스가 적용된다. 자세한 범위는 LICENSE와 NOTICE를 참조하면 된다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요