TL;DR
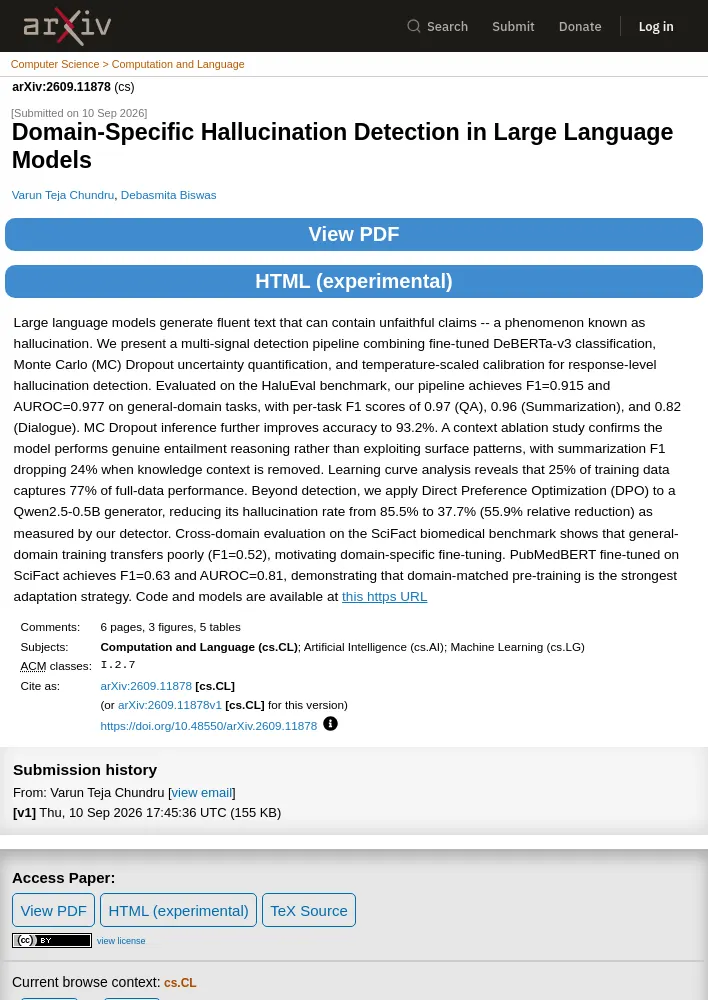
- DeBERTa-v3 분류, 몬테카를로(MC) 드롭아웃 불확실성 정량화, 온도 스케일링 보정을 결합한 파이프라인이 일반 도메인 환각 탐지에서 F1 0.915, AUROC 0.977을 달성함.
- HaluEval 기준 작업별 F1은 질의응답 0.97, 요약 0.96, 대화 0.82이며, MC 드롭아웃 추론 적용 시 정확도가 93.2%로 향상됨.
- 지식 문맥을 제거하면 요약 F1이 24% 하락해 표면 패턴이 아닌 실제 함의 추론에 기반한 탐지임을 뒷받침하며, 학습 데이터 25%만으로 전체 성능의 77%를 확보함.
- Qwen2.5-0.5B 생성기에 직접 선호 최적화(DPO)를 적용한 결과 탐지기 기준 환각률이 85.5%에서 37.7%로 감소해 상대적으로 55.9% 줄어듦.
- SciFact 생의학 벤치마크에서는 일반 도메인 학습의 전이가 F1 0.52로 낮았으며, PubMedBERT 도메인 특화 미세 조정이 F1 0.63, AUROC 0.81로 가장 강력한 적응 전략임을 보임.
초록
- 대규모 언어 모델(LLM)은 유창하지만 사실에 충실하지 않은 주장을 포함한 텍스트를 생성하며, 이러한 현상이 환각(hallucination)임.
- 응답 수준 환각 탐지를 위해 미세 조정한
DeBERTa-v3분류, 몬테카를로(MC) 드롭아웃 불확실성 정량화, 온도 스케일링 보정을 결합한 다중 신호 탐지 파이프라인을 제시함. HaluEval벤치마크의 일반 도메인 작업에서 F1 0.915, AUROC 0.977을 달성함.- 질의응답(QA) F1: 0.97
- 요약(Summarization) F1: 0.96
- 대화(Dialogue) F1: 0.82
- MC 드롭아웃 추론을 추가하면 정확도가 93.2%로 향상됨.
- 문맥 절제 연구에서 지식 문맥을 제거할 때 요약 F1이 24% 하락해, 모델이 표면 패턴을 활용하는 것이 아니라 실제 함의(entailment) 추론을 수행함을 확인함.
- 학습 곡선 분석에서 학습 데이터의 25%가 전체 데이터 성능의 77%를 포착함.
- 탐지를 넘어
Qwen2.5-0.5B생성기에 직접 선호 최적화(DPO)를 적용함. - 탐지기로 측정한 환각률이 85.5%에서 37.7%로 감소함.
- 상대적 감소폭은 55.9%임.
SciFact생의학 벤치마크의 교차 도메인 평가에서 일반 도메인 학습의 전이 성능은 F1 0.52로 낮아 도메인 특화 미세 조정의 필요성을 제기함.PubMedBERT를SciFact에 미세 조정한 결과 F1 0.63, AUROC 0.81을 달성해 도메인에 맞춘 사전 학습이 가장 강력한 적응 전략임을 보임.- 코드와 모델이 제공됨.
논문 정보
- 분야: 전산학 및 언어(Computation and Language), 인공지능(Artificial Intelligence), 기계학습(Machine Learning)
- 논문 식별자: arXiv:2609.11878
- 제출일: 2026년 9월 10일
- 저자: Varun Teja Chundru, Debasmita Biswas
- 인용 표기: arXiv:2609.11878 [cs.CL] 또는 arXiv:2609.11878v1 [cs.CL]
- DOI: https://doi.org/10.48550/arXiv.2609.11878
- 버전 이력: v1, 2026년 9월 10일 17:45:36 UTC, 155KB
- ACM 분류: I.2.7
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요