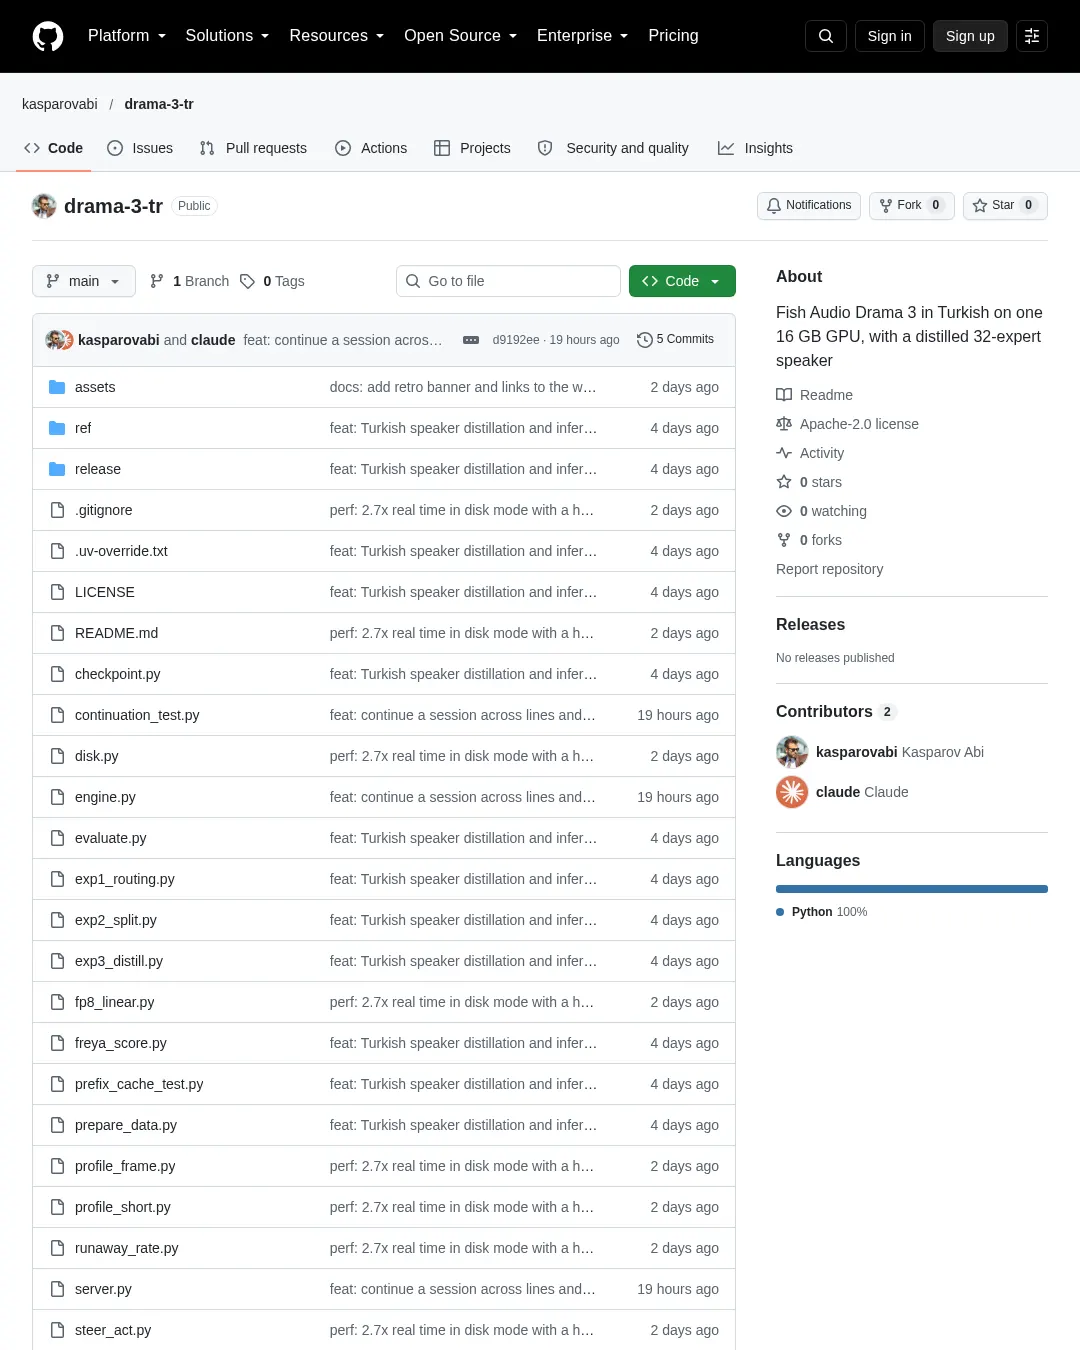
Drama 3를 터키어로 음성 합성하도록 조정한 프로젝트 drama-3-tr는 16GB GPU 한 장에서 짧은 문장을 실시간보다 약 2.7배 빠르게 생성한다고 보고했다. 문단은 대부분의 실행에서 실시간보다 3.2~3.4배 빠르지만, 한 번은 1.9배에 그쳤다. 제작자는 음성 모델과 화자 모델을 나누고 전문가 가중치를 NVMe 드라이브에서 불러와 41.5GB 체크포인트를 RAM에 통째로 올리지 않는 방식으로 구성했다.
| 항목 | 결과 |
|---|---|
| Freya-TR-Eval WER 및 CER (495문장, Freya 프로토콜), guidance 4, hot tier를 켠 디스크 모드 | 2.27% 및 0.62% |
| 수정하지 않은 Drama 3와 비교한 teacher-forced KL (보류한 발화 200개) | 0.066 |
| RTX 5070 Ti에서 짧은 문장 (Freya-TR-Eval, 중앙값 3.5초), hot tier를 켠 컴파일 디스크 모드 | 실시간의 2.7배 (중앙값) |
| 16~20초 문단, 같은 설정 | 여섯 번 중 다섯 번은 실시간의 3.2~3.4배, 한 번은 1.9배 |
| 짧은 문장, hot tier 없이 컴파일한 디스크 모드 | 실시간의 1.2배 (중앙값) |
| VRAM | 짧은 문장 최대 14.0 GiB, 문단 최대 15.0 GiB |
| 시스템 RAM | 6,000개 전문가 hot tier 사용 시 25GB, 미사용 시 4.9GB |
테스트 환경은 Windows 11, Python 3.13, torch 2.14.1+cu132, triton-windows 3.8이다. 설치와 실행 명령은 저장소에 안내돼 있다.
git clone https://github.com/kasparovabi/drama-3-tr && cd drama-3-tr
git clone https://github.com/fishaudio/fish-speech && git -C fish-speech checkout 5415669
hf download fishaudio/drama-3 --local-dir models/drama-3
hf download kasparovabi/drama-3-tr-speaker speaker.safetensors config.json --local-dir .
hf download kasparovabi/drama-3-tr-speaker trace_experts.pt --local-dir results
pip install torch triton-windows safetensors tokenizers soundfile omegaconf hydra-core scipy psutil einops einx loguru descript-audio-codec
합성할 문장은 문자열 목록을 담은 sentences.json에 넣고, 지시문은 터키어로 대괄호 안에 작성한다.
TTS_COMPILE=max-autotune-no-cudagraphs python engine.py --speaker speaker.safetensors --graph --slots 300 --disk --hot 6000 \\
 --ref my_voice.wav --ref_text my_voice.txt --sentences sentences.json --out out
--hot 6000은 터키어 프롬프트에서 자주 쓰는 전문가 6,000개를 고정 RAM에 보관하며, 이를 위해 18.6GB가 필요하다. RAM이 32GB보다 적은 시스템에서는 이 옵션을 빼면 모든 전문가를 드라이브에서 읽는다. TTS_COMPILE은 CUDA 그래프에 담기 전에 프레임별 처리를 컴파일해 시작 시간을 몇 분 늘린다. 선택 기능인 TTS_FP8=1은 어텐션, DeltaNet, 오디오 디코더 가중치를 블록 FP8로 저장한다. 제작자의 실행에서는 약 8% 빨라졌지만 Freya-TR-Eval WER가 3.29%로 올라 기본 설정에서는 꺼져 있다.
저장소에는 HTTP 서버와 스트리밍 재생 데모도 포함됐다. server.py는 POST /tts 요청을 받아 기본적으로 16kHz PCM을 반환하며, "format": "wav"를 지정하면 44.1kHz WAV를 반환한다. streaming_demo.py는 프레임 생성 중에 오디오를 디코딩해 재생하는 방식을 보여준다. 평가를 재현하려면 FreyaTTS 저장소의 eval/benchmark.py와 freya-tr-eval 데이터셋을 준비한 뒤 495개 문장을 생성하고 점수를 계산한다.
제작자는 첫 릴리스의 짧은 문장 처리 속도가 디스크 모드에서 실시간의 0.86배였으며, 프레임별 처리에 torch.compile과 CUDA 그래프를 적용하고 오디오 헤드가 사용할 수 있는 4,097개 토큰만 계산하는 등의 변경으로 약 2.7배까지 높였다고 설명한다. 터키어 문장 300개에서 자주 쓰인 전문가 6,000개를 RAM에 보관한 것도 속도 개선에 포함됐다. 반면 다음 계층의 전문가를 미리 불러오는 방법은 잘못된 예측이 필요한 전문가를 밀어내 읽기 속도를 낮췄다. pin_memory=True도 18.6GB hot tier 할당을 32GB로 올려, 제작자는 cudaHostRegister로 바꿨다고 밝혔다.
감정 강도를 연속적으로 조절하는 실험 기능도 있다. 제작자는 지시가 있는 프롬프트와 없는 프롬프트의 은닉 상태 차이를 특정 계층 출력에 더하는 방식으로 속삭임과 흥분의 음높이·에너지를 조절했다고 설명한다. 슬픔은 실제 지시만큼 크게 바뀌지는 않았지만 참조 음성에 더 가까운 목소리를 유지했다. 이 기능은 steer_act.py에 있으며, 별도 선택 기능인 FP8 경로는 프레임 시간을 줄이는 대신 WER를 약 1%포인트 높여 기본값에서 제외됐다.
화자 모델 가중치와 전체 결과는 Hugging Face 저장소에서 제공한다. 제작 과정은 dev.to 글과 터키어 Medium 글에 설명돼 있다. 이 프로젝트는 Fish Audio Drama 3와 fish-speech를 사용하며 Fish Audio와 제휴하거나 승인을 받은 프로젝트는 아니다. 저장소 코드는 Apache 2.0 라이선스지만, Hugging Face의 화자 가중치는 Drama 3의 파생물로 Fish Audio Community License v1.0을 따른다. 실제 인물의 목소리를 동의 없이 모방하는 데 사용하지 말라는 안내도 포함됐다. 제작자는 아흐메트 카잔카야(Ahmet Kazankaya)다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요