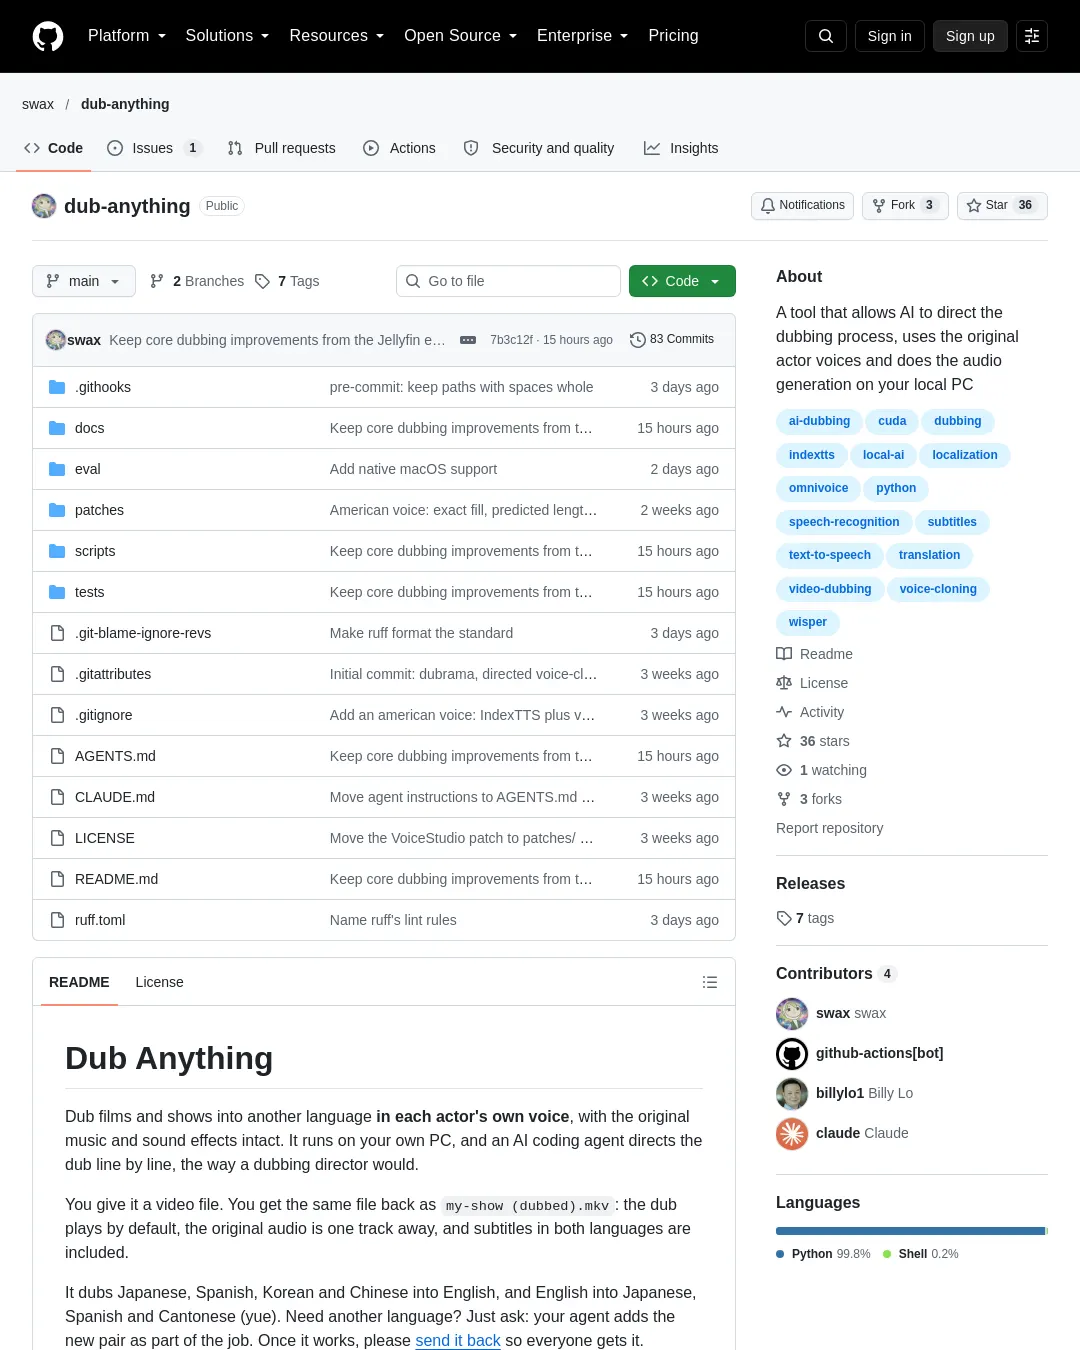
Dub Anything는 영화와 드라마를 다른 언어로 더빙하면서 배우마다 원래 목소리와 연기를 살리고, 음악과 효과음은 그대로 유지하는 도구다. Windows PC에서 실행하며 AI 코딩 에이전트가 더빙 감독처럼 대사 한 줄씩 작업을 지휘한다. GitHub 저장소
영상 파일을 입력하면 my-show (dubbed).mkv라는 결과 파일을 만든다. 더빙 음성이 기본으로 재생되고, 원본 음성은 다른 오디오 트랙에서 들을 수 있으며 두 언어의 자막도 포함된다.
일본어·스페인어·한국어·중국어 영상은 영어로, 영어 영상은 일본어와 스페인어로 더빙한다. 다른 언어가 필요하면 에이전트에게 요청해 작업 중에 언어 쌍을 추가할 수 있다. 추가한 언어 모듈과 설명을 저장소에 풀 리퀘스트로 보내면 다른 이용자도 사용할 수 있다.
데모와 주요 기능
저장소에는 일본 애니메이션과 일본 영화를 영어로 더빙한 데모가 있다.
대부분의 더빙 도구는 음성을 받아쓰고 번역한 뒤, 짧은 음성 클립으로 화자별 목소리를 복제하고, 길이가 맞지 않는 대사를 빠르게 재생하는 고정된 절차를 따른다. Dub Anything는 듣는 사람이 알아차릴 만한 부분을 에이전트가 대사별로 처리하도록 구성했다.
- 에이전트는 목소리 비교, 영상 프레임, 대사를 바탕으로 각 대사의 화자를 찾는다. 음성 인식이 잘못 들은 부분을 고치고, 배우의 말하는 속도에 맞춰 번역문 길이를 조정하며, 품질 검사에서 나온 문제를 처리한다. 확실하지 않은 대사는 숨기지 않고 추정이라고 표시한다.
- 복제한 목소리에는 배우가 해당 대사를 말한 원래 전달 방식을 참고하게 한다. 따라서 원래 고함을 지른 대사는 고함으로, 낮게 속삭인 대사는 낮게 표현하도록 설계했다.
- 각 대사는 원래 배우가 말하기를 멈추는 시점에 끝나도록 길이를 조정한다. 대사 사이에 불필요한 공백이 생기지 않도록 렌더링 전에 대사별 길이를 예측하고, 그 시간에 맞춰 번역문을 작성한다.
- 렌더링한 대사를 다시 음성 인식해 확인한다. 알아듣기 어려운 대사는 최대 세 차례 새로 생성하고 가장 나은 결과를 선택한다.
- 화면에 삽입된 자막을 대본으로 활용할 수 있으며, 자막에 화자 이름이 들어 있으면 화자 식별에도 쓸 수 있다. 타이틀 카드와 표지판 같은 화면 속 글자는 번역해 원문 옆에 표시되는 자막으로 넣을 수 있다.
- 대사 사이에는 원래 사운드트랙이 들린다. 따라서 노래와 웃음소리, 이름은 원래 배우의 음성으로 남는다.
- 기본 설정은 여러 대안을 나란히 듣고 골랐다. 측정한 항목과 결과는 docs/research.md에 공개돼 있다.
필요한 장비와 시작 방법
필요한 것은 메모리가 6GB 이상인 엔비디아 GPU를 탑재한 Windows PC다. 16GB 그래픽 카드를 사용하면 모든 작업을 한꺼번에 실행할 수 있다. 리눅스 이식은 비교적 짧은 작업일 것으로 보고 있으며, 자세한 설명은 언어와 하드웨어 안내에 있다.
VoiceStudio와 모델, 도구별 실행 환경을 위해 약 40GB의 디스크 공간이 필요하다. 작업 공간도 따로 확보해야 한다. 영화 한 편을 두 가지 음성으로 처리했을 때 정리하기 전까지 약 85GB를 사용했다.
AGENTS.md를 읽을 수 있는 AI 코딩 에이전트가 필요하다. 예시로 Claude Code, Codex, Cursor 등이 제시돼 있다. Dub Anything가 제어하는 오픈소스 음성 엔진 VoiceStudio도 필요하며, 설치 안내에서 함께 설치한다. VoiceStudio
설치와 이용 절차는 다음과 같다.
- docs/setup.md의 안내에 따라 VoiceStudio, 모델, ffmpeg, uv를 한 번 설치한다.
- 저장소 폴더를 에이전트에서 열고
Dub D:\movies\my-show.mkv into English.와 같이 요청한다. - 에이전트가 목소리를 물으면 선택한다. 목소리 선택 안내에 설명돼 있다. 일본어나 스페인어로 더빙할 때는 선택할 필요가 없다.
- 에이전트가 작업을 진행한다. 기계 작업은 영상 분리, 받아쓰기, 렌더링, 확인을 수행하고, 에이전트는 각 부분의 초안이 준비되는 대로 작업을 지휘한다. 사람의 확인이 필요한 부분이 있으면 알려준다.
- 작업이 끝나면 더빙 파일과 확인이 필요한 장면의 시각을 짧게 정리한 목록을 받는다. 수정할 내용을 에이전트에게 알려주면 해당 부분만 다시 렌더링한다.
에이전트는 소리를 들을 수 없으므로 연기와 목소리, 믹스의 적절성은 이용자가 직접 판단해야 한다. 어떤 목소리를 복제하거나 공유해도 되는지도 이용자가 결정한다.
목소리 선택과 처리 시간
목소리는 배우의 목소리를 기본으로 쓰거나, 미국식 영어 음성을 사용할 수 있다. 배우 목소리 방식은 배우의 억양을 살려 영어를 말하게 하며 실사 영상에 적합하다. 미국식 영어 방식은 자연스러운 미국식 영어 음성을 배우의 목소리에 가깝게 변환하며 애니메이션에 적합하다.
배우 목소리 방식은 영어에 억양이 남을 수 있다. 미국식 영어 방식은 실사 배우와 목소리가 덜 비슷하고 연기가 다소 덜 살아날 수 있으며, 렌더링에 몇 배 더 걸리는 경우가 있다. 어느 쪽을 고를지 모르겠다면 두 방식 모두 요청할 수 있다. 결과마다 별도 오디오 트랙이 생기며 재생기에서 전환할 수 있고, 배우 목소리 트랙이 기본으로 재생된다. 미국식 영어 음성은 현재까지 일본어 원본에 사용됐다.
일본어나 스페인어로 더빙할 때는 배우 목소리 방식만 제공된다. 배우마다 자기 억양을 살려 새 언어로 말한다.
짧은 영상은 몇 분이면 처리된다. RTX 4090 노트북에서 영화 한 편을 두 가지 음성으로 처리하는 데 기계 작업 시간으로 약 7시간이 걸렸고, 대부분은 GPU에서 실행됐다. 배우 목소리 방식만 사용하면 그 절반 정도가 걸린다. 렌더링이 진행되는 동안 에이전트가 작업을 지휘하며, 긴 영상에서는 보조 에이전트에 지휘 작업을 나눌 수 있다.
개인정보와 책임 있는 사용
영상과 음성은 이용자의 컴퓨터에 남는다. 모델은 로컬에서 실행되며 인터넷은 모델을 내려받을 때만 사용한다. 다만 에이전트는 대본과 자신이 살펴보는 영상 프레임을 읽으므로, 이 자료는 에이전트의 모델이 실행되는 곳으로 전달된다.
권리를 가진 미디어만 더빙하고, 해당 이용에 필요한 동의를 받은 목소리만 복제해야 한다. 다른 사람의 영화나 목소리로 만든 더빙은 허가가 없는 한 개인적인 용도로만 사용해야 한다.
처리 과정
전체 과정은 다음과 같다.
- 영상을 약 3분 길이의 구간으로 나누되, 말이 멈추는 지점을 경계로 삼는다.
- Mel-Band Roformer로 목소리를 음악과 효과음에서 분리한다.
- 각 구간을 Whisper large-v3로 받아쓰고, 두 개의 다른 음성 인식기로 결과를 교차 확인한다. 화면에 삽입된 자막이 있으면 함께 활용한다.
- 전체 영상에서 목소리를 비교하고 영상 프레임과 대조해 각 대사의 화자를 지정한다.
- 에이전트가 대본을 바로잡고 번역하며 각 대사의 길이를 배우의 말하기 시간에 맞춘다.
- 대사마다 음성을 만든다. 배우 목소리 방식은 OmniVoice가 배우를 복제하고 해당 대사의 원래 전달 방식을 참고한다. 미국식 영어 방식은 IndexTTS가 배우의 전달 방식에 맞춰 자연스러운 영어 음성을 만들고, Chatterbox가 이를 배우의 음색으로 변환한다.
- 각 음성의 길이를 배우가 말하기를 멈추는 시점에 맞춰 조정하고 원래 배경음 위에 믹스한다. 다시 받아쓰기해 알아듣기 어려운 단어가 있는지 확인한다.
- 결과를 영상 파일에 넣는다. 영상은 다시 인코딩하지 않으며, 원본 파일을 교체하기 전에 모든 스트림을 원본과 대조한다.
전체 처리 과정을 그린 다이어그램은 docs/process.png에서 볼 수 있다. 다이어그램의 원본은 docs/process.jg이며, Jumpgate 파일이다. Jumpgate의 packages/jumpgate 디렉터리에서 다음 명령으로 렌더링한다.
npm run render -- <path>/docs/process.jg --width 1800 --height 2700
에이전트 없이 실행하기
스크립트는 일반 Python으로 작성돼 있어 더빙을 직접 진행하고 지휘용 스크립트도 손으로 작성할 수 있다. VoiceStudio의 Python을 사용하는 예시는 다음과 같다. scripts/dub_anything.py는 전체 더빙의 기계 작업을 실행한다.
$py = "C:\git\VoiceStudio\.venv\Scripts\python.exe"
& $py scripts\dub_anything.py new D:\movies\my-show.mkv --voices both # a job named my_show
& $py scripts\dub_anything.py run my_show --watch # prep, then render each part marked ready
# write work\my_show-NN\script.json for each part, then:
& $py scripts\dub_anything.py ready my_show 01
& $py scripts\dub_anything.py status my_show
각 단계를 따로 실행할 수도 있다. 백엔드를 실행한 상태에서 다음 명령을 사용한다.
& $py scripts\backend.py start
& $py scripts\split.py videos\episode.mkv # long video -> parts at pauses
& $py scripts\dub.py prep videos\episode-parts\episode-01.mp4 # upload, separate, transcribe
& $py scripts\draft.py episode-01 # careful transcript, suggested cast
# write work\episode-01\script.json and the cast in work\voices.json
& $py scripts\dub.py generate episode-01 --match-level # clone, time, mix, export
& $py scripts\lineqa.py episode-01 # check each rendered line
& $py scripts\assemble.py episode --parts 1-4 # one video with both audio tracks
& $py scripts\deliver.py D:\movies\episode.mkv actor=videos\episode-parts\dubbed\episode.dubbed.mp4
separate.py, subs.py, second.py 등 일부 단계는 별도의 실행 환경이 필요하다. 자세한 내용은 AGENTS.md에 있다. 작업 흐름과 스크립트 형식, 각 도구 설명은 docs/directing.md에서 확인할 수 있다.
언어와 하드웨어 확장
아직 지원하지 않는 언어 쌍을 요청하면 에이전트가 작업의 일부로 추가할 수 있다. VoiceStudio는 수백 개 언어의 목소리를 복제할 수 있다. 언어별로 새로 필요한 것은 해당 언어를 처리하는 스크립트다. 여기에는 Whisper가 그 언어에서 잘못 인식하는 표현, 교차 확인에 쓸 음성 인식기, 품질 검사에서 결과를 대사와 비교하는 방법이 들어간다. 이 내용은 scripts/languages/<code>.py 모듈에 둔다.
에이전트는 모듈을 작성한 뒤 짧은 시험 더빙으로 언어 쌍을 확인하고 추가한다. 절차는 언어별 안내에 설명돼 있다. 새 언어를 추가했다면 모듈과 설명 파일(docs/languages/<code>.md), PAIRS의 언어 쌍 항목을 포함해 풀 리퀘스트를 보내면 다른 이용자가 바로 쓸 수 있다.
모델은 CUDA에서 실행되며 CUDA가 없으면 대부분 CPU로 전환되지만 속도가 훨씬 느려진다. 영상 인코딩에는 NVENC가 있으면 이를 사용하고, 없으면 x264를 쓴다. 백엔드 실행, GPU 잠금, cuDNN 우회 처리 등 Windows 전용 부분은 이미 플랫폼을 확인한다. 저장소는 엔비디아 GPU를 사용하는 리눅스 환경이 가장 짧은 이식 작업 대상일 것으로 설명한다.
기여와 기반 기술
버그 제보와 아이디어, 풀 리퀘스트를 받으며 특히 새 언어 추가를 환영한다. 각 구성 요소가 함께 작동하는 방식은 docs/directing.md에 나와 있다. Python 코드는 ruff로 포맷하고 검사한다. docs/setup.md에는 사전 커밋 검사 설정 방법이 있다.
videos/와 work/는 Git에서 무시하도록 설정돼 있어 원본 미디어, 대본, 목소리 참고 자료가 저장소에 포함되지 않는다. 이 파일들을 강제로 추가하지 말고, 문서와 커밋 메시지에는 지어낸 예시를 사용해야 한다.
Dub Anything는 여러 오픈소스 프로젝트를 연결하고 더빙 작업을 지휘한다.
- VoiceStudio: 음성 백엔드로 더빙 작업, 음성 복제, 믹싱을 담당한다.
- OmniVoice: 배우 목소리 복제에 사용한다.
- IndexTTS: 미국식 영어 음성을 만든다.
- Chatterbox: 음성을 배우의 음색으로 변환한다.
- Whisper는 faster-whisper를 통해 받아쓰기에 사용한다.
- pyannote와 WeSpeaker는 화자가 말한 시점과 목소리 비교에 사용한다.
- Silero VAD는 실제 발화의 시작과 끝을 찾는다.
- Mel-Band Roformer는 python-audio-separator를 통해 목소리와 음악을 분리한다.
- sherpa-onnx는 교차 확인용 음성 인식기를 제공한다.
- RapidOCR과 PaddleOCR의 PP-OCRv5는 자막과 표지판을 읽는다.
- FFmpeg는 영상 자르기, 믹싱, 스트림 합치기에 사용한다.
라이선스
Dub Anything는 MIT 라이선스다(LICENSE). VoiceStudio와 HTTP로 통신하며 VoiceStudio 코드는 포함하지 않는다. VoiceStudio는 AGPL-3.0이며, VoiceStudio 소스에 적용하는 변경 사항인 patches/voicestudio-local-fixes.patch도 AGPL-3.0이다.
각 모델에는 별도 라이선스가 있다. pyannote는 Hugging Face에서 접근 승인을 받아야 하며, Sortformer 가중치는 CC-BY-NC, Chatterbox는 MIT 라이선스다. 상업적으로 사용하기 전에 각 라이선스를 확인해야 한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요