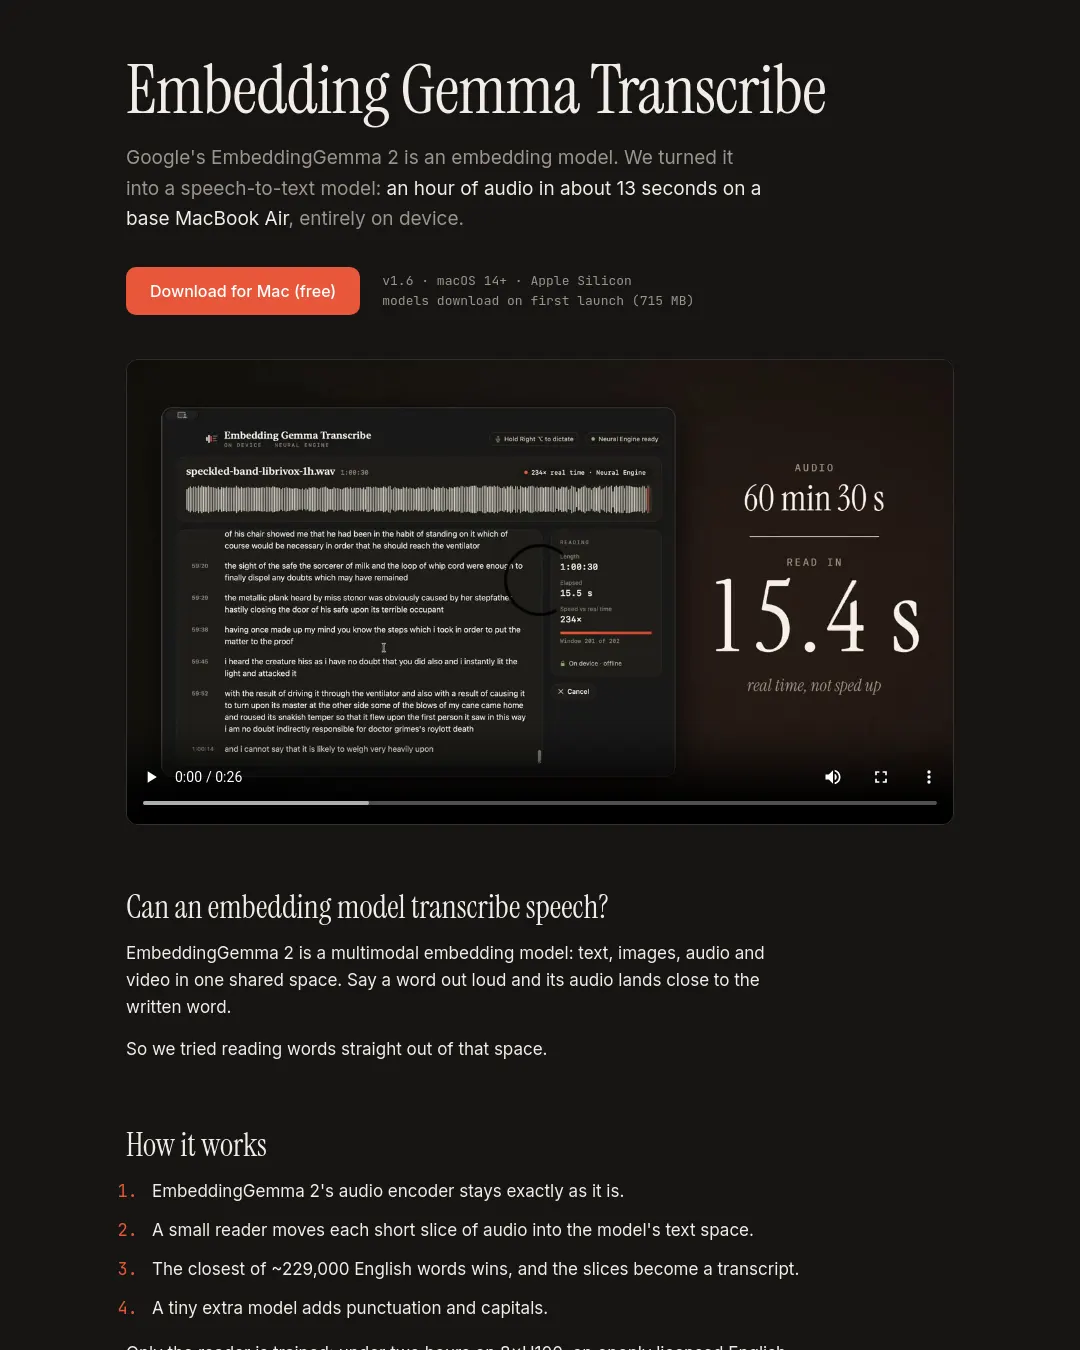
Embedding Gemma Transcribe는 구글의 임베딩 모델 EmbeddingGemma 2를 음성 받아쓰기 도구로 바꾼 앱이다. 제작자에 따르면 기본형 M3 MacBook Air에서 한 시간 분량의 음성을 약 13초 만에 처리하며, 오디오는 기기 밖으로 전송되지 않는다.
맥용 앱은 무료이며 macOS 14 이상과 Apple Silicon이 필요하다. 모델은 첫 실행 때 다운로드되며 용량은 715MB다. 오디오 파일을 앱에 넣거나 Right Option 키를 누른 채 말한 뒤 키를 놓으면 어느 앱에서나 받아쓸 수 있다. 처리는 맥의 Neural Engine에서 이뤄진다.
EmbeddingGemma 2는 텍스트·이미지·오디오·비디오를 하나의 공간에 표현하는 멀티모달 임베딩 모델이다. 제작자는 음성 인코더는 그대로 두고, 짧은 오디오 조각을 텍스트 공간으로 옮기는 작은 판독기를 학습시켰다. 약 22만 9,000개의 영어 단어 가운데 가장 가까운 단어를 골라 문장을 만들고, 별도 소형 모델이 문장부호와 대문자를 추가한다. 판독기는 공개 라이선스가 적용된 영어 음성으로 8대의 H100에서 2시간 이내 학습했다. 기반 모델 자체는 음성 인식용으로 학습되지 않았다.
제작자가 공개한 처리 속도 비교는 다음과 같다. 실시간 배수는 처리 1초당 처리할 수 있는 오디오 초 수를 뜻한다.
| 모델 | 처리 장치·맥 | 실시간 배수 | 한 시간 음성 처리 시간 |
|---|---|---|---|
| Embedding Gemma Transcribe | Neural Engine, 기본형 M3 MacBook Air 8GB | 288배 | 12.6초 |
| IBM Granite Speech 5.0 Turbo | MLX GPU, 기본형 M3 MacBook Air 8GB | 약 150배 | 25.7초 |
| NVIDIA Parakeet TDT 0.6B v3 (FluidAudio) | Neural Engine, M4 Pro | 156배 | 원문에 없음 |
| NVIDIA Parakeet TDT 0.6B v3 (FluidAudio) | Neural Engine, M5 Pro | 335배 | 원문에 없음 |
| Phonon-2, Parakeet v3 미세 조정 모델 (FluidAudio) | Neural Engine, M5 Pro | 480배 | 원문에 없음 |
앞의 두 결과는 같은 기본형 M3 MacBook Air에서 진행한 자체 테스트다. 나머지는 더 최신·고성능 맥과 서로 다른 오디오를 사용한 FluidAudio의 공개 벤치마크다. 따라서 제작자는 이 수치를 대략적인 참고 자료로 제시하며 직접 비교 순위로 보기는 어렵다고 밝혔다.
현재 단어 오류율은 약 5%로, 제작자가 언급한 주요 음성 모델의 2~3%보다 높다. 제작자는 판독기를 더 잘 학습시키면 격차를 줄일 수 있다고 보고 있으며, 이를 다음 개선 단계로 제시했다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요