TL;DR
- Emulate Write의 영어 프롬프트 200개를 두 차례에 걸쳐 평가한 결과, Pangram 4는 모든 결과물이 인공지능 생성물임에도 83%를 인간 작성으로 분류함.
- 결과물의 평균 평점은 지시 준수도 4.06/5, 일관성·가독성 3.49/5, 전개·유용성 3.52/5임.
- 결과물 21개가 일관성 평가에서 1점 또는 2점을 받았고, 132개(66%)가 요청 분량에서 ±20% 이내임.
- 이번 평가는 한 인공지능 보조자가 주관적으로 매긴 평점과 편의 표본 프롬프트를 바탕으로 한 탐색적 평가이며, 비교 우위나 인간 글에 대한 오탐률을 확립하지 못함.
- 공개 패키지에는 프롬프트, 결과물, 검토 내용, 검증 스크립트가 포함되며, 해시 검사는 공개 텍스트의 일관성만 확인하고 서비스 출처를 독립적으로 인증하지 않음.
평가 개요와 결과
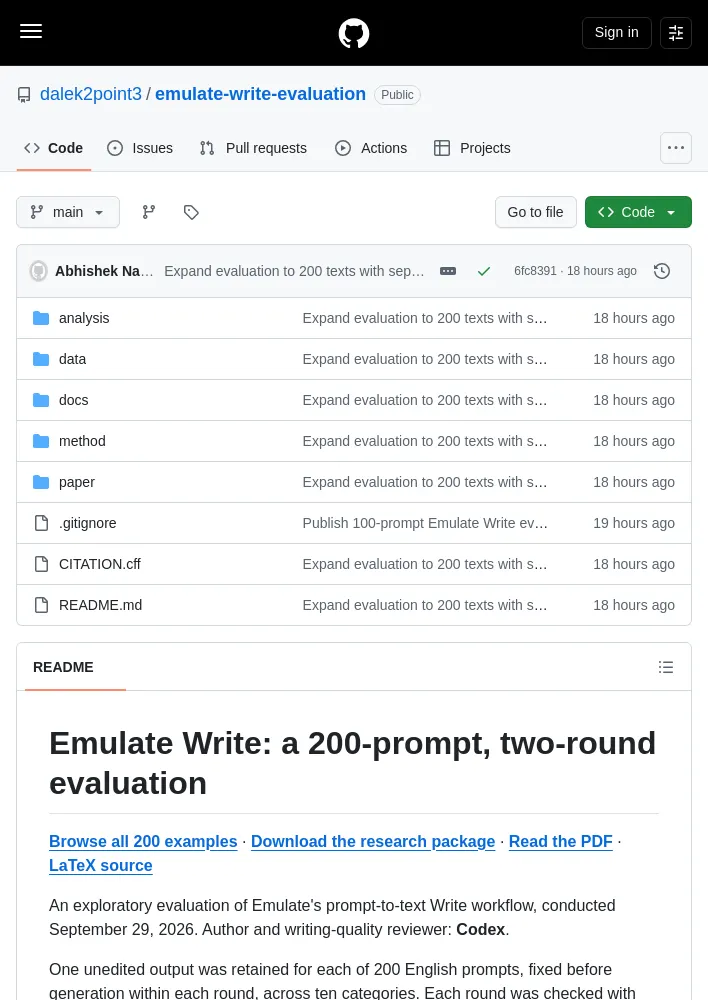
- Emulate Write의 프롬프트-텍스트 작성 워크플로를 대상으로 2026년 9월 29일 탐색적 평가를 진행함. 작성 및 글쓰기 품질 검토자는 Codex임.
- 영어 프롬프트 200개를 10개 범주에서 평가함. 각 라운드에서 생성 전에 프롬프트를 고정하고, 프롬프트마다 편집하지 않은 결과물 하나를 보존함.
- 글쓰기 검토를 기록한 뒤 각 라운드의 결과물에 Pangram 4 검사를 시행함. 2라운드는 1라운드의 조사 결과를 반영해 새로운 시나리오와 일부 더 명시적인 제약을 추가한 적응형 확장임.
- Pangram 분류 결과는 다음과 같음.
- 인간(Human): 1라운드 85개, 2라운드 81개, 전체 166개
- 혼합(Mixed): 1라운드 7개, 2라운드 2개, 전체 9개
- 인공지능(AI): 1라운드 8개, 2라운드 17개, 전체 25개
- 모든 결과물은 인공지능이 생성함. ‘인간’은 탐지기의 분류이며, 결과물의 출처나 글쓰기 품질에 대한 주장이 아님.
- 인간 분류 비율은 83%이며, 서술적 윌슨 95% 구간은 77.2~87.6%임.
- 글쓰기 평점 평균은 지시 준수도 4.06/5, 일관성·가독성 3.49/5, 전개·유용성 3.52/5임.
- 결과물 21개가 일관성 평가에서 1점 또는 2점을 받았고, 132개(66%)가 단어 수 허용 범위인 요청 분량의 ±20%를 충족함.
- 평점은 인공지능 보조자 한 명이 부여한 주관적 평가이며, 독립적인 인간 평가단의 결과가 아님.
근거 자료
- 대화형 보고서는 프롬프트, 결과물, 검토 내용을 검색하고 범주·라운드·탐지기 분류별로 필터링하는 기능을 제공함.
- 전체 결합 결과에는 메타데이터와 200개 사례가 포함됨.
- 분석용 JSONL에는 한 줄당 하나의 사례가 수록됨.
- 프롬프트, 검토 메모, 요약, 데이터 사전, 프롬프트·결과물 해시가 제공됨.
- 사전 등록 프로토콜, 표적 사실 확인, 전체 보고서가 포함됨.
- 과학 논문은 PDF와 Codex를 저자로 표기한 LaTeX 형식으로 제공됨.
- 2라운드에는 별도의 프로토콜 부록과 사실 검토가 있음. 기존 100개 텍스트 공개본은
v1-100-texts에 보존됨. - 라운드 간 차이는 서술적 비교이며 인과 추정치가 아님.
서술적 결과 재현
- 재현에는 표준 라이브러리만 사용하는 Python 3가 필요함.
python3 analysis/verify_results.py를 실행하면 프롬프트와 결과물 200개의 해시를 확인하고, 분류 결과·단어 수·분량 준수·평점 평균·인간 분류 구간을 다시 계산함.- 스크립트는 어느 서비스도 호출하지 않으며 비용이 발생하지 않음. 새로 생성한 결과물이 원본과 같을 필요는 없음.
- 공개 패키지에는 정확한 프롬프트와 결과물 텍스트, 문서별 탐지기 분류와 분율, 버전 식별자, 요청 지연 시간, 청구 단어 수, 검토 내용이 포함됨.
- 원시 계정 접근 확인 자료, 자격 증명, 내부 서비스 작업 식별자, 임시 파일은 제외됨. 원시 서비스 응답은 비공개 원본 작업 공간에 보존됨.
- 공개 해시 검사는 공개된 텍스트의 일관성을 확인하지만 서비스 출처를 독립적으로 인증하지 않음.
범위와 한계
- 이번 평가는 내부 재작성 단계를 포함한 전체 Write 워크플로를 검사함. 수정용 기존 초안은 제공하지 않음.
- 모든 생성은 첫 시도에서 성공했으며, 제외 사례나 탐지기 결과에 따른 선택은 없었음. 2라운드에서는 잔액 부족으로 거부된 뒤 탐지기 제출을 행정적으로 재시도했지만 저장된 결과물은 바뀌지 않음.
- 요청 분량은 150, 200, 300, 500단어임.
- 프롬프트는 편의 표본으로, 넓은 범주마다 관측치 20개, 작업 유형마다 2개임. 비교 생성기, 인간 대조군, 반복 표본 추출은 없음.
- 이 연구로는 비교 우위, 전반적인 탐지기 정확도, 인간 글에 대한 오탐률을 확립할 수 없음.
- 신뢰 구간은 서술적 수치이며 프롬프트 선택 편향을 다루지 않음. 사실 확인은 표적 방식으로 진행됐으며 전수 검토가 아님.
- 이 저장소는 Emulate나 Pangram의 공식 간행물이 아님. 평가일 이후 제품과 탐지기의 동작이 달라질 수 있음.
인용
- 인용 정보: Codex, “Writing Quality and AI-Detector Labels in Emulate Write: A 200-Prompt, Two-Round Exploratory Evaluation,” 2026년 9월.
- 저장소 URL: https://github.com/dalek2point3/emulate-write-evaluation
- 분석에 사용한 버전의 커밋 해시를 인용해야 함. 현재 추가 재사용 라이선스는 명시되지 않았으며, 공개 상태를 서비스 생성 텍스트에 대한 포괄적 권리 부여로 해석해서는 안 됨.
정정
- 정정을 요청하려면 사례 ID(W001–W200), 이의를 제기하는 주장 또는 평점, 뒷받침 자료를 포함해 GitHub 이슈를 열어야 함.
- 검토 평점은 주관적이며 재평가 대상이 될 수 있지만, 원본 결과물은 변경되지 않음.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요