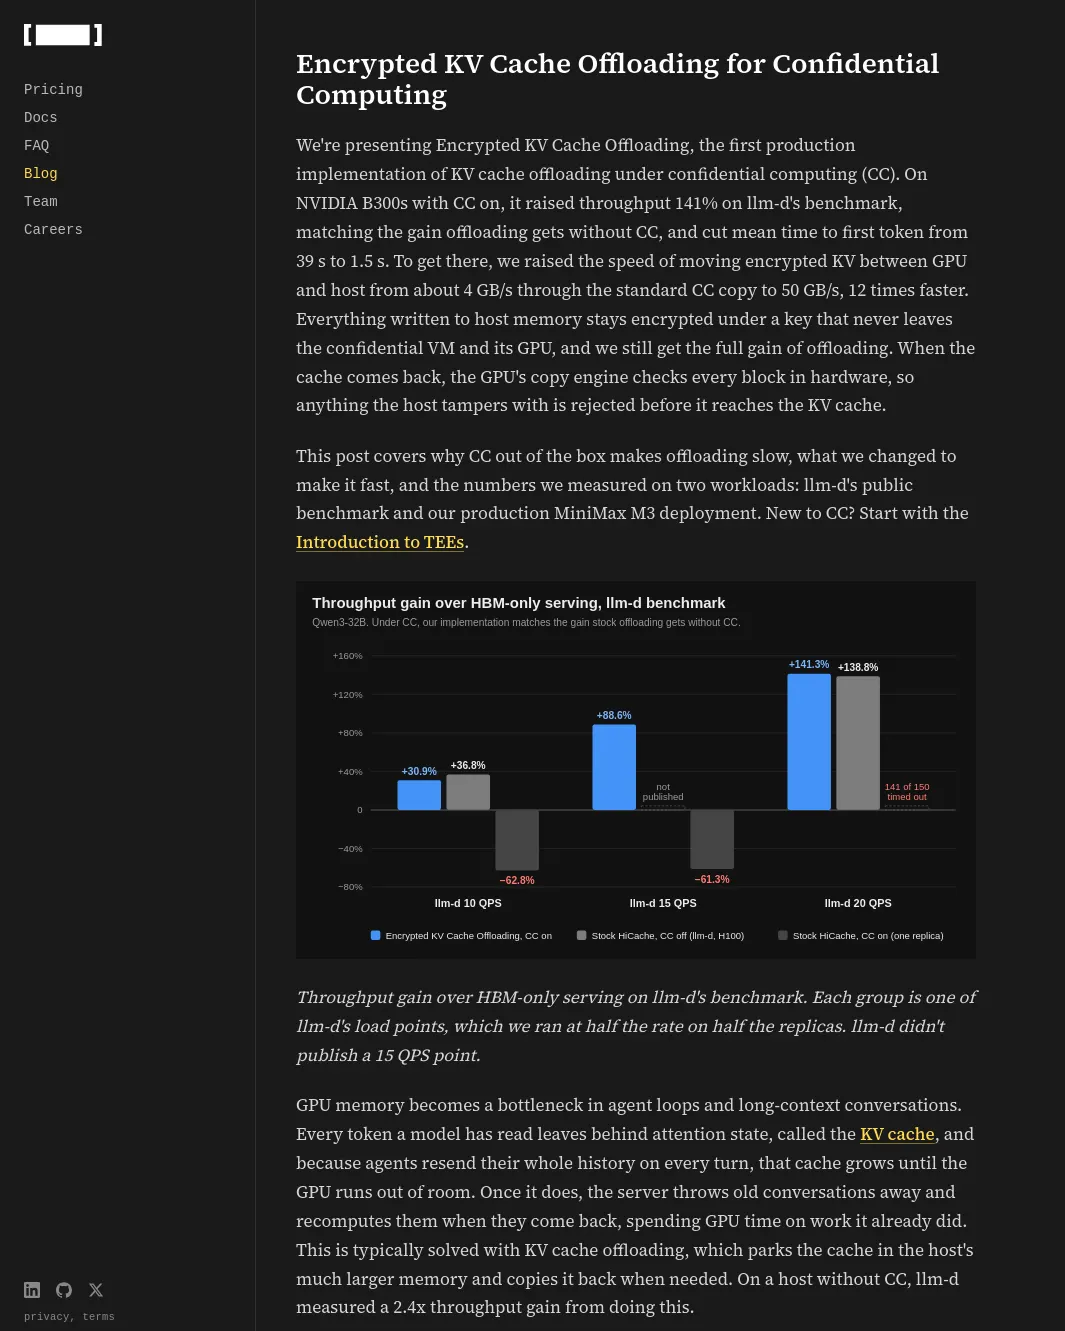
Confidential.ai는 기밀 컴퓨팅(CC) 환경에서 KV 캐시 오프로딩을 구현해, NVIDIA B300에서 llm-d 벤치마크 기준 처리량을 오프로딩을 쓰지 않을 때보다 141% 높였다고 밝혔다. 호스트 메모리에 저장되는 캐시는 암호화되며, 복원 과정에서 GPU 복사 엔진이 블록 무결성을 하드웨어로 확인한다.
KV 캐시는 모델이 읽은 토큰의 어텐션 상태를 저장한다. 에이전트가 매 대화 차례마다 전체 기록을 다시 보내면 캐시가 커져 GPU 메모리를 채울 수 있다. 캐시를 호스트 메모리로 옮겼다가 필요할 때 복원하는 오프로딩은 이 문제를 줄인다. 그러나 기밀 컴퓨팅에서는 신뢰 경계 밖의 호스트 메모리에 캐시를 평문으로 저장할 수 없다. 기존 방식은 GPU와 CPU 사이의 전송에 암호화된 임시 버퍼를 거치며, Confidential.ai는 이 과정이 오프로딩의 이점을 상쇄한다고 설명한다.
암호화 전송 방식과 벤치마크
기존 기밀 컴퓨팅 복사 경로에서 GPU와 호스트 사이의 전송 속도는 단일 프로세스 기준 초당 약 4GB였다. 새 구현은 GPU가 KV 캐시를 호스트로 보내기 전에 암호화해 초당 50GB로 전송한다고 밝혔다. 암호화 키는 기밀 가상 머신 안에서 생성되며 가상 머신과 GPU 밖으로 나가지 않는다. CPU는 KV 데이터를 읽거나 쓰지 않는다. 캐시를 복원할 때 GPU 복사 엔진이 각 블록의 무결성을 확인하고, 호스트에서 변경되거나 교체된 블록은 KV 캐시에 들어가기 전에 거부한다.
llm-d의 공개 벤치마크는 Qwen3-32B와 SGLang을 사용해 계층형 프리픽스 캐시 오프로딩과 GPU 메모리만 사용하는 방식을 비교했다. 원래 벤치마크는 H100 두 개를 탑재한 서버 8대에서 기밀 컴퓨팅 없이 실행됐다. Confidential.ai는 Intel TDX 기밀 가상 머신 안의 B300 단일 GPU 복제본 4개에서 두 설정 모두 기밀 컴퓨팅을 켜고 시험했다. 부하 지점마다 llm-d가 사용한 요청률과 프리픽스 그룹의 절반을 적용했으며, GPU 캐시 크기는 복제본당 321,856토큰, 호스트 캐시는 그 2.4배로 설정했다.
이 조건에서 새 구현은 20 QPS 지점의 처리량을 GPU 메모리만 사용하는 방식보다 141.3% 높였다. 기밀 컴퓨팅을 끈 llm-d의 오프로딩 증가율은 138.8%였다. 반면 기존 오프로딩은 기밀 컴퓨팅을 켰을 때 완료된 모든 부하 지점에서 처리량이 60% 넘게 감소했다. 20 QPS에서 새 구현은 평균 첫 토큰 대기 시간(TTFT)을 27배 줄였다. 기존 오프로딩과 비교하면 10 QPS에서 복제본당 처리량은 초당 5.4K에서 18.9K토큰으로, 15 QPS에서는 초당 6.0K에서 29.0K토큰으로 늘었다. 평균 TTFT는 각각 42.1초에서 0.61초, 97.7초에서 0.34초로 줄었다.
MiniMax M3 운영 환경 측정
Confidential.ai는 B300에서 TP4로 구동하는 MiniMax M3 운영 배포에도 이 방식을 적용했다. GPU 메모리에는 워커당 520만 토큰의 KV 캐시를 두고, 오프로딩으로 호스트 메모리에 780만 토큰을 추가했다. 별도 언급이 없으면 GPU 메모리가 부족해질 때 새 대화 기록을 호스트 메모리로 복사하는 쓰기 통과(write-through) 방식을 사용했다. 비교 대상 워커는 오프로딩 없이 같은 대화 재생 부하를 동시에 처리했다.
512개 대화와 동시에 처리 중인 요청 256개로 GPU 캐시를 채운 조건에서, 오프로딩 적용 워커는 미적용 워커보다 출력량이 3.15배 많았다. 프롬프트 토큰의 95%를 캐시에서 제공했고, 돌아온 대화의 첫 토큰까지 걸리는 중앙값은 86초에서 26초로 줄었다. 같은 조건에서 기밀 컴퓨팅을 끈 기존 HiCache는 3.1배 증가를 기록했다.
400개 대화를 유지하고 워커당 동시 요청을 최대 80개로 제한한 측정에서는 대화 차례 사이의 대기 시간을 바꿔 부하를 조절했다. 각 지점의 수치는 오프로딩 적용/미적용 순서다.
- 240초 간격: 초당 요청 1.69/1.68, 중앙값 TTFT 0.68/0.89초, 99백분위 TTFT 1.16/2.36초, 캐시된 프롬프트 토큰 94%/71%.
- 180초 간격: 초당 요청 2.19/2.18, 중앙값 TTFT 0.75/1.28초, 99백분위 TTFT 1.12/3.43초, 캐시된 프롬프트 토큰 96%/64%.
- 150초 간격: 초당 요청 2.58/2.32, 중앙값 TTFT 0.80/2.56초, 99백분위 TTFT 1.25/6.83초, 캐시된 프롬프트 토큰 96%/58%.
- 120초 간격: 초당 요청 2.85/2.09, 중앙값 TTFT 0.94/4.87초, 99백분위 TTFT 6.66/7.87초, 캐시된 프롬프트 토큰 88%/51%.
중앙값 TTFT 3초 이하, 동시 요청 최대 80개, 대기 슬롯을 기다리는 요청 비율 1% 이하를 목표로 삼았을 때 오프로딩 적용 워커는 초당 2.58건의 요청과 초당 646토큰의 출력을 처리했다. 99백분위 TTFT는 1.25초였다. 미적용 워커는 이 목표 안에서 초당 2.18건, 초당 515토큰이 최대였다. 회사는 요청 처리량 비율이 측정 지점 사이의 한계 때문에 1.11~1.31배 범위에 있다고 덧붙였다.
150초 간격에서 한 시간 동안 실행한 별도 측정은 쓰기 되돌림(write-back) 방식으로 진행했다. 이 방식은 대화 기록을 GPU 메모리나 호스트 메모리 중 한 곳에만 둔다. 오프로딩 적용 시 프롬프트 토큰의 86%를 캐시에서 제공했고, 미적용 시에는 39%였다. 요청 수는 1.38배, 출력량은 1.37배였으며, 처리량은 초당 656토큰 대 477토큰, 중앙값 TTFT는 2.3초 대 5.0초였다.
작업 집합이 GPU 메모리에 들어가는 경우에는 오프로딩의 이점이 없다. 이 조건에서 새 구현은 미적용 워커보다 4.5~6.5% 낮은 성능을 보였다. 회사가 앞서 같은 작업 부하에서 측정한 기밀 컴퓨팅 미사용 HiCache는 자체 오프로딩 미사용 기준보다 27% 낮았다.
성능 개선 과정과 한계
첫 구현은 MiniMax M3에서 기밀 컴퓨팅을 켠 기존 HiCache보다 출력량이 4.14배 많았지만, 작업 집합이 GPU 메모리에 들어가는 경우 오프로딩을 쓰지 않을 때보다 39% 느렸다. Confidential.ai는 CPU와 GPU 사이의 왕복 호출을 줄여 이 차이를 개선했다고 밝혔다. 그 결과 GPU 메모리에 작업 집합이 들어갈 때 처리량은 45%, 캐시가 가득 찼을 때는 54% 높아졌고, 복원 시간 중앙값은 약 1초에서 88밀리초로 줄었다. GPU 메모리에 작업 집합이 들어갈 때의 성능 저하는 최소 4.5%까지 낮아졌다. 회사가 든 별도 예시에서는 커널 100개를 하나씩 실행할 때 2,833마이크로초가 걸렸고, 이를 하나의 CUDA 그래프에 담았을 때는 147마이크로초가 걸렸다.
이번 측정은 Intel TDX 기밀 가상 머신에서 NVIDIA B300을 사용했다. AMD SEV-SNP에서는 아직 시험하지 않았다. 호스트는 KV 내용은 볼 수 없지만 블록 크기와 기록·복원 시점을 볼 수 있어 대화 길이, 사용자의 재접속 시점, 같은 프리픽스를 공유하는 요청을 추정할 수 있다. Confidential.ai는 이런 접근 패턴을 숨기지 않으며, KV 캐시 공유의 타이밍 부채널이 다중 사용자 서비스에서 프롬프트를 유출할 수 있다는 연구가 이미 있다고 설명한다.
호스트는 블록을 삭제할 수 있다. 이는 캐시 적중을 재계산으로 바꾸지만, 가용성은 기밀 컴퓨팅이 보호하는 범위 밖이다. 무결성 검사에 실패한 블록이 있으면 잘못된 데이터를 제공하는 대신 서버가 중단된다.
관련 자료: llm-d의 Qwen3-32B 오프로딩 결과, llm-d 계층형 프리픽스 캐시 가이드, SGLang HiCache, PagedAttention 기반 대규모 언어 모델 서빙 메모리 관리 논문, NVIDIA Blackwell GPU의 기밀 컴퓨팅 성능 벤치마크, NVIDIA 기밀 컴퓨팅 문서, TEE 소개, 비공개 AI 추론에 필요한 것.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요