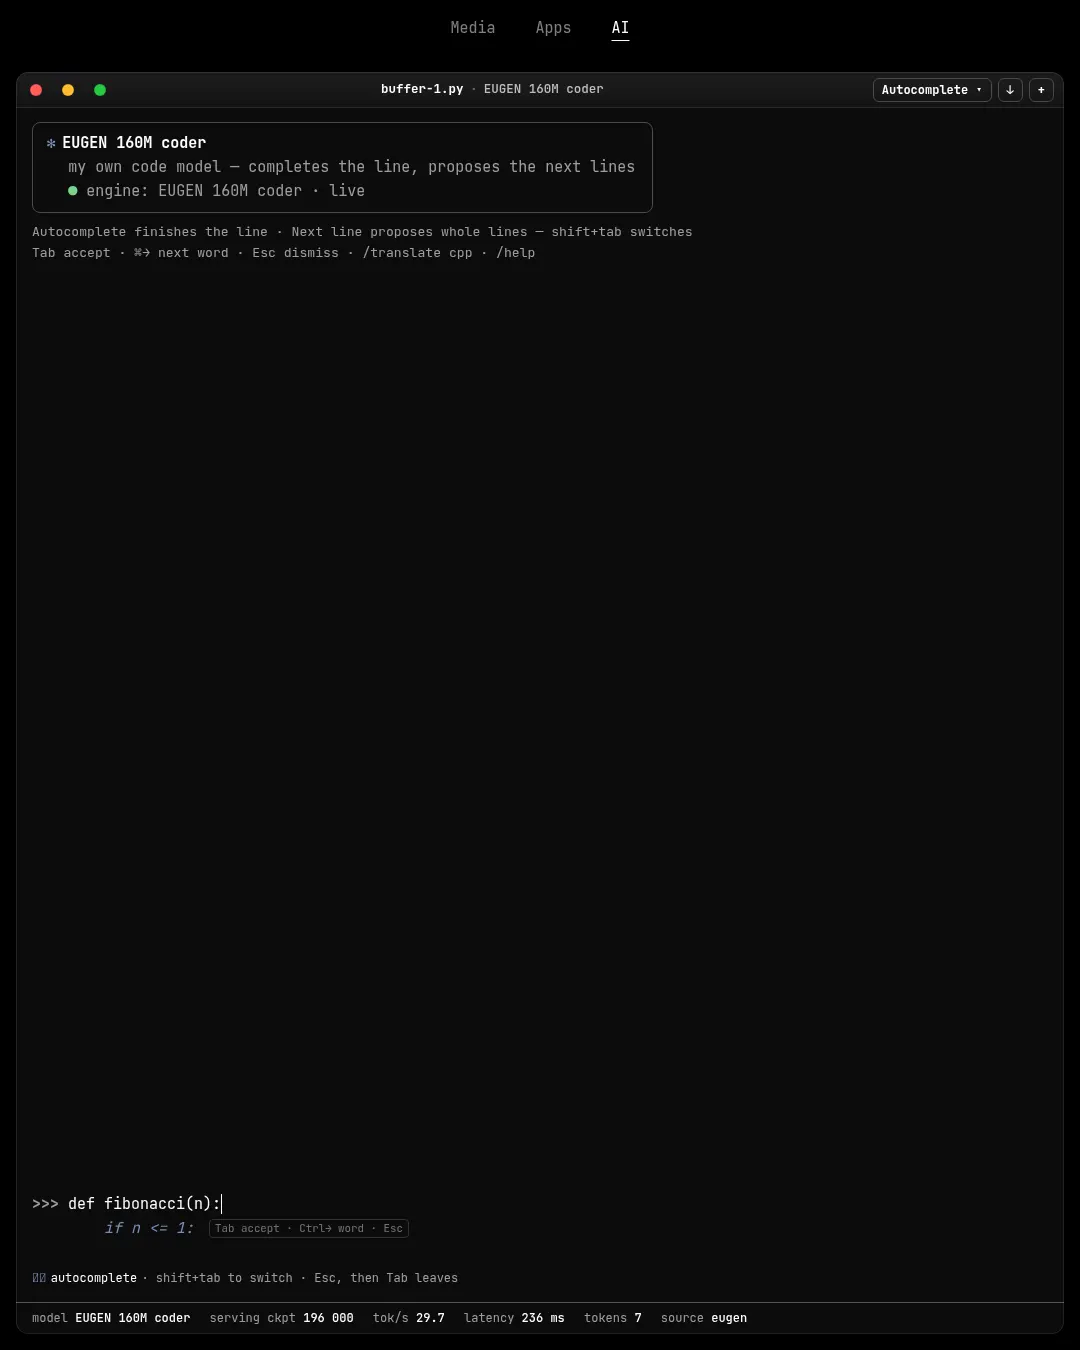
Jakub Ćwirlej는 NVIDIA RTX PRO 6000 GPU 한 장으로 코드 모델 EUGEN 160M을 처음부터 훈련했다고 밝혔다. HumanEval에서 한 번 시도했을 때 22.6%, 열 번 시도했을 때 37.2%의 최고 점수를 기록했으며, 모델은 웹사이트의 터미널에서 체험할 수 있다.
EUGEN 160M은 1억 6,450만 매개변수를 가진 디코더 전용 모델이다. 코드 자동완성과 다음 줄 제안, 파일 중간을 채우는 기능을 지원하며, Python 코드를 C++로 변환하는 데 특화됐다. 제작자는 일반 CPU에서도 초당 최대 364토큰을 생성한다고 설명한다.
HumanEval의 열 번 시도 점수는 최근 측정에서 약 34%였다. Python-C++ 변환 평가에서는 프로그램 100개 중 77개가 컴파일됐고 53개가 모든 테스트를 통과했다. 여러 생성 결과 중 컴파일과 테스트를 통과한 것만 사용자에게 전달하는 방식이다. 평가 결과는 최대 5억 매개변수 모델과 비교했다.
모델은 MuonH 최적화 기법을 사용해 훈련 중이며, 데이터의 약 0.35%는 자체 생성 후 테스트를 통과한 STaR 풀이와 Python·C++·Java·Go·Rust 사이의 번역 데이터로 구성된다. 훈련은 초기 단계다.
제작자는 별도로 희소 FFN용 Triton GPU 커널도 개발했다. 3억 600만 매개변수 모델에서 최적화한 커널은 첫 버전보다 처리량이 36% 높았다. 더 큰 모델과 FFN 8,192를 사용한 초기 테스트에서는 밀집 모델보다 40% 넘는 속도 향상을 보였다고 설명했다. 희소하게 훈련한 뒤 밀집 모델로 변환해도 성능이 유지되는지는 아직 확인되지 않았다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요