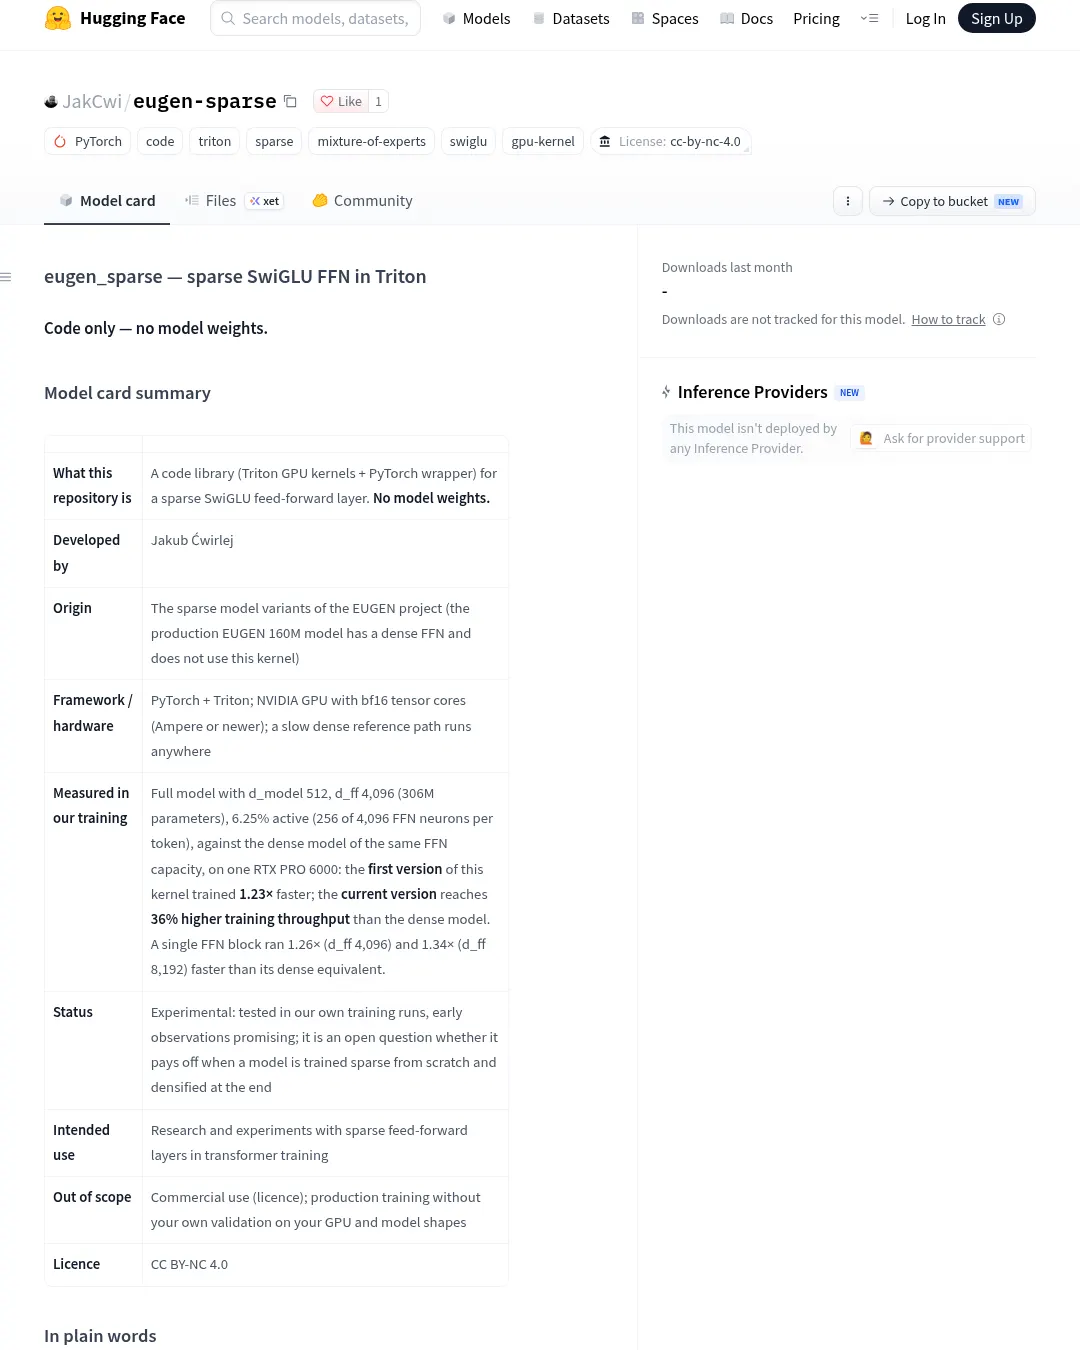
야쿠브 치비를레이(Jakub Ćwirlej)가 공개한 eugen_sparse는 트랜스포머의 SwiGLU 피드포워드 층에서 토큰마다 일부 뉴런 그룹만 계산하는 Triton 커널이다. 제작자가 RTX PRO 6000 한 대에서 진행한 학습에서는 같은 피드포워드 층 용량의 밀집 모델보다 처리량이 36% 높았지만, 실험 단계이며 다른 GPU와 모델에서 성능이 확인된 것은 아니다.
제작자 측 측정은 d_model 512, d_ff 4,096, 뉴런 활성 비율 6.25%(토큰당 4,096개 중 256개)를 사용한 306M 파라미터 전체 모델을 대상으로 했다. 같은 용량의 밀집 모델과 비교했으며, 첫 커널 버전은 1.23배 빠르게 학습했고 현재 버전은 처리량이 36% 높았다. 단일 피드포워드 블록은 d_ff 4,096에서 1.26배, 8,192에서 1.34배 빨랐다. 이는 제작자의 자체 측정 결과다.
저장소에는 Triton GPU 커널과 PyTorch 래퍼가 들어 있으며 모델 가중치는 포함하지 않는다. NVIDIA Ampere 이상 GPU의 bf16 텐서 코어, PyTorch 2.6 이상 및 Triton 3.x가 필요하다. 실제 테스트는 RTX PRO 6000 한 종류에서만 진행됐다. 지원되지 않는 형태나 GPU가 없는 환경에서는 같은 수식을 계산하는 느린 밀집 참조 경로를 사용한다. 설치 패키지는 없으며 eugen_sparse.py를 코드 옆에 복사해 사용할 수 있다.
이 커널은 실험용으로, 희소 상태로 처음부터 학습한 뒤 밀집 모델로 바꾸는 전체 과정에서도 이점이 있는지는 아직 확인되지 않았다. 제작자는 운영 환경에 적용하기 전 각자의 GPU와 모델 형태에서 검증하라고 안내한다. 라이선스는 비상업적 이용에 한해 출처 표시를 요구하는 CC BY-NC 4.0이다.
부록: 원문 예시
grouped_topk_select(x, W_gate, group_size, num_active_groups, subsample_idx=None, samples_per_group=None, load_balance_bias=None)
import torch import eugen_sparse as es d_model, d_ff, G, K = 512, 4096, 32, 8 dev = "cuda" W_gate = torch.randn(d_ff, d_model, device=dev, dtype=torch.bfloat16) * d_model ** -0.5 W_up = torch.randn(d_ff, d_model, device=dev, dtype=torch.bfloat16) * d_model ** -0.5 W_down = torch.randn(d_model, d_ff, device=dev, dtype=torch.bfloat16) * d_ff ** -0.5 sub, spg = es.make_subsample_index(d_ff, G, samples_per_group=8, seed=0) sub = sub.to(dev) x = torch.randn(4096, d_model, device=dev, dtype=torch.bfloat16) idx = es.grouped_topk_select(x, W_gate, G, K, subsample_idx=sub, samples_per_group=spg) y = es.sparse_swiglu_ffn(x, W_gate, W_up, W_down, idx, G) print(es.plan(x.shape[0], d_model, d_ff, G, K))
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요