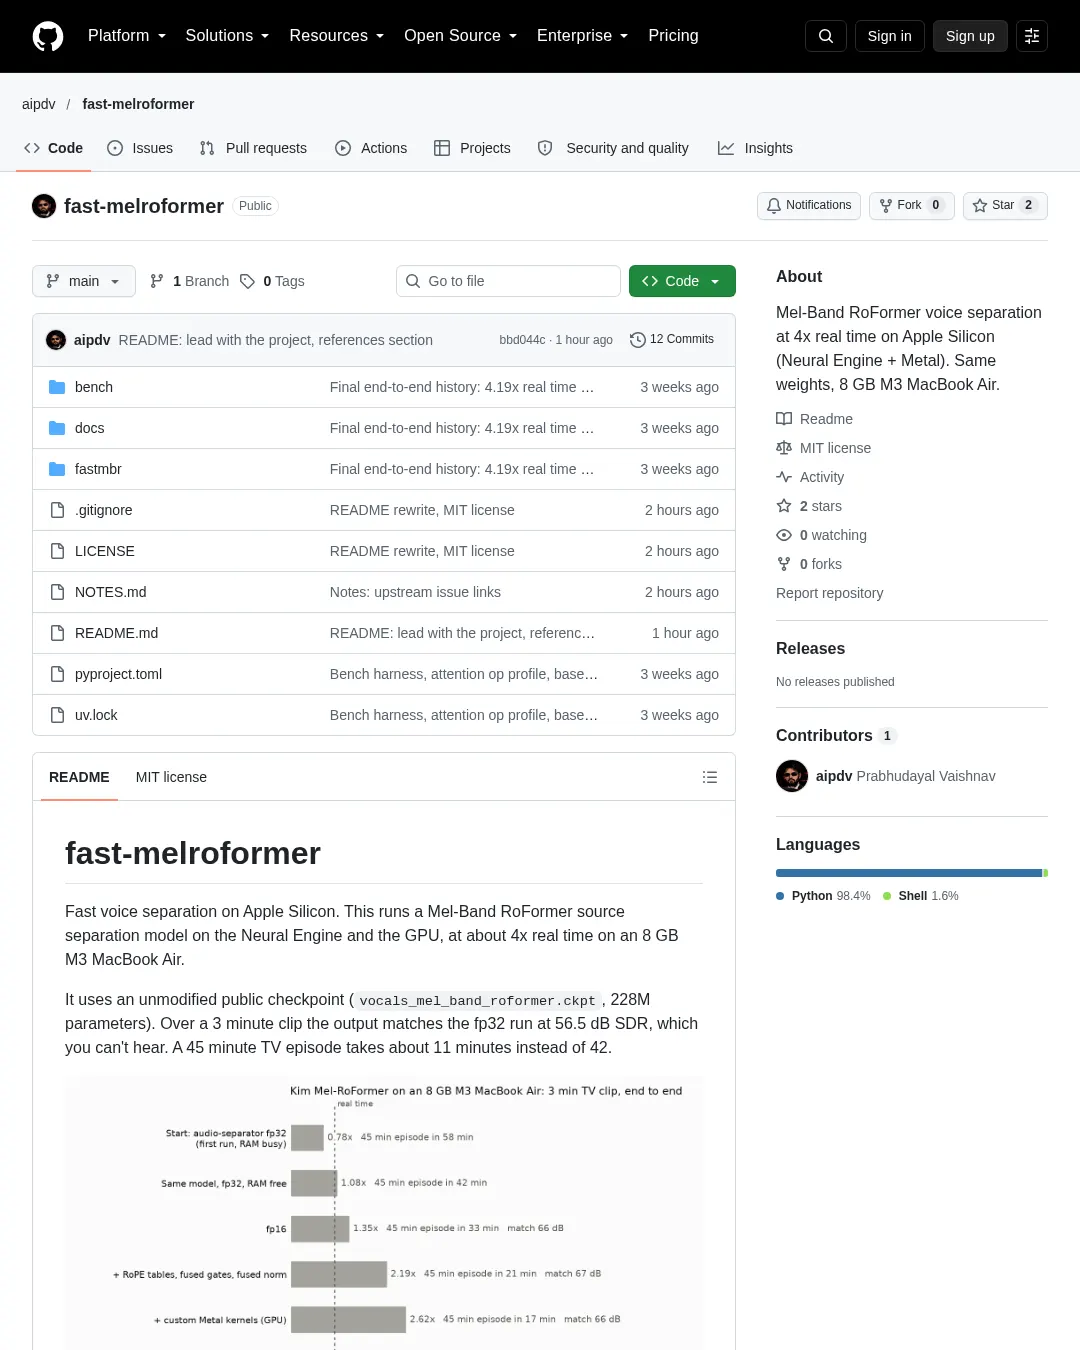
fast-melroformer는 Apple Silicon에서 Mel-Band RoFormer 음원 분리 모델을 실행해 보컬과 나머지 소리를 나눈다. 제작자는 8GB 메모리를 탑재한 M3 MacBook Air에서 실시간보다 약 4배 빠르게 처리한다고 밝혔다.
공개 체크포인트 vocals_mel_band_roformer.ckpt(2억 2,800만 매개변수)를 수정하지 않고 사용한다. 3분짜리 음원에서 fp32 실행 결과와의 SDR은 56.5dB였으며, 45분짜리 TV 에피소드는 약 11분 만에 처리했다. 제작자는 전체 클립의 차이는 들을 수 없는 수준이라고 설명했지만, 조용한 구간 한 곳에서는 40dB로 일치해 음질이 중요하다면 조용한 장면을 들어보라고 안내한다.
같은 3분 클립의 종단 간 처리 속도는 기본 PyTorch fp32 GPU 실행에서 실시간 대비 1.08배였다. fp16 적용 후 1.35배, RoPE와 RMSNorm을 fp32에서 옮기고 출력 게이트를 qkv 행렬 곱에 합친 뒤 2.19배, 사용자 정의 Metal 커널 적용 후 2.62배로 높아졌다. 12개 트랜스포머 블록을 Neural Engine에서 실행하면 3.61배, 시간 어텐션을 작은 타일로 나누면 4.19배였다.
제작자는 RoPE가 MPS에서 어텐션 처리 시간의 30~46%를 차지한 점이 가장 뜻밖이었다고 밝혔다. 각 호출마다 fp32로 각도 표를 다시 계산했기 때문이다. 이 문제를 고치는 패치인 fastmbr/patch.py는 해당 모델을 쓰는 맥 사용자에게도 도움이 될 수 있다고 설명했다. 양자화는 속도 향상에 도움이 되지 않았다고 덧붙였다. 가중치의 88%가 마스크 추정기에 있지만, 처리 시간은 4%만 차지하기 때문이다. 측정값과 실패한 시도는 저장소의 NOTES.md에 기록돼 있다.
사용하려면 Apple Silicon 맥, macOS 15, uv가 필요하다.
git clone https://github.com/aipdv/fast-melroformer && cd fast-melroformer
uv sync
.venv/bin/audio-separator --download_model_only -m vocals_mel_band_roformer.ckpt --model_file_dir ~/models/melroformer
bench/guard.sh .venv/bin/python bench/ane_stack.py convert # builds the Neural Engine model, once
.venv/bin/python -m fastmbr.separate episode.mp4 -o out/
실행 결과는 episode_vocals.wav와 episode_other.wav다. 첫 실행 때 Neural Engine용 모델을 컴파일하는 데 약 5분이 걸리고, 이후에는 모델을 2초 만에 불러온다. --engine gpu는 GPU 경로만 사용해 실시간 대비 2.6배 속도를 내며, --engine ref16과 --engine ref32는 수정하지 않은 모델과 비교할 때 쓴다.
제작자가 시험한 기기는 팬이 없는 8GB M3 MacBook Air 한 대뿐이다. 기기가 뜨거워지면 속도가 떨어져 긴 파일은 4배보다 다소 느리게 처리될 수 있다. bench/guard.sh는 한 번에 작업 하나만 실행하고 RAM이 부족해지면 중단하도록 설계됐다. 제작자는 8GB 맥에서 두 작업을 동시에 실행했을 때 기기가 멈췄다고 밝혔다. 또한 coremltools는 사용한 torch 버전에서 시험되지 않았다는 경고를 표시했지만, 프로젝트에서는 작동했다고 설명했다.
체크포인트는 KimberleyJSN/melbandroformer, 참조 구현은 python-audio-separator이며, 구조 논문은 Mel-Band RoFormer for Music Source Separation이다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요