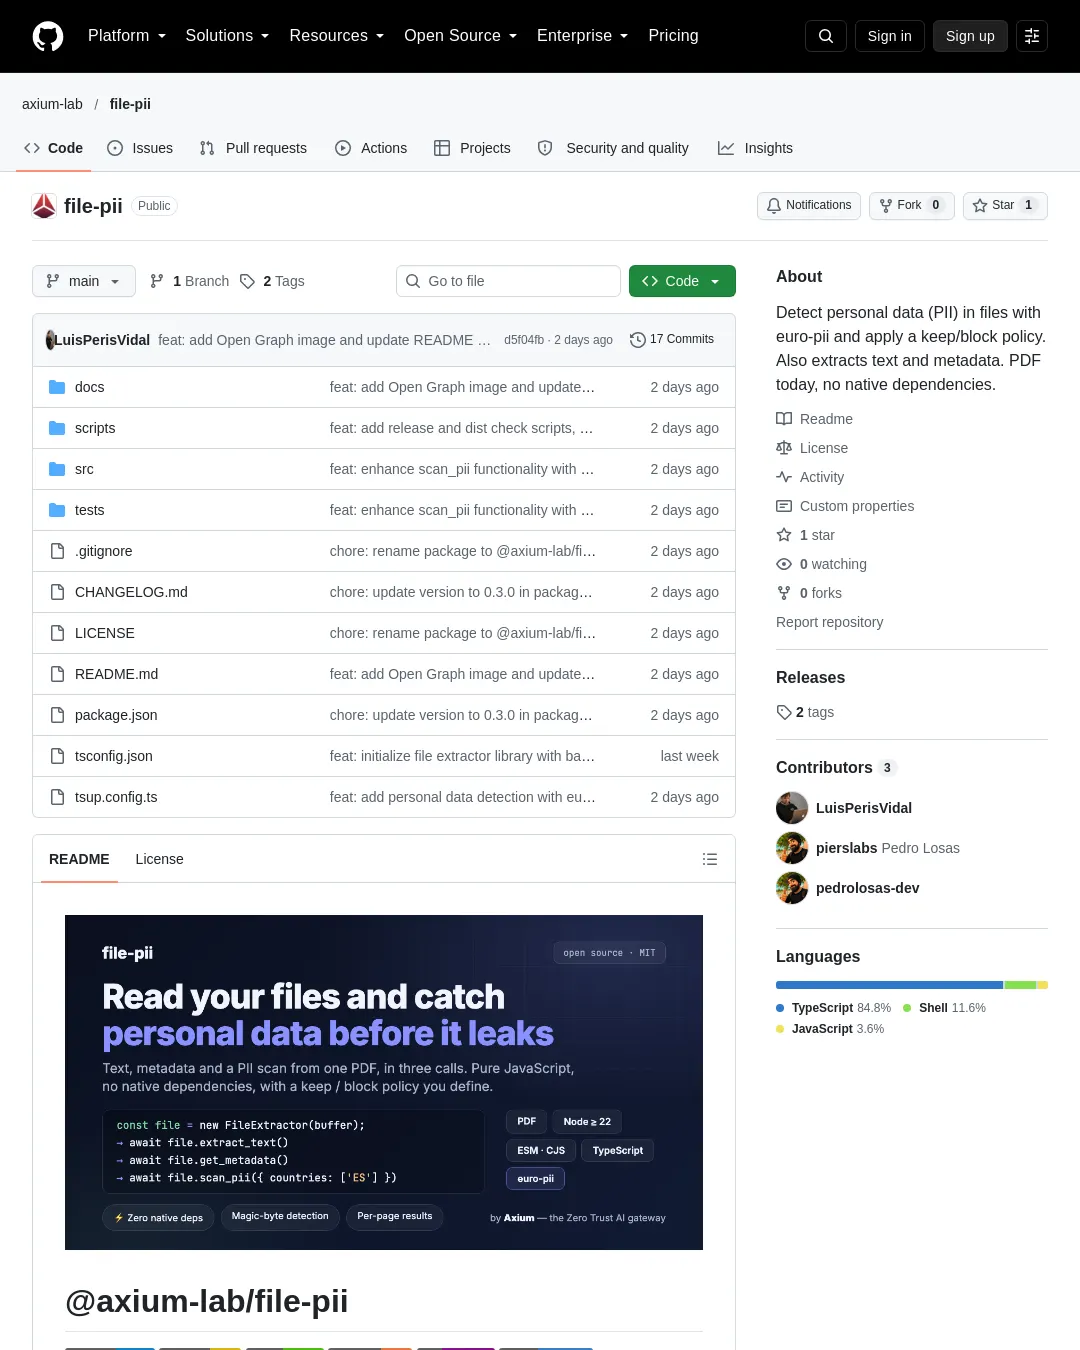
@axium-lab/file-pii는 Node.js 22 이상에서 PDF의 텍스트와 메타데이터를 읽고 개인정보를 탐지하는 JavaScript 라이브러리다. 네이티브 의존성 없이 작동하며, 탐지 결과에 따라 파일을 통과시키거나 차단할 수 있다. 파일 자체를 수정하지는 않는다.
GitHub 저장소와 npm 패키지에서 이용할 수 있다.
설치 명령은 다음과 같다.
npm install @axium-lab/file-pii
FileExtractor는 Buffer, Uint8Array, ArrayBuffer, base64 문자열 또는 base64로 인코딩한 data URI를 입력으로 받는다. 파일 형식은 확장자가 아니라 바이트를 기준으로 판별하며, 현재 지원 형식은 PDF뿐이다. 텍스트 추출, 메타데이터 조회, 개인정보 탐지는 각각 extract_text(), get_metadata(), scan_pii()로 수행한다. 텍스트는 문서 전체를 한 줄로 반환하거나 페이지별로 가져올 수 있다.
개인정보 탐지는 별도 패키지인 euro-pii를 사용한다. 국가나 정보 유형을 지정하고, 탐지 결과를 보고하거나 특정 결과가 있으면 파일을 차단하도록 정책을 설정할 수 있다. OCR은 지원하지 않아 텍스트 레이어가 없는 스캔 PDF에서는 텍스트를 추출하거나 개인정보를 찾지 못한다. 이름과 자유 형식 주소도 탐지 대상이 아니다. euro-pii의 탐지 한계도 적용된다.
비밀번호가 필요한 PDF는 열 수 없으며, 순수 XFA 양식은 텍스트가 불완전할 수 있다. 디지털 서명은 검증하지 않고, 메타데이터에 기록된 권한도 실제로 강제하지 않는다. 라이브러리는 unpdf를 런타임 의존성으로 사용하며, TypeScript 선언과 ESM·CommonJS 빌드를 제공한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요