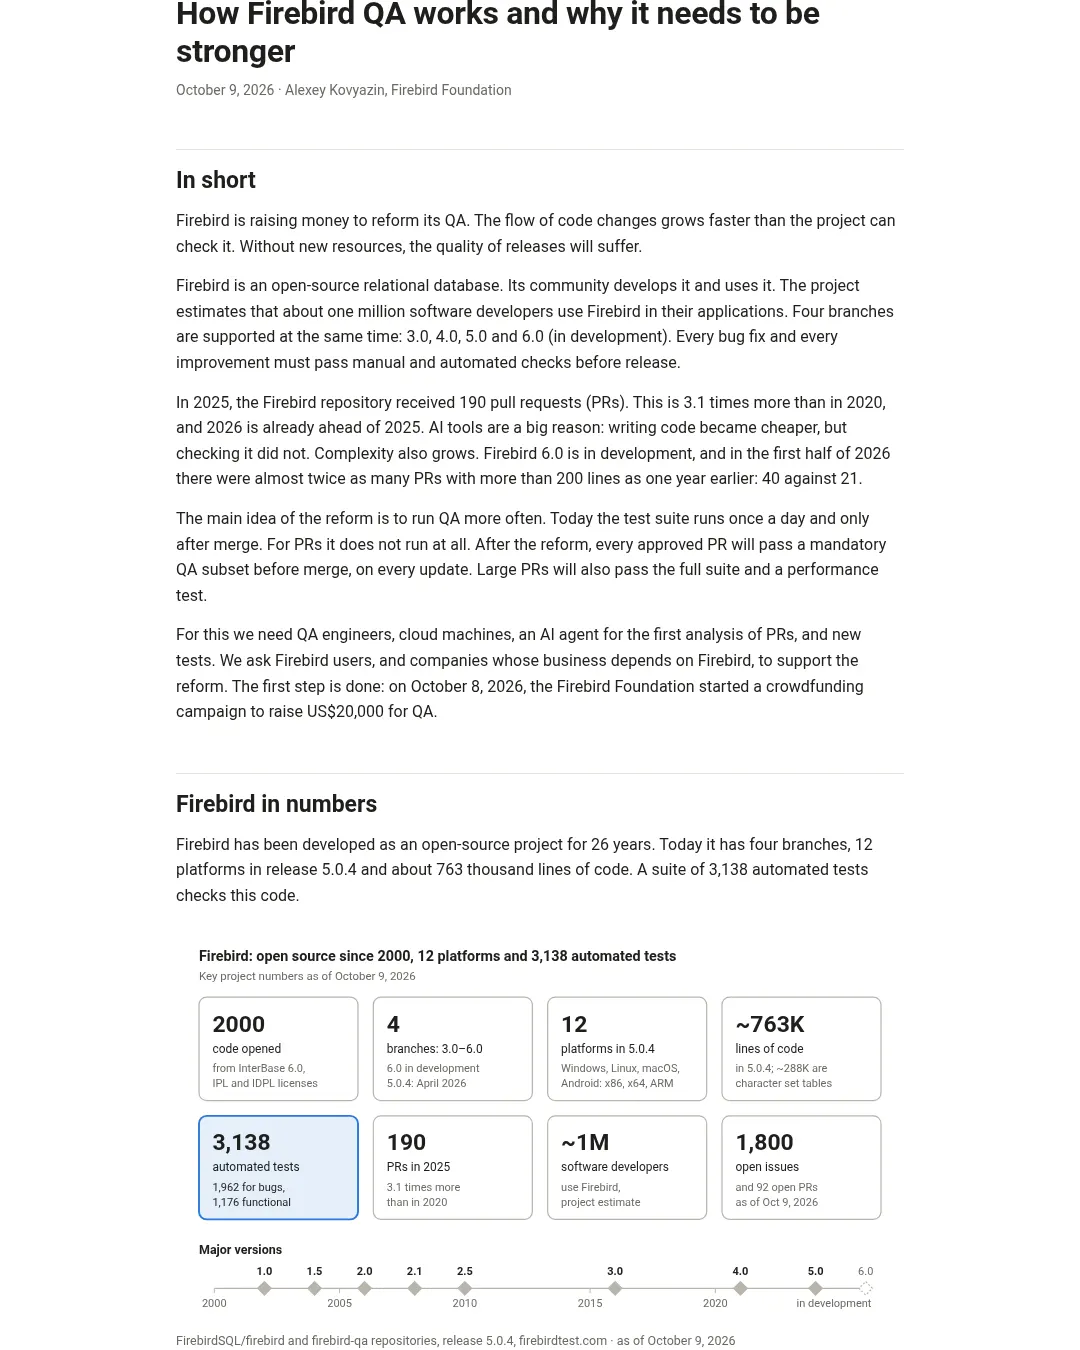
Firebird Foundation은 코드 변경이 검증 역량보다 빠르게 늘어나는 문제를 해결하기 위해 QA 개편 기금 2만 달러를 모금한다. 개편안은 승인된 모든 PR을 병합 전에 업데이트마다 검사하고, 큰 변경에는 전체 테스트와 성능 검사도 적용하는 것이다.
이 글은 2026년 10월 9일 알렉세이 코뱌진(Alexey Kovyazin)이 Firebird Foundation 명의로 발표했다. Firebird는 커뮤니티가 개발하고 사용하는 오픈소스 관계형 데이터베이스다. 프로젝트는 약 100만 명의 소프트웨어 개발자가 애플리케이션에서 Firebird를 사용한다고 추산한다. 현재 3.0, 4.0, 5.0, 개발 중인 6.0 등 네 브랜치를 동시에 지원하며, 버그 수정과 개선은 출시 전에 수동·자동 검사를 거쳐야 한다.
2025년 Firebird 저장소에는 풀 리퀘스트(PR) 190건이 접수됐다. 2020년보다 3.1배 많고, 2026년 접수량은 이미 2025년을 앞설 추세다. 글은 AI 도구로 코드 작성 비용은 낮아졌지만 검증 비용은 줄지 않은 점을 큰 이유로 든다. 복잡성도 커지고 있다. 2026년 상반기에 200줄이 넘는 PR은 40건으로, 1년 전 같은 기간의 21건보다 거의 두 배였다.
Firebird의 규모와 변경량
Firebird는 26년 동안 오픈소스 프로젝트로 개발돼 왔다. 릴리스 5.0.4에는 12개 플랫폼이 포함되고, 코드 규모는 약 76만 3,000줄이며 자동화 테스트는 3,138개다. 프로젝트는 5.0.4의 src 디렉터리를 cloc으로 계산했고 빈 줄과 주석은 제외했다. 이 가운데 약 28만 8,000줄은 국가별 문자 집합 테이블이며, 엔진·SQL·네트워크 계층과 유틸리티의 C/C++ 코드는 약 45만 3,000줄이다. 플랫폼 목록은 2026년 4월 17일자 5.0.4 릴리스 파일을 기준으로 한다. Windows는 x86·x64, Linux는 x86·x64·ARM32·ARM64, macOS는 x64·ARM64, Android는 x86·x64·ARM32·ARM64를 지원한다.
PR은 2024년 134건, 2025년 190건으로 42% 늘었고 2026년 10월 9일까지 184건이 접수됐다. 2026년 첫 9개월 접수량은 2025년 전체와 거의 같다. 같은 기간 이슈 트래커에는 버그 보고와 기능 요청이 들어온다. 10월 9일 기준 열린 이슈는 약 1,800건, 열린 PR은 92건이었다. PR을 연 사람도 2020년 19명, 2025년 30명, 2026년 현재 32명으로 늘었다. 버그 보고는 재현해야 하고, 각 PR은 자체 브랜치와 수정 사항을 이식하는 브랜치에서 각각 검토·시험해야 한다.
버그 보고는 연 235~368건으로 뚜렷한 증가세가 없다. 늘어나는 것은 코드 변경이다. 2026년 10월 9일 기준 PR은 184건으로 이슈 173건을 처음 앞섰다. 두 종류를 합치면 연간 약 440건의 작업 항목이며, 각각 검증이 필요하다.
현재 QA가 작동하는 방식
현재 QA는 병합 뒤에만 실행된다. GitHub의 지속적 통합(CI)은 코드를 빌드하지만 테스트하지 않는다. IBSurgeon이 제공하는 서버에서 테스트 묶음을 하루 한 번 실행하며, 그날 커밋이 있었던 브랜치만 대상으로 한다. 검토와 검사, 결과 분석은 사람이 맡고 있어 변경량이 늘어나는 속도를 따라가기 어렵다.
GitHub Actions는 푸시와 PR마다 Linux(x64·x86·ARM·Alpine), Windows(x64·x86·ARM64), macOS, Android용으로 22~23개 빌드 작업을 수행한다. 테스트는 CI에 포함되지 않는다. 매 푸시마다 테스트하면 기계 시간이 몇 시간씩 들고, GitHub 무료 프로젝트가 조직 전체에 제공하는 병렬 작업은 최대 20개다. 프로젝트는 이미 이 한도에 부딪혔다. 2026년 10월 7일 PR 7건이 동시에 열렸을 때 빌드는 최대 4시간 대기했다. Actions에서 테스트를 시작할 수는 있지만 수동으로만 가능하고 Linux x64만 지원한다.
핵심 개발자들은 코드를 읽고 PR에서 논의하며 필요한 경우 수정을 요청한다. 수정 사항을 여러 브랜치로 이식해야 하는 경우가 많아 브랜치마다 따로 검사해야 한다. QA 엔지니어는 먼저 수정 전 스냅샷에서 버그를 재현하고, 수정이 반영된 스냅샷에서 버그가 사라졌는지 확인한 뒤 테스트를 공개한다. 이 과정을 기록한 테스트 파일은 1,500개가 넘는다.
firebird-qa는 pytest 플러그인이자 테스트 3,138개의 저장소다. 이 가운데 1,962개는 회귀 테스트로 각각 특정 버그에 연결돼 있다. 옛 CORE 트래커의 버그 테스트가 파일 1,481개, GitHub 버그 테스트가 481개다. 나머지 1,176개는 SQL, 트리거, 도메인, 복제, 트랜잭션을 다루는 기능 테스트다. 저장소에는 커밋 3,901개가 있다.
야간 테스트는 CI와 별도로 IBSurgeon 서버에서 하루 한 번 실행한다. Windows와 Linux에서 그날 커밋이 있었던 브랜치만 검사하며, 각 버전은 SuperServer와 Classic 두 서버 아키텍처에서 각각 테스트한다. HQbird 빌드도 같은 방식으로 검사한다. firebirdtest.com은 각 결과를 직전 35회 실행과 비교해 새 실패, 덤프와 스택 추적이 남은 충돌, 느려진 테스트를 표시한다.
성능 검사는 OLTP-EMUL로 수행한다. 이 도구는 주문·송장·부품 예약 같은 실제 OLTP 작업을 수십 개 병렬 세션에서 흉내 내고, 분당 성공한 업무 작업 수를 측정한다. 한 번 측정하는 데 약 한 시간이 걸린다. firebirdtest.com에 공개된 최신 결과는 2026년 4월 20일자이며 6.0 브랜치는 아직 포함하지 않았다.
변경이 있었던 브랜치는 모두 QA를 실행한다. 오래된 브랜치는 변경이 적어 실행 횟수도 적다. 아래 실행 시간은 2026년 10월 9일 기준 firebirdtest.com의 최근 35회 중간값이다. SuperServer와 Classic 실행을 합친 값이며, 테스트 수는 해당 브랜치에서 실행되는 테스트 수다. 모든 브랜치는 Linux 서버 2 CPU·메모리 7GB, Windows 서버 8 CPU·메모리 127GB를 사용한다.
| 브랜치 | 테스트 | Linux 실행 | Windows 실행 | 최근 30일 실행 횟수(Linux / Windows) |
|---|---|---|---|---|
| 6.0 (master) | 약 3,090 | 4시간 39분 | 2시간 28분 | 13 / 7 |
| 5.0 | 약 2,880 | 2시간 30분 | 1시간 41분 | 11 / 7 |
| 4.0 | 약 2,690 | 2시간 19분 | 1시간 35분 | 6 / 8 |
| 3.0 | 약 2,230 | 1시간 31분 | 52분 | 4 / 4 |
6.0의 테스트는 5.0보다 7% 많지만 Linux 실행 시간은 86% 더 길다. 실행 시간은 테스트 수뿐 아니라 테스트가 수행하는 작업에도 좌우된다. 현재 PR은 QA를 전혀 거치지 않는다. 회귀 오류는 병합 후 다음 날 아침에야 그날의 모든 커밋과 함께 드러나며, 그 뒤에도 원인이 된 변경을 찾아야 한다.
버그 수정 하나를 검증하는 과정
수정 하나의 검증은 작은 조사 작업이다. QA 엔지니어가 수정 전 빌드에서 버그를 발견하고 수정 후 빌드에서 사라진 것을 확인한 경우에만 테스트를 공개한다.
- 초안 테스트를 만든다. 트래커의
.sql시나리오를 복사하거나 pytest 테스트 초안을 작성한다. - 수정 전 스냅샷을 찾거나 직접 빌드한다. 수정 푸시 시점과 가장 가깝지만 그보다 앞선 스냅샷을 선택한다.
- 재현한다. 초안 테스트로 트래커 시나리오를 실행해 당시 버그가 있었는지 확인한다. 재현되지 않으면 앞선 관련 커밋 또는 다른 주제의 커밋에서 이미 사라졌거나, 티켓에 적히지 않은 설정값·운영체제·드물게는 디버그/릴리스 빌드 조건에 의존하거나, 트래커의 확인 스크립트가 충분히 강하지 않은 경우가 있다. 마지막 경우는 드물지만 발생한다. 어느 경우든 직접 재현하기 전에는 진행하지 않는다. 더 이른 날짜의 스냅샷, 티켓 생성일의 빌드를 시도하고 막다른 상황에서는 핵심 개발자에게 조언을 구한다.
- 수정이 들어간 스냅샷을 찾거나 빌드한다. 수정 커밋의 SHA와 일치하는 소스를 사용한다. 그날 푸시가 하나뿐이면 “Increment build number” 메시지로 자동 생성된 스냅샷을 사용할 수 있다.
- 수정 여부를 확인한다. 버그가 사라졌으면 초안 테스트를 정리해 공개한다.
git add
git commit
git push
버그가 남아 있으면 테스트를 여러 번 다시 확인한다. 문제가 확인되면 핵심 개발자에게 알린다.
테스트에는 두 가지 규칙이 있다. 기본 원칙은 푸시 하나당 테스트 하나이며, 여러 테스트의 사소한 부분을 한꺼번에 바꾸는 경우는 예외다. 또 .py 파일 하나에는 def test_N(...) 형태의 테스트 함수 하나만 둔다. 파일의 다른 함수는 내부 함수가 아닌 한 test_*로 이름 붙이지 않는다. pytest 로그 처리와 모든 실행 결과를 저장하는 데이터베이스 스키마가 이 규칙에 의존하므로 엄격히 지켜야 한다.
각 단계에는 엔지니어의 시간과 스냅샷 빌드가 들 수 있다. 병목은 코드 작성이 아니라 검증이다. 개편은 바로 이 작업에 인력과 클라우드 머신을 추가한다.
변경량과 복잡성 증가
AI 도구는 코드와 버그 보고서를 만드는 비용을 낮췄지만 검증 비용은 낮추지 않았다. 데이터베이스 엔진에서는 겉보기에는 맞는 패치도 동시성, 충돌 복구, 성능을 깨뜨릴 수 있으며, 부하를 걸거나 다른 플랫폼에서 실행해야 문제가 드러날 수 있다.
글은 다른 오픈소스 프로젝트에서도 비슷한 흐름이 나타났다고 설명한다. GitHub Octoverse 2025에 따르면 GitHub에서 생성된 PR은 1년 동안 20%, 병합된 PR은 23% 늘었다. GitHub는 코파일럿 코딩 에이전트 출시와 자동 코드 검토를 이 증가와 연결한다. curl은 AI가 생성한 경우가 많은 저품질 보고서가 쏟아져 2026년 2월 1일 버그 바운티 프로그램을 종료했다. Godot 유지관리자들은 2026년 2월 AI 생성 PR 처리 인력을 늘리기 위한 자금을 공개적으로 요청했고, 같은 시기 GitHub는 이런 PR을 걸러내는 도구를 논의하기 시작했다.
Firebird는 기여를 제한하거나 문을 닫으려는 것이 아니라 검증 역량을 확장하려 한다. PR 수만큼 복잡성도 중요하다. 2025년 상반기에는 PR 104건 가운데 21건이 200줄을 넘었고, 2026년 상반기에는 106건 중 40건이었다. 전체 PR 수는 거의 같지만 큰 PR의 비율은 20%에서 38%로 늘었다. Firebird 6.0 개발과 함께 큰 기능을 담은 PR도 증가하고 있다.
이런 변경은 Linux와 Windows의 두 서버 모드에서 기능을 시험하고, 부하 성능을 확인하며, 다른 브랜치에 이식하는 등 여러 수준의 검사가 필요하다. 큰 PR은 검토 의견을 반영해 업데이트되므로 검사도 반복해야 한다. 1,000줄이 넘는 PR은 평균 약 8회 반복되는 것으로 제시됐다.
개편안: 병합 전에 더 자주 검사
개편의 핵심은 QA를 하루 한 번 병합 뒤에 실행하는 대신, 승인된 모든 PR에 대해 병합 전에 업데이트마다 실행하는 것이다. 빠른 필수 QA 테스트 묶음도 마련한다. 기존 테스트 묶음, IBSurgeon 서버의 야간 실행, CI를 바탕으로 네 가지 방향을 추진한다. 야간 실행은 계속 유지한다. 핵심 개발자의 직접 커밋도 야간 검사에 포함되며 master에서는 전체 변경의 약 4분의 3을 차지한다.
| 방향 | 할 일 | 기대하는 변화 |
|---|---|---|
| QA 엔지니어 확충 | 버그 보고 재현, PR·야간 실행 결과 분석, 테스트 작성, PR 필수 테스트 묶음 구성 | 모든 승인 PR과 버그 보고를 예측 가능한 시간 안에 검사하고 핵심 개발자의 개발 외 업무를 줄인다. |
| 클라우드에서 PR QA | DigitalOcean의 Linux와 Azure의 Windows에서 수명이 짧은 VM을 실행한다. 승인된 PR의 모든 푸시에 필수 테스트를 돌리고 큰 PR은 병합 전 전체 테스트와 OLTP-EMUL을 수행한다. | 회귀 오류를 병합 전에 PR에서 확인하고 야간 서버 과부하를 피한다. |
| 첫 분석용 AI 에이전트 | 새 PR과 연결된 이슈를 읽고 중복 여부, 문제 재현 여부, 규모와 위험, 필요한 테스트 범위를 검토해 권고를 작성한다. | 사람이 몇 분 안에 QA 투입 또는 거절을 결정하고, 불필요한 PR은 실행 전에 걸러낸다. |
| 테스트 범위와 필수 묶음 | 테스트가 부족한 영역을 보완하고 코드 커버리지를 측정해 운영체제별 최대 1시간인 필수 테스트 묶음을 고른다. | 모든 푸시를 빠르게 검사하고 출시 회귀를 줄인다. |
현재 검사는 매우 적은 인력에 의존한다. 개편안은 시간제 QA 엔지니어 보조금을 마련한다. PR 실행이 추가되면 월간 결과 분석량은 야간 실행 60건에 약 140건이 더해진다. 실패 결과는 모두 누군가 분석해야 한다. 야간 서버는 모든 브랜치에 커밋이 있을 때 Linux에서 전체 테스트에 11시간, Windows에서 6.6시간이 걸릴 만큼 이미 바쁘다. PR용으로는 병렬 실행 후 삭제하는 별도 머신이 필요하며, 실제 가동 시간에 대해서만 비용을 낸다.
AI 에이전트는 검토자를 대신하거나 스스로 PR을 승인하지 않는다. 사람이 결정을 내리도록 요약을 준비해 분석 시간을 한 시간에서 몇 분으로 줄이는 것이 역할이다. 필수 테스트 묶음은 테스트 개수가 아니라 실행 시간으로 정한다. 무거운 테스트 몇 개가 가벼운 테스트 100개보다 오래 걸릴 수 있기 때문이다. 목표는 운영체제별 1시간 이내이며, 테스트 선정도 QA 엔지니어의 별도 업무다. 커버리지가 약한 영역의 예로 BLOB 테스트 6개, 모니터링 테스트 4개, 서비스 테스트 2개가 제시됐다.
PR 검증 절차와 병렬 실행
QA는 사람이 승인한 뒤에만 시작한다. PR 코드는 프로젝트 머신에서 실행되므로 사전 검토가 필요하다. 중복, 무의미한 내용, 확인되지 않은 문제, 의도적으로 파괴적인 변경은 바로 거절할 수 있다.
- PR을 열면 현재처럼 CI가 빌드한다. 새 기여자의 PR은 관리자가 승인하기 전까지 CI도 시작하지 않는다. 이는 GitHub 기본 설정이며 대량의 불필요한 PR 생성도 막는다.
- AI 에이전트가 PR과 연결 이슈를 읽고 QA 진행 또는 거절 권고, 복잡도 등급, 필요한 테스트를 PR에 작성한다.
- 핵심 개발자나 QA 엔지니어가 승인 또는 거절한다. 최종 결정은 언제나 사람이 내린다.
- 승인된 뒤에는 모든 푸시마다 Linux와 Windows에서 필수 테스트가 자동 실행된다. 각 실행은 프로젝트 비밀 정보에 접근할 수 없는 수명이 짧은 VM에서 이뤄진다.
- 큰 PR은 병합 전에 전체 테스트를 통과해야 하며, 가장 큰 PR은 기준 빌드와 비교하는 OLTP-EMUL도 수행한다.
- 병합 뒤에는 지금처럼 야간 실행을 한다.
클라우드에서 VM 네 대를 병렬로 실행하는 비용은 한 대를 순차 실행하는 경우와 같다. 다만 결과는 가장 오래 걸리는 브랜치가 끝날 때 나온다. 네 브랜치의 Linux 전체 테스트는 3.0이 1시간 31분, 4.0이 2시간 19분, 5.0이 2시간 30분, 6.0이 4시간 39분이다. 한 서버에서 차례대로 실행하면 11시간이지만 VM 네 대를 쓰면 4시간 39분에 끝난다. 두 방식 모두 총 11 기계시간에 대해 비용을 낸다.
PR도 같은 방식으로 Linux·Windows 전체 테스트와 OLTP-EMUL 두 번 측정을 병렬 실행한다. 큰 PR의 결과를 약 11시간이 아닌 약 5시간 만에 받을 수 있다는 계산이다.
Linux에는 DigitalOcean의 16GB 드롭릿을 사용한다. 2026년 1월 1일부터 DigitalOcean은 드롭릿을 초 단위로 청구하고 최소 청구 시간은 60초다. 아래 가격은 2026년 10월 9일 DigitalOcean 요금표 기준이다.
| 16GB 드롭릿 | vCPU | 시간당 가격 | 6.0 전체 테스트 4시간 39분 | 네 브랜치 10.98 기계시간 |
|---|---|---|---|---|
| Basic | 공유 8개 | $0.143 | $0.66 | $1.57 |
| General Purpose | 전용 4개 | $0.1875 | $0.87 | $2.06 |
| CPU-Optimized | 전용 8개 | $0.25 | $1.16 | $2.75 |
성능 테스트에는 서버 이웃과 코어를 공유하지 않아 측정 재현성이 있는 General Purpose를 사용한다. Linux에서 6.0 전체 테스트 비용은 시간당 $0.1875 × 4.65시간, 약 $0.87이다. IBSurgeon Linux 서버는 2 CPU·7GB로 더 약하므로 클라우드 실행은 더 빨라질 가능성이 있지만, 계산에는 측정된 시간을 그대로 사용한다.
DigitalOcean은 Windows 드롭릿을 제공하지 않아 Windows 작업은 Azure에서 수행한다. 가격은 2026년 10월 9일 기준 서유럽 지역 종량제 Azure Retail Prices API 자료다. Windows 라이선스 비용은 포함하지만 디스크와 트래픽은 포함하지 않는다.
| D4s v5 VM, 16GB | 시간당 가격 | 6.0 전체 테스트 2시간 28분 | 네 브랜치 6.6 기계시간 |
|---|---|---|---|
| 일반 Windows | $0.414 | $1.02 | $2.73 |
| Spot Windows | $0.0765 | $0.19 | $0.50 |
| 일반 Linux(비교용) | $0.23 | $0.57 | $1.52 |
Windows에서 6.0 전체 테스트는 시간당 $0.414 × 2.47시간, 약 $1.02다. IBSurgeon Windows 서버는 클라우드 VM보다 강력하다(8 CPU·127GB). 따라서 클라우드에서는 실행 시간이 더 길어질 수 있으며, 반복 실행을 위한 예비 비용에 이를 반영한다. Spot VM은 5배 넘게 저렴하지만 Azure가 언제든 회수할 수 있다. 기능 테스트에는 적합하지만 성능 측정에는 적합하지 않다.
6개월간 PR QA 비용
승인된 모든 PR을 검사하는 데 6개월 동안 약 $477의 클라우드 비용이 든다는 계산이다. 매 푸시마다 전체 테스트와 OLTP-EMUL을 실행하는 방식보다 기계 시간을 2.8배 적게 쓴다. 필수 테스트 묶음과 PR 복잡도별 실행 기준으로 비용을 줄인다.
향후 6개월 PR은 127건으로 전망했다. 최근 6개월의 114건에 2020년 이후 평균 연간 증가율 25%를 적용해 114 × 1.25^0.5 ≈ 127로 계산했다. 이슈는 클라우드 실행에 포함하지 않는다. QA 엔지니어가 스냅샷에서 버그 보고를 재현하고, 수정은 PR이나 커밋으로 제출하기 때문이다.
실행은 세 종류다. 모두 PR이 가장 많이 가고 테스트가 가장 오래 걸리는 6.0 브랜치를 기준으로 계산했으며, VM을 시작할 때마다 준비 시간 15분을 더했다.
- 필수 테스트 묶음: Linux 1시간, Windows 1시간, 총 2.5 기계시간, $0.75.
- 전체 테스트: SuperServer와 Classic 실행 합계 Linux 4시간 39분, Windows 2시간 28분, 총 7.6 기계시간, $2.04.
- OLTP-EMUL: PR 빌드와 기준 빌드를 Linux에서 병렬 실행하며 각각 1.5시간, 총 3.5 기계시간, $0.66.
실행 항목과 횟수는 PR마다 다르다. 5줄 PR과 5,000줄 PR은 업데이트 횟수와 검사 깊이가 모두 다르므로 가장 단순한 등급과 비교한 기계 시간 배수를 복잡도 계수로 사용한다. 등급별 비율과 푸시 횟수는 최근 12개월 PR 214건에서 계산했다. 새 커밋이 있었던 날짜 수를 기준으로 평균 푸시 횟수는 S·M·L·XL 순으로 1.2, 1.6, 2.1, 8.0회다. 강제 푸시가 일부 반복을 감추므로 이는 하한이며 표의 수치는 올림했다.
| PR 등급(변경 줄 수) | PR 비율 | PR당 푸시 | 실행 내용 | PR당 기계시간 | 계수 |
|---|---|---|---|---|---|
| S, 20줄 이하 | 42% | 1.5 | 매 푸시 필수 테스트 묶음 | 3.8 | 1 |
| M, 21~200줄 | 24% | 2 | 매 푸시 필수 테스트 묶음 | 5.0 | 1.3 |
| L, 201~1,000줄 | 22% | 3 | 동일하게 실행하고 병합 전 전체 테스트 | 15.1 | 4 |
| XL, 1,000줄 초과 | 12% | 8 | 동일하게 실행하고 전체 테스트 2회 및 OLTP-EMUL | 38.7 | 10 |
예상 PR 127건은 S 53건, M 30건, L 28건, XL 16건이다. 등급별 PR 하나의 비용은 각각 $1.13, $1.50, $4.30, $10.76이다. 불안정한 테스트와 VM 오류에 따른 반복 실행 비용 20%를 더하면 다음과 같다.
(53 × $1.13 + 30 × $1.50 + 28 × $4.30 + 16 × $10.76) × 1.2 ≈ $477
현재는 IBSurgeon 서버에서 변경된 브랜치의 야간 테스트를 월 153 기계시간 실행하며 클라우드 비용은 없다. 개편안은 월간 기계시간을 232시간 추가해 현재의 2.5배 수준으로 만들고 6개월 클라우드 비용은 $477이다. 모든 PR의 모든 푸시마다 전체 테스트와 OLTP-EMUL을 실행하면 월 651 기계시간이 추가되고 현재의 5.3배가 되며 6개월 비용은 $1,139다. 현재 기계시간은 최근 30일 Linux 34회, Windows 26회 실행을 기준으로 했다.
두 방식의 비용 차이는 작지만 대기 시간이 중요하다. 필수 테스트 묶음은 업데이트마다 약 1시간 15분 만에 결과를 주고, 전체 테스트만 실행하면 약 5시간이 걸린다. PR 증가가 전망보다 빠르게 2025년의 연간 42% 증가율을 이어가면 약 136건이 되고 실행 비용은 약 $511로 늘어난다. 예비 비용이 차이를 감당한다.
6.0 테스트 확대와 예산
6.0 출시 준비와 테스트 강도 확대에는 6개월 동안 클라우드 비용 약 $150이 추가된다. PR QA 비용에 약 30%를 더하는 규모다. 테스트 확대의 주된 비용은 머신이 아니라 새 테스트를 작성하는 QA 엔지니어의 시간이다.
Firebird 6 로드맵은 알파를 2026년 4분기, 베타를 2027년 2분기, 정식 출시를 2027년 4분기로 제시한다. 6.0 전용 테스트는 1년 사이 93개에서 225개로 늘었다. 이 가운데 91개는 최근 6개월, 49개는 최근 분기에 추가됐다. 스키마, 테이블스페이스, JSON 함수, ROW 유형, 공유 메타데이터 캐시 같은 새 기능에는 새롭고 때로는 무거운 테스트가 필요하다.
| 추가 항목 | 계획 | 6개월 기계시간 | 6개월 클라우드 비용 |
|---|---|---|---|
| PR 수와 대형 PR 증가 | 알파 이후 PR 15% 증가(127건에서 146건), 200줄 초과 PR 비율은 2026년 상반기처럼 38% | 207 | $72 |
| 알파·베타 빌드 검사 | 빌드 6개마다 Linux 전체 테스트, Windows x64·x86 전체 테스트, OLTP-EMUL 6.0 대 5.0, Linux 24시간 스트레스 테스트 | 234 | $62 |
| 6.0 테스트 묶음 증가 | 2027년 4월까지 전체 테스트가 20% 길어지고 기간 평균은 10% 증가 | 51 | $16 |
| 합계 | 492 | $150 |
기계시간은 반복을 제외한 값이고 비용에는 반복 실행을 위한 20% 예비분이 포함된다. 확대 후 월간 기계시간은 현재 야간 실행 153시간, PR QA 232시간, 확대 작업 약 82시간을 합쳐 약 467시간으로 현재보다 세 배가량 늘어난다. 야간 서버에는 이 용량이 없다. 베타 뒤에는 별도 6.0 브랜치가 생겨 야간 실행도 네 번에서 다섯 번으로 늘어난다.
주된 확대 작업은 사람의 일이다. 최근 분기 속도가 이어지면 6개월 동안 6.0 전용 테스트가 약 100개 추가되고, 알파와 테스터의 버그 보고가 더해지면 더 늘어난다. 각 테스트는 앞서 설명한 검증 과정을 거친다. QA 엔지니어 보조금이 이 작업에 쓰이며, 테스트가 더 많아지면 모금액 잔액과 예비비로 QA 시간을 추가할 수 있다.
개편의 6개월 총비용은 약 $18,402로 모금 목표인 2만 달러보다 $1,598 적다. 남은 금액은 PR 증가에 대비해 보유하거나 QA 시간에 쓸 수 있다. 자금의 약 83%는 인건비로 가고 클라우드와 AI 에이전트 비용을 합치면 약 7%다.
| 항목 | 산정 기준 | 월간 | 6개월 |
|---|---|---|---|
| 시간제 QA 엔지니어 보조금 | 프로젝트 계획 | $2,133 | $12,798 |
| PR QA 설정: 승인 후 시작, 단기 VM, PR과 firebirdtest.com에 결과 게시 | 일회성 | — | $1,500 |
| 첫 분석 에이전트 개발: GitHub 연동, 프로젝트 규칙 | 일회성 | — | $1,000 |
| 클라우드 디스크·트래픽, 가격·PR 증가 예비비 | 목표액의 5% | — | $1,000 |
| AI 에이전트 서비스 구독 | 고정 구독료 | $100 | $600 |
| 결제 수수료 | 목표액의 4% | — | $800 |
| PR Windows 실행: Azure D4s v5 | 필수 묶음과 등급별 전체 테스트, 반복 20% 추가 | $50 | $299.26 |
| Linux 실행: DigitalOcean General Purpose 16GB | 등급별 PR 실행, 반복 20% 추가, 5.0·6.0 야간 OLTP-EMUL | $37 | $224.86 |
| 6.0 테스트 확대·강화: Linux와 Windows | 알파·베타 빌드, PR 증가, 테스트 묶음 확장, 반복 20% 추가 | $25 | $150.14 |
| 로그·충돌 덤프·데이터베이스 저장: DigitalOcean Spaces | 250GB, 트래픽 1TB | $5 | $30 |
| 합계 | $18,402.26 |
PR 클라우드 실행 계산은 예상 PR 127건을 복잡도별로 나눠 매 푸시 필수 테스트를 하고 큰 PR은 병합 전 전체 테스트를 수행하는 방식이다. 자세한 내용은 앞의 비용 산정을 따른다. Linux 비용에는 커밋이 있는 날 5.0과 6.0에서 실행하는 야간 OLTP-EMUL도 들어간다. 월 약 24회 측정이며 6개월 비용은 $47.25다. 6.0 확대 비용은 별도 항목으로 Linux $78.18, Windows $71.95다. 테스트 묶음 야간 실행은 계속 IBSurgeon 서버에서 수행하며 비교 기준으로 활용한다.
AI 에이전트 비용은 월 $100에 맞춘다. PR 하나를 분석할 때 입력 약 20만 토큰, 출력 1만 토큰이 들고 가장 강력한 모델을 사용해도 약 $1이다. 새 PR과 업데이트 뒤 재분석을 모두 포함해 월 약 $80, 알파 뒤 PR이 늘면 약 $90으로 계산했다. 월 $2,133의 보조금은 프로젝트 계획을 따른다. 클라우드 항목은 현재 가격과 실제 실행 시간을 기준으로 한다. 아직 선정해야 하는 필수 테스트 묶음은 운영체제별 목표 시간 1시간을 사용했다.
모금과 참여 방법
Firebird Foundation은 2026년 10월 8일 QA 개선을 위한 크라우드펀딩을 시작했다. 6개월 동안 추가로 2만 달러를 모으는 것이 목표다. 모금액은 QA 엔지니어의 업무 시간과 QA 실행용 가상 머신, 특히 성능 테스트에 쓰인다.
모금 첫날인 2026년 10월 8일에는 QA 검사와 테스트를 기다리는 열린 PR이 93건이었다. 검토와 테스트 없이 변경을 병합하지 않는 프로젝트 규칙은 바뀌지 않는다. 금액 제한 없이 캠페인 페이지에서 기부할 수 있다.
Firebird Foundation은 QA 투자를 Firebird에 데이터를 보관하는 모든 사람을 위한 보험이라고 설명한다. 출시 전 버그를 잡는 데는 엔지니어의 몇 시간이 들지만 놓친 버그는 수천 명의 사용자에게 서비스 중단과 데이터 손실을 초래할 수 있다는 주장이다. 재단이 제시한 기대 효과는 병합 다음 날이 아닌 PR 안에서 회귀 오류를 확인하는 것, 3.0~5.0과 향후 6.0 브랜치의 안정적인 출시, 검증 병목을 줄여 버그 보고에서 수정까지의 시간을 단축하는 것, AI를 활용해 작성한 변경을 포함해 외부 기여를 더 안전하게 수용하는 것이다. 모든 실행 결과를 firebirdtest.com에 공개하고 지출 보고서도 제공할 계획이다.
도움이 필요한 사람은 QA 모금 캠페인에 원하는 금액을 기부하거나, Firebird Foundation을 통해 일회성 또는 정기 후원을 할 수 있다. Associate 후원은 연 €100, Partner 후원은 연 €400이다. 기업 후원 조건은 재단과 개별 논의한다. DigitalOcean·Azure·AWS의 클라우드 자원이나 테스트 머신용 크레딧을 제공하거나, 엔지니어를 배정해 PR 검토와 firebird-qa 테스트 작성에 참여할 수도 있다.
자료와 산정 기준
이슈와 PR 통계는 FirebirdSQL/firebird 저장소의 GitHub Search API에서 생성 날짜 기준으로 계산했다. 작성자 수, PR 규모와 반복 횟수는 refs/pull 브랜치 기록에서, PR 등급은 12개월간 PR 214건에서, 직접 커밋 비중은 master 기록에서 산출했다. 테스트 수와 증가량은 firebird-qa 저장소 이력에서, 실행 시간과 횟수는 firebirdtest.com 보고서에서 가져왔다. 자료 기준일은 2026년 10월 9일이다.
- Firebird Foundation: Firebird QA 개선 크라우드펀딩
- FirebirdSQL/firebird: 5.0.4 릴리스
- FirebirdSQL/firebird-qa
- Firebird QA 결과: firebirdtest.com
- firebirdtest.com: 6.0 브랜치 Linux 최근 35회 전체 테스트
- firebirdtest.com: Firebird OLTP-EMUL
- Firebird QA: firebirdsql.org
- Firebird 6 로드맵
- Firebird OLTP-EMUL 테스트: IBSurgeon
- Firebird 데이터베이스 서버: Wikipedia
- Firebird 후원: Firebird Foundation
- GitHub 문서: 저장소의 GitHub Actions 설정 관리
- GitHub 문서: Actions 제한
- FirebirdSQL/firebird: CI 실행
- DigitalOcean: 드롭릿 요금
- DigitalOcean: Spaces 오브젝트 스토리지 요금
- Azure Retail Prices API: 서유럽 D4s v5
- GitHub Octoverse 2025
- BleepingComputer: curl의 버그 바운티 프로그램 종료
- DevClass: AI 저품질 PR 문제를 두고 GitHub를 지목한 개발자들
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요