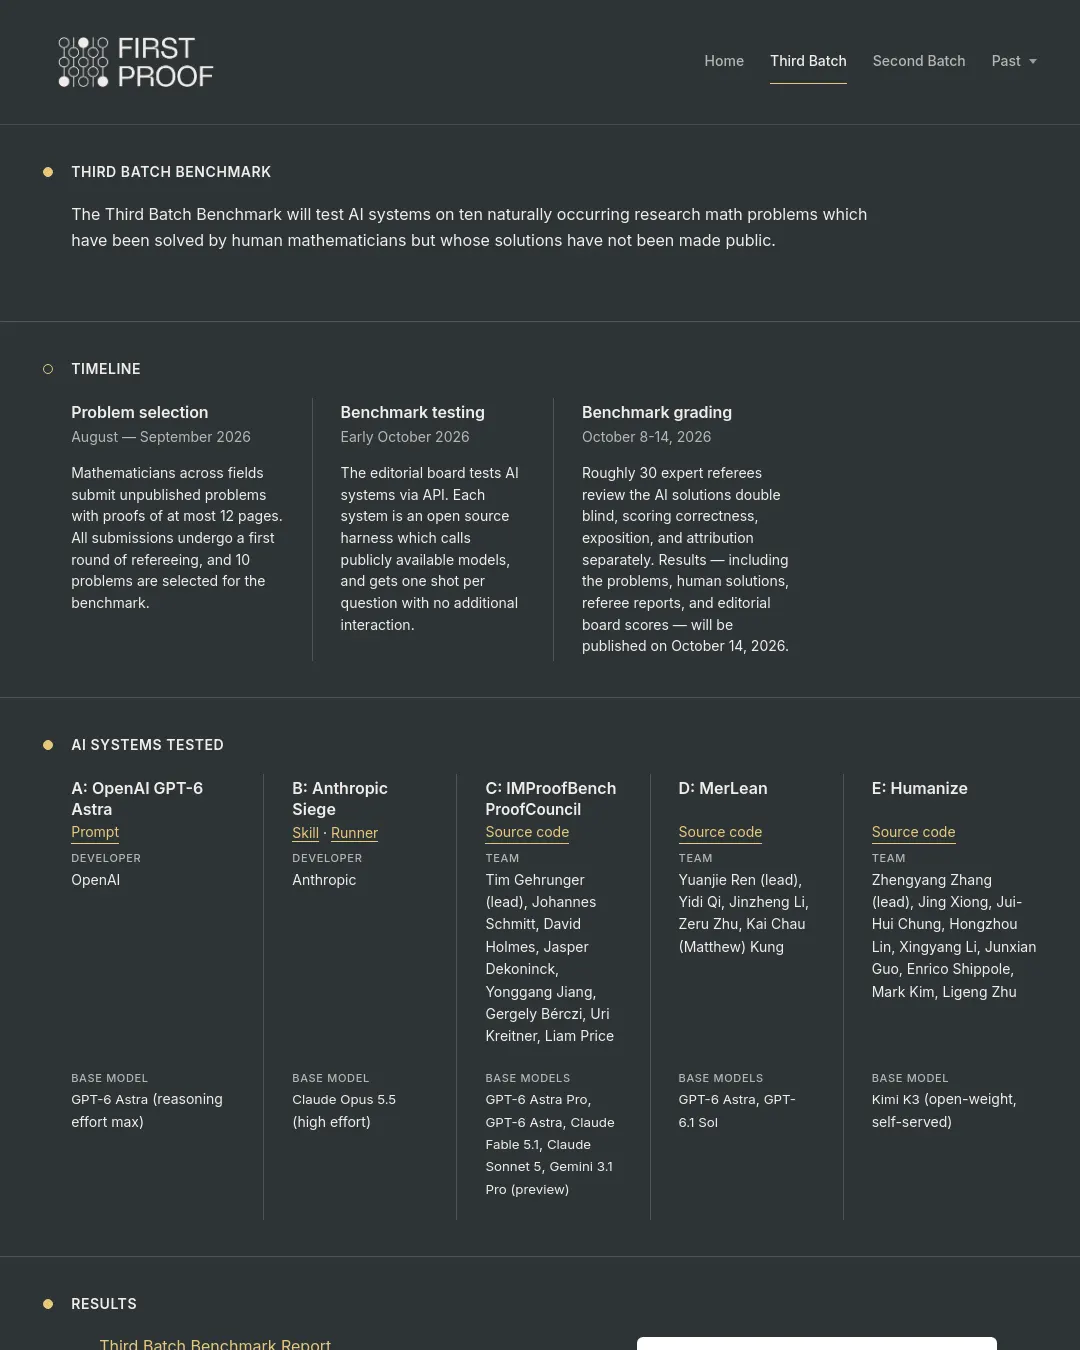
Third Batch Benchmark는 수학자들이 풀었지만 해법을 공개하지 않은 실제 연구 수학 문제 10개로 AI 시스템의 증명 능력을 평가한다. 각 시스템은 문제마다 추가 상호작용 없이 한 번만 답하며, 전문가 심판이 정답성·설명·출처 표시를 따로 채점한다.
문제는 2026년 8~9월 여러 분야의 수학자들이 제출한 미공개 문제 가운데 선정한다. 증명은 12쪽 이하여야 하며, 모든 제출물은 1차 심사를 거친다. 편집위원회는 2026년 10월 초 API를 통해 AI 시스템을 시험할 예정이다. 각 시스템은 공개 모델을 호출하는 오픈소스 하네스로 구성된다.
2026년 10월 8~14일에는 약 30명의 전문가 심판이 AI가 만든 증명을 이중 블라인드 방식으로 검토한다. 문제와 사람의 해법, 심판 보고서, 편집위원회 점수를 포함한 결과는 2026년 10월 14일 공개될 예정이다.
시험 대상은 OpenAI의 GPT-6 Astra, Anthropic의 Siege, IMProofBench의 ProofCouncil, MerLean, Humanize다. ProofCouncil은 GPT-6 Astra Pro, GPT-6 Astra, Claude Fable 5.1, Claude Sonnet 5, Gemini 3.1 Pro (preview)를 사용한다. MerLean은 GPT-6 Astra와 GPT-6.1 Sol을, Humanize는 오픈 웨이트 모델 Kimi K3를 자체 운영 방식으로 사용한다.
각 시스템의 프롬프트·기술·실행기와 소스 코드는 원문에 연결된 자료에서 확인할 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요