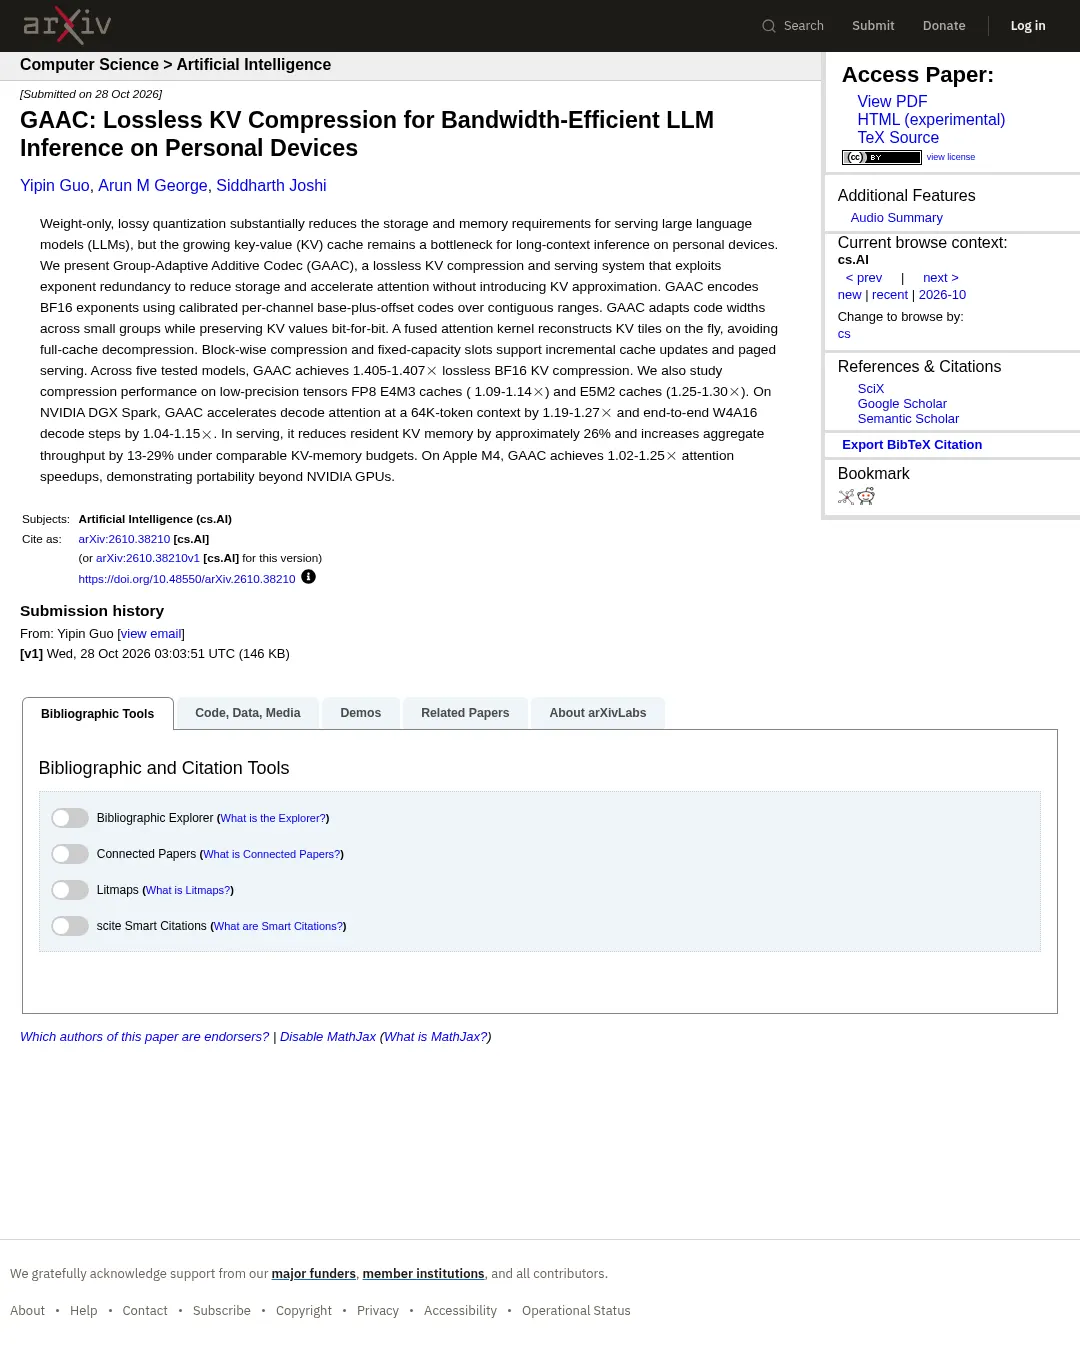
GAAC는 대형 언어 모델(LLM)의 키-값(KV) 캐시를 원래 값 그대로 보존하며 압축하는 시스템이다. 논문 저자들은 개인 기기에서 긴 문맥을 처리할 때 메모리 병목을 줄이고, NVIDIA DGX Spark와 Apple M4에서 어텐션 속도를 높였다고 보고했다.
GAAC는 BF16 값의 지수부에 반복되는 패턴을 이용해 캐시를 인코딩하고, 작은 그룹마다 코드 폭을 조정한다. 압축된 값을 어텐션 연산 중 필요한 부분만 복원해 전체 캐시를 미리 풀지 않으며, 논문은 KV 값이 비트 단위로 동일하게 유지된다고 설명한다. 블록 단위 압축과 고정 용량 슬롯은 캐시를 계속 갱신하는 경우와 페이지 방식 서빙을 지원한다.
논문에서 시험한 모델 5종의 BF16 KV 캐시는 1.405~1.407배 압축됐다. 저정밀도 텐서에서는 FP8 E4M3 캐시가 1.09~1.14배, E5M2 캐시가 1.25~1.30배 압축됐다. NVIDIA DGX Spark에서 문맥 길이 64K 토큰일 때 디코드 어텐션은 1.19~1.27배 빨라졌고, W4A16 디코드 단계 전체는 1.04~1.15배 빨라졌다. 서빙에서는 KV 메모리 예산이 비슷한 조건에서 상주 KV 메모리를 약 26% 줄이고 총 처리량을 13~29% 높였다고 보고했다. Apple M4에서는 어텐션 속도가 1.02~1.25배 향상됐다.
결과는 논문에 제시된 하드웨어와 시험 조건에 한정된다. 자세한 내용은 논문, PDF, HTML 버전에서 확인할 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요