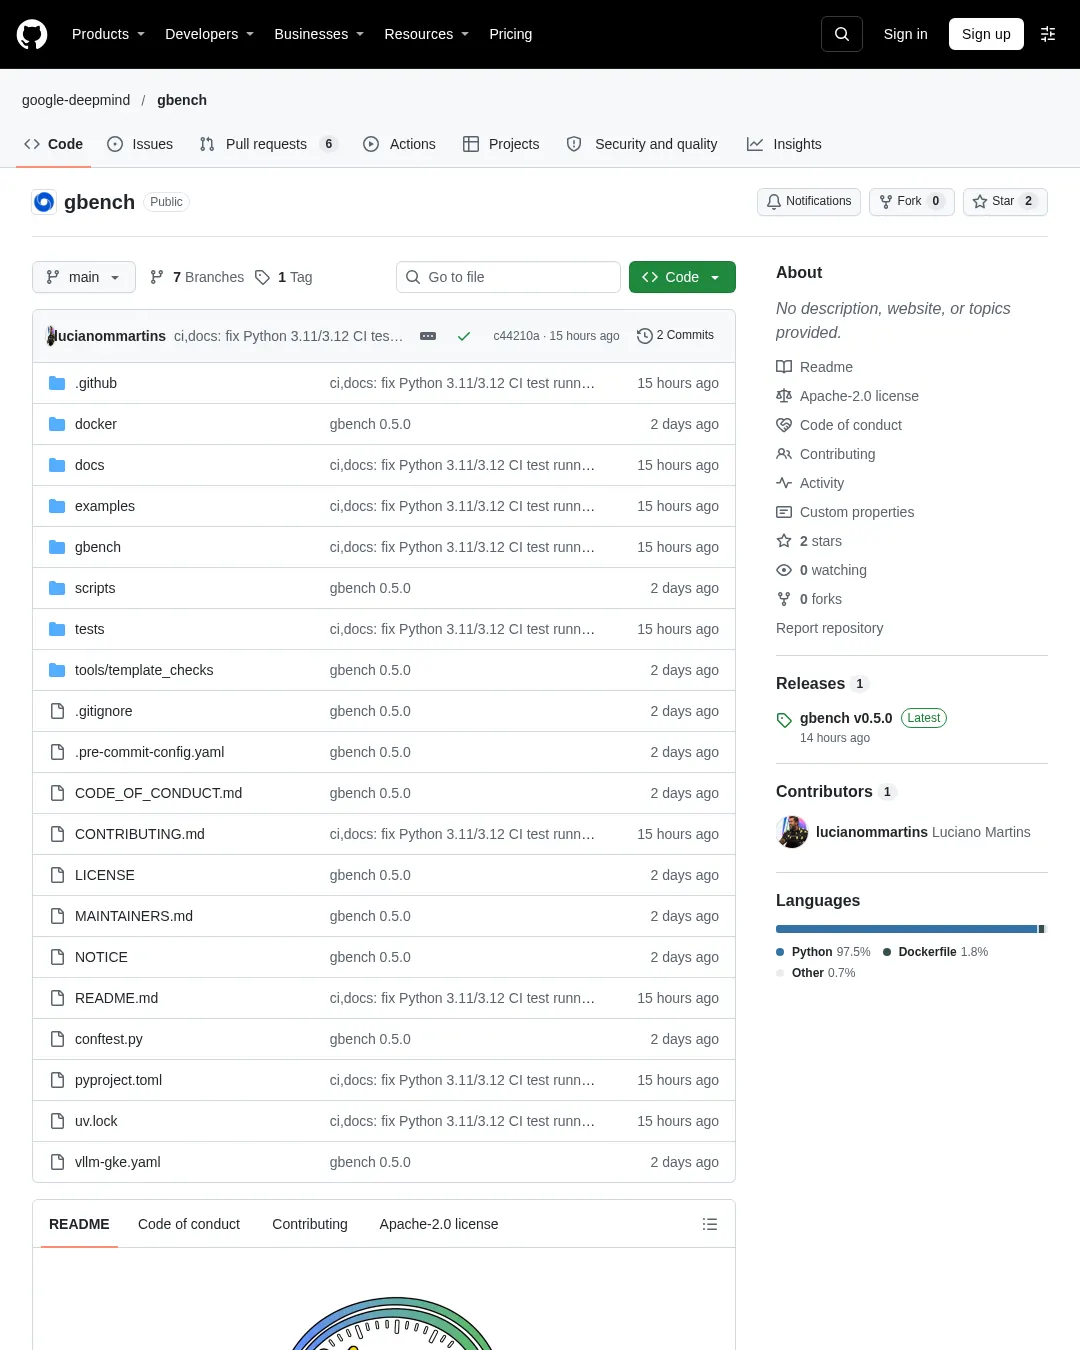
구글 딥마인드가 오픈 대형언어모델과 비전언어모델의 성능·역량을 측정하는 오픈소스 도구 gBench를 공개했다. 하드웨어에서의 서빙 성능과 학술 평가, 기본 역량 점검, 에이전트 품질을 평가하며, 전체 학술 평가 목록에는 6개 분야의 벤치마크 86개가 포함된다.
gBench는 OpenAI 호환 /v1 서버를 --remote-endpoint로 연결하거나 로컬 vLLM 서버를 자동으로 실행해 쓸 수 있다. vLLM과 Ollama에서 검증됐으며, 구글 딥마인드는 인증 없이 호출할 수 있는 Cloud Run에서도 검증했다고 밝혔다.
역량 평가는 세 단계로 구성된다. --evals는 학술·분야별 평가와 사용자 정의 데이터셋을 지원하고, --golden-only는 코드·수학·도구 호출·구조화된 출력 등 16개 결정론적 점검을 수행한다. --quality-only는 고정된 GemmaClaw 커밋의 QA 시나리오 60개를 사용해 여러 차례에 걸친 도구 호출과 세션 메모리, 플러그인 경로 지정 등을 평가한다. 다른 모델 제공자가 필요한 시나리오는 별도로 표시하고 점수에 포함하지 않는다.
성능 측정에는 반복 실행에 따른 평균·중앙값·표준편차와 백분위수 등이 포함된다. 스트레스 테스트는 요청률을 높여가며 한계를 찾고, P99 지연시간 서비스 수준 목표를 기준으로 결과를 인증한다. 인증을 마치지 못한 경우에는 인증되지 않은 결과로 표시할 수 있다. 지원 GPU 수와 데이터셋별 라이선스 조건 등은 gBench 저장소와 설치 안내, 평가 목록, 에이전트 품질 평가 안내에서 확인할 수 있다. 공개된 데이터셋의 라이선스는 해당 데이터셋과 점수의 사용에도 적용되므로, 결과를 발표하기 전에 조건을 확인해야 한다.
기본 패키지는 Python 3.11 이상이 필요하며, 선택한 기능에 따라 추가 패키지를 설치해야 한다. gBench는 vLLM과 PyTorch를 직접 설치하지 않는다.
git clone https://github.com/google-deepmind/gbench.git
cd gbench
python3 -m venv venv && source venv/bin/activate

pip install -e . # base package (Python 3.11+): laptops and remote endpoints such as Ollama
# optional, per use:
pip install transformers # --remote-endpoint: prompt sizing (--tokenizer), Golden Set chat-template
 # cases and the mmlu, wmdp, ruler and longbench_v2_code suites
pip install vllm # local GPU serving, and remote real-dataset workloads (--campaign chat-like,
 # --dataset custom/hf); gBench never installs vllm/torch itself
pip install -e ".[evals]" # the eval suites' client, scorer and harness dependencies
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요