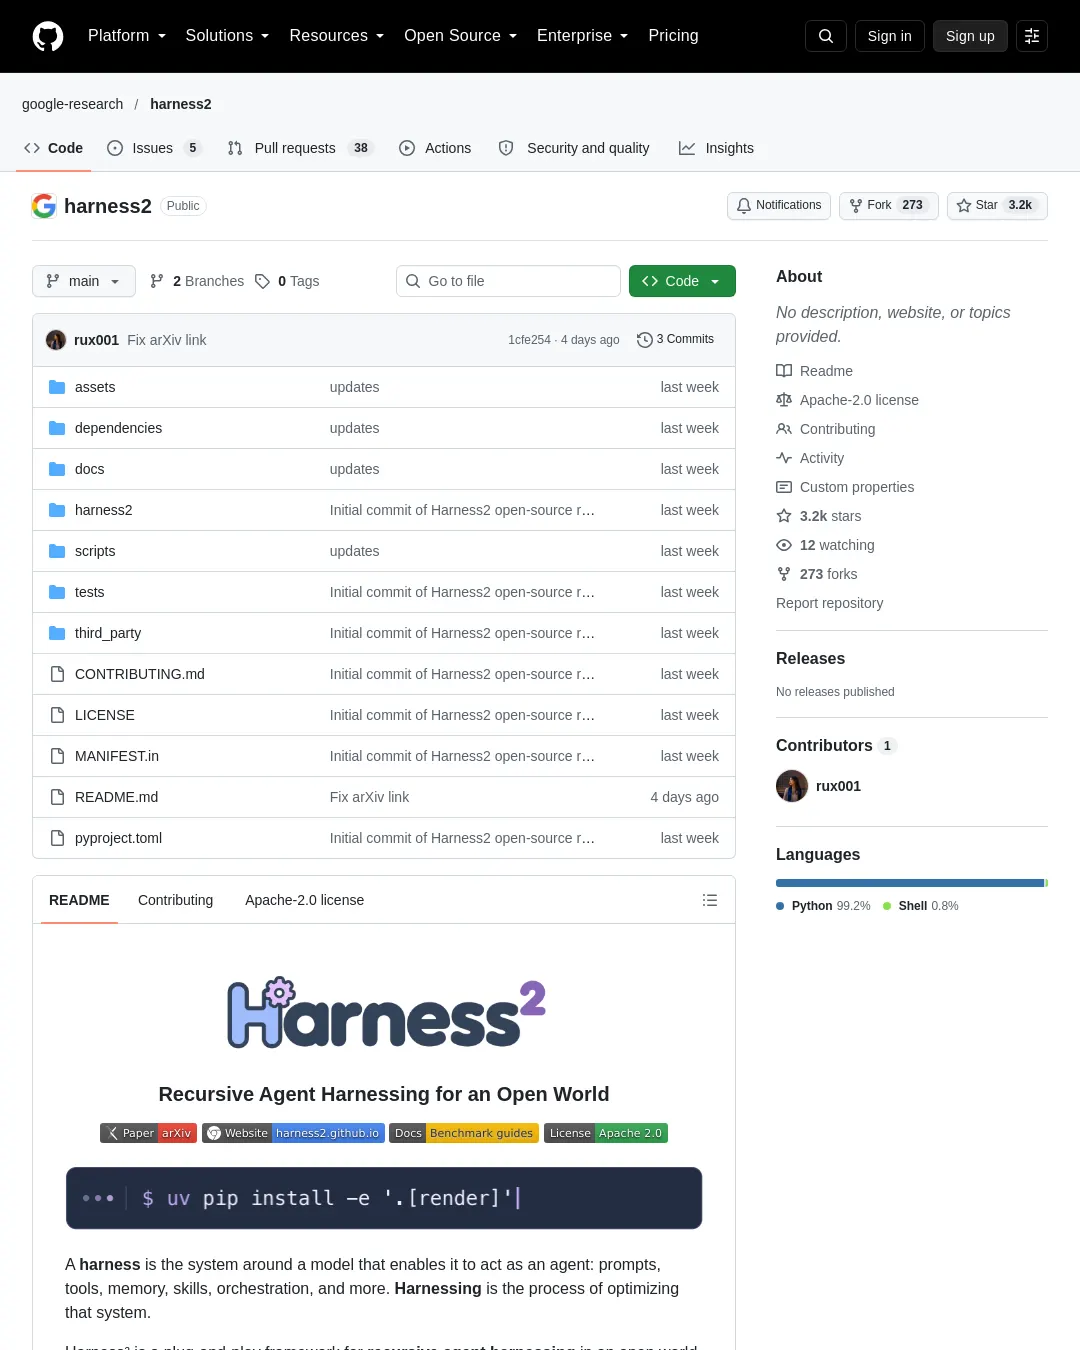
구글 리서치가 모델 가중치를 고정한 채 에이전트의 실행 환경을 반복 개선하는 오픈소스 프레임워크 Harness²를 공개했다. JobBench, LAB, WorkBuddy-Bench 평가에서 한 차례 개선으로 GLM-5와 Gemini 3.5 Flash의 성능이 기본 실행 환경보다 높아졌다고 보고했다.
Harness는 모델이 에이전트로 작동하도록 돕는 프롬프트, 도구, 메모리, 기술, 오케스트레이션 등의 시스템을 뜻한다. Harness²는 두 수준의 반복 개선을 결합한다. 작업 수준에서는 정답 피드백 없이 같은 작업에서 실행 결과를 비교해 실행 환경을 다듬는다. 이후 하네스 수준에서는 채택된 실행 환경과 근거가 뒷받침된 교훈을 축적해 다음 작업의 개선에 활용한다.
제작진이 공개한 결과에 따르면 네 가지 모델·하네스 구성으로 세 가지 업무 벤치마크를 평가했을 때, 한 번의 Harness² 단계에서 WorkBuddy-Bench는 최대 11.5점, JobBench는 최대 4.5점, LAB의 부분 통과율은 최대 11.8%포인트 개선됐다. 작업 수준의 반복 개선 예산을 늘리면 추가 향상도 나타났다. 이 수치는 해당 벤치마크와 구성에서 나온 결과다.
실행 환경에서 편집할 수 있는 항목은 시스템 프롬프트, 가드레일, 메모리, 도구 안내, 하위 에이전트, 기술, 스크립트, 플러그인 등 8가지다. 프레임워크는 병렬·순차 반복 개선과 OpenCode·Codex 실행기를 지원한다.
설치와 사용 조건
로컬 데모에는 Linux, Python 3.12, uv가 필요하며 모델 인증 정보 없이 실행할 수 있다.
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
모델을 사용하는 벤치마크 실행에는 Node.js 20 이상과 Google Cloud CLI, 벤치마크별 의존성이 필요하다. LAB에는 Pandoc과 Poppler, WorkBuddy-Bench에는 Docker가 추가로 필요하다. 모델 기반 실행에는 API 비용이 발생하므로 작은 작업 선택부터 시작하라고 안내한다.
harness2-setup lab
harness2-check --bench lab
harness2 --bench lab --k 1 --mode parallel \
 --only-domains antitrust-competition --max-tasks 1
harness2-judge --bench lab --k 1 --mode parallel
harness2-report --bench lab --k 1 --mode parallel
--k는 작업 수준 반복 개선 예산이다. 병렬 방식은 후보 실행 환경을 넓게 탐색하고, 순차 방식은 개선된 환경과 축적된 근거를 다음 단계로 이어간다. 평가와 보고 명령에는 개선 실행과 동일한 벤치마크, 실행기, 작업 선택, --k, 모드, 시드를 사용해야 한다. --dry-run을 붙이면 모델을 호출하지 않고 작업 선택을 미리 확인할 수 있다.
지원 벤치마크는 전문 업무용 JobBench, 법률 업무용 LAB, 사무·웹·코드 작업용 WorkBuddy-Bench다. WorkBuddy-Bench는 office, web, code 하위 집합을 선택할 수 있다.
실행기는 네트워크 접근이 제한되지 않으며 Codex는 샌드박스가 비활성화된 상태로 실행된다. 공개된 벤치마크 평가 기준에 접근할 수 있으므로, 평가 전에 벤치마크 정답과 채점 기준에 접근하지 못하도록 네트워크 제한을 설정해야 한다. 결과물은 runs/에 저장되며 같은 명령을 다시 실행하면 이어서 진행한다. 모델이나 작업 선택을 바꾸는 경우에는 새 HARNESS2_RUNS_DIR을 사용하도록 안내한다.
Harness²는 Apache 2.0 라이선스로 공개됐지만, 공식 지원을 받는 구글 제품은 아니다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요