TL;DR
- 분할 학습(Split Learning) 언어 모델에서 GPT-2 클라이언트 계층의 공개 가중치만 가진 공격자는 활성값만으로 토큰의 94.20%를 복원하고, 그래디언트까지 관측하면 97.38%를 복원함.
- 그래디언트 관측으로 토큰 복원율은 3.17%포인트 상승하지만, 32토큰 문서를 완전히 복원하는 비율은 13.71%에서 37.77%로 크게 높아짐.
- 비밀 믹스업(Secret Mixup)은 문서 전체를 정확히 복원하는 공격을 거의 막지만, 토큰 복원율은 여전히 83~91%임.
- GPT-2와 Qwen3-0.6B 실험에서 서버가 학습하는 연속 계층의 시작 위치는 계층 수가 같아도 모델 품질과 정보 유출에 영향을 줌.
- 정보 유출은 토큰별·문서별로 모두 보고해야 하며, 분할 모델이 전송하는 데이터를 원문만큼 민감하게 취급해야 함.
연구 개요
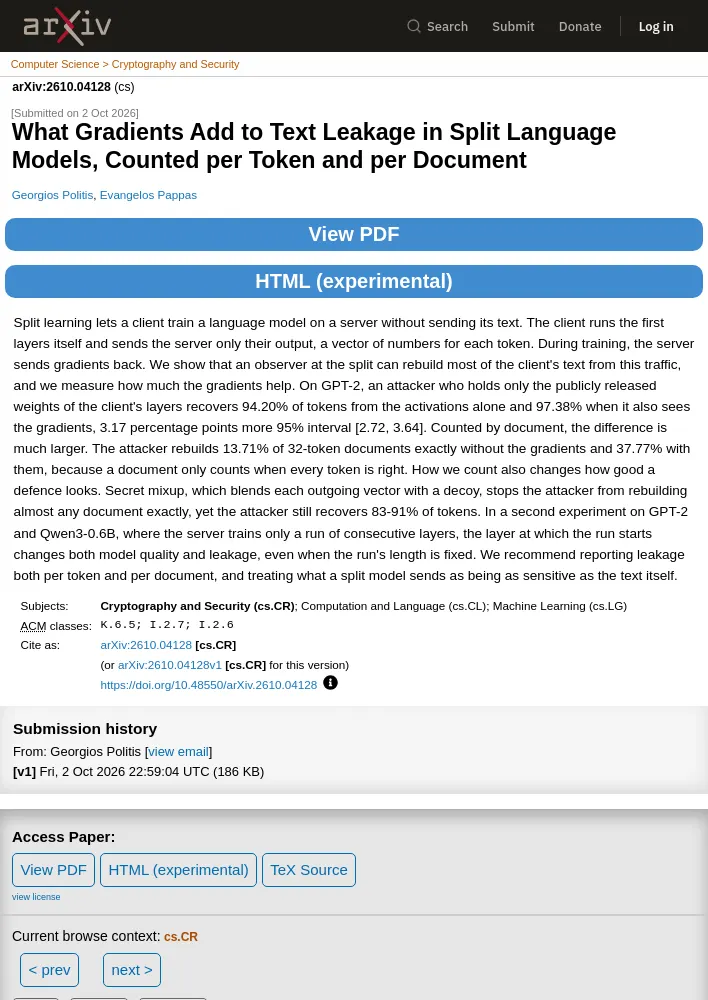
- Georgios Politis와 Evangelos Pappas의 논문은 분할 학습에서 클라이언트와 서버 사이에 오가는 데이터로부터 텍스트가 얼마나 복원되는지, 특히 그래디언트(gradient)가 유출에 얼마나 더해지는지 측정함.
- 클라이언트는 언어 모델의 앞부분 계층을 실행하고 토큰마다 숫자 벡터인 활성값(activation)을 서버에 전송하며, 학습 중 서버는 그래디언트를 클라이언트로 돌려보냄.
- 연구진은 분할 지점의 통신을 관찰하는 공격자가 클라이언트 텍스트의 대부분을 복원할 수 있음을 보이고, 토큰별 및 문서별 측정치를 비교함.
GPT-2의 복원 결과
- 공격자가 클라이언트 계층의 공개 가중치만 보유한 경우, 활성값만으로 토큰의 94.20%를 복원함. 그래디언트도 관측할 경우 복원율은 97.38%로, 3.17%포인트 상승함(95% 구간: 2.72~3.64).
- 32토큰 문서는 모든 토큰이 맞아야 정확히 복원된 것으로 계산함. 이 기준에서 그래디언트가 없을 때 정확 복원 비율은 13.71%, 그래디언트가 있을 때는 37.77%임.
- 따라서 문서 전체를 기준으로 측정하면 그래디언트가 더하는 유출 규모가 토큰별 복원율의 차이보다 훨씬 크게 나타남.
방어 기법과 측정 기준
- 비밀 믹스업은 전송되는 각 벡터를 미끼 벡터(decoy)와 혼합하는 방식임.
- 이 방식은 공격자가 문서를 거의 하나도 완벽하게 복원하지 못하게 하지만, 토큰 복원율은 여전히 83~91%임.
- 연구진은 방어 효과를 판단할 때 토큰별 복원율과 문서별 정확 복원율을 함께 보고할 것을 권고함.
계층 위치에 따른 차이
- 두 번째 실험은 GPT-2와 Qwen3-0.6B에서 서버가 연속된 계층 구간만 학습하는 설정을 다룸.
- 서버가 맡은 계층 구간의 길이가 고정돼 있어도, 구간이 시작되는 계층 위치에 따라 모델 품질과 정보 유출이 모두 달라짐.
권고와 논문 정보
- 분할 모델이 전송하는 데이터는 원문 텍스트만큼 민감하게 취급해야 함.
- 논문 제목은 “What Gradients Add to Text Leakage in Split Language Models, Counted per Token and per Document”이며, arXiv 식별자는 2610.04128임.
- 논문 DOI
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요