TL;DR
- 바둑과 체스의 경험적 원칙은 게임 중 계산하기에는 비용이 커 저장되는 지식이며, 인공지능(AI)도 학습 가중치 형태로 이를 가짐.
- AlphaGo의 가치 네트워크와 정책 네트워크에서 인간이 직접 단순한 원칙을 추출하기는 인간과 기계의 단순성 개념이 달라 어려움.
- 인간은 AlphaGo의 수를 암기할 수 있지만 그 결정의 배경을 내면화하거나 이해하지는 못함.
- Shin, Kim & Kim의 연구에서 AlphaGo 이후 인간의 바둑 실력 향상은 50수 이전에만 나타남.
- 강화학습을 거친 대형 언어 모델(LLM)이 자신의 수를 설명하더라도 그 설명이 실제 판단 과정을 반영한다고 기대할 근거는 부족함.
게임의 경험적 원칙
- 바둑이나 체스를 가르칠 때는 다년간의 경험으로 익히는 휴리스틱(heuristic)과 격언이 다수 필요함.
- 체스의 “가장자리의 나이트는 어리석음(knights on the rim are dim)”과 바둑의 “두 돌의 머리에서 한 수를 뻗음(hane at the head of two stones)” 등이 해당함.
- 두 게임의 포석 이론은 외워 둔 수로만 구성됨.
- 이러한 원칙은 데이터베이스의 구체화된 뷰(materialized view)와 비슷하게, 게임 중 계산하기에는 비용이 너무 커 저장되는 지식임.
- 이 지식은 게임의 본질적인 규칙 자체보다 복잡하지만 저장되어야 함.
인공지능의 휴리스틱
- 인공지능(AI)에도 이러한 경험적 원칙이 존재함.
- AlphaGo의 가치 네트워크(value network)는 학습된 가중치만을 바탕으로 바둑판의 형세에 ‘좋음’을 부여함.
- 이런 의미에서 가치 네트워크는 휴리스틱으로 구성됨.
- 가치 네트워크나 정책 네트워크(policy network)의 가중치 자체에서 좋은 플레이를 배우기는 어려움.
- 기계와 사람이 단순성에 대해 서로 다른 개념을 갖기 때문임.
- 따라서 기계가 하는 일을 관찰하고, 그 행동을 사람이 이해할 수 있는 규칙으로 증류해야 함.
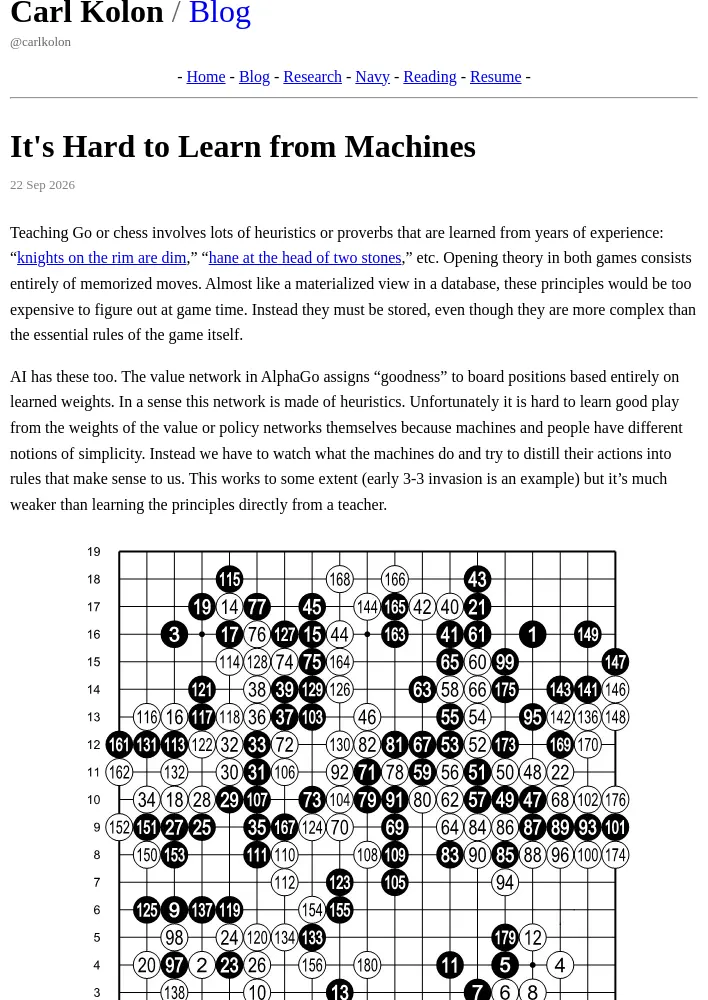
- 이 방식은 어느 정도 작동하며 이른 시점의 3-3 침입이 사례지만, 교사에게서 원칙을 직접 배우는 방식보다 훨씬 약함.
AlphaGo 이후 인간의 학습
- Shin, Kim & Kim은 「Human Learning from Artificial Intelligence: Evidence from Human Go Players’ Decisions after AlphaGo」에서 AlphaGo 이후 인간의 플레이가 향상되지만 50수 이전에만 해당함을 보임.
- 인간은 인공지능의 수를 암기할 수 있지만, 그 결정 뒤에 있는 내용을 내면화하거나 이해할 수는 없음.
설명 가능한 강화학습의 한계
- AlphaGo가 어떤 행동을 한 이유를 대형 언어 모델(LLM)에 물을 수 있지만, 이는 분명 어리석은 질문임.
- LLM이 그 이유를 어떻게 알 수 있는지에 대한 근거가 없기 때문임.
- LLM 자체가 바둑에서 강화학습(reinforcement learning, RL)을 거쳤다고 가정하면, 특정 수를 둔 이유를 물었을 때 좋은 답을 얻을 수 있을 듯함.
- 그러나 그 가능성을 기대해야 할 이유는 없음.
- LLM의 휴리스틱이 인간에게 설명 가능하다고 볼 근거가 없기 때문임.
- LLM은 그럴듯한 답을 말할 수 있지만, 원래 수를 선택할 때 ‘생각한’ 내용과 다를 수 있음.
- LLM은 좋은 수를 선택하도록 사후 학습(posttraining)됐지만, 그 수를 사람에게 설명하도록 학습된 것은 아님.
- 사람에게 설명하는 작업은 검증 가능성이 훨씬 낮은 과제임.
- 이러한 논리는 강화학습으로 학습된 다른 작업에도 확장된다고 판단됨.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요