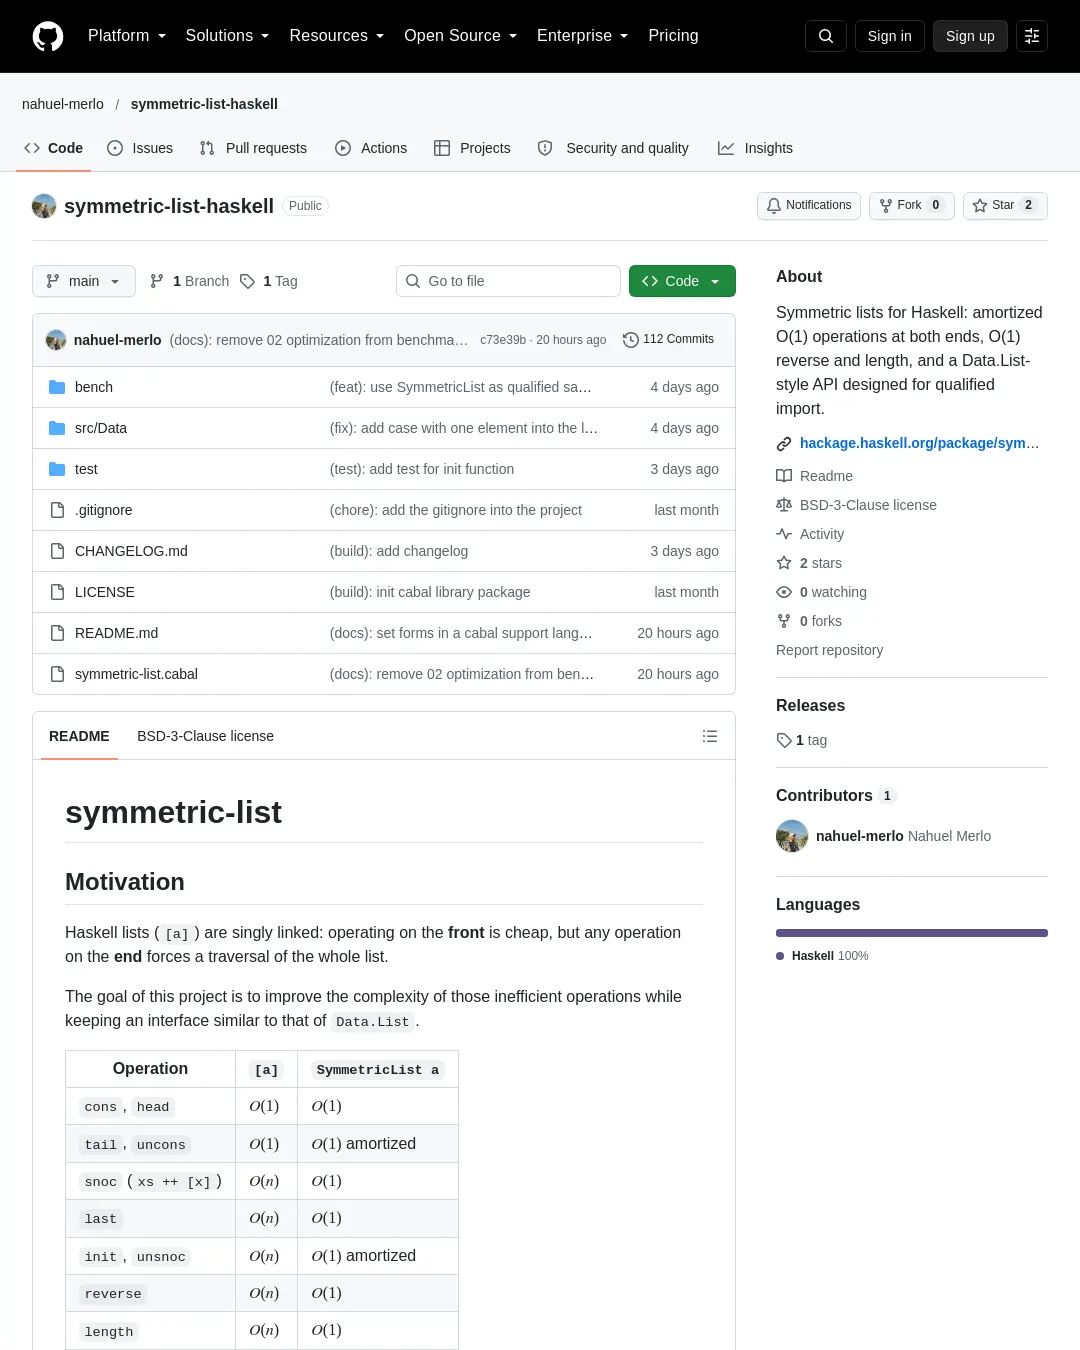
symmetric-list는 Haskell의 일반 리스트([a])와 비슷한 인터페이스를 제공하면서 양쪽 끝에서의 연산을 빠르게 처리하는 자료구조다. 제작자는 Data.List와 유사한 사용법을 유지하고, 양끝에서 자주 작업하는 경우의 연산 비용을 줄이는 것을 목표로 한다.
일반 리스트는 앞쪽 연산은 빠르지만 끝에서 원소를 추가하거나 읽으려면 전체를 순회해야 한다. 대칭 리스트는 리스트를 양쪽을 향하는 두 부분으로 나누고 각 부분의 길이를 저장한다. 이에 따라 snoc(끝에 추가), last, reverse, length는 모두 O(1)이며, tail, uncons, init, unsnoc은 분할 상환 O(1)이다. append의 비용은 두 리스트 길이 중 작은 값에 비례한다.
비교 대상에 따라 적합한 자료구조는 다르다. 무작위 접근이나 분할이 필요하면 Data.Sequence, 한쪽 끝에서 소비하는 큐에는 deque, 양끝을 사용하면서 Data.List와 비슷한 API를 원하면 symmetric-list를 쓰도록 안내한다.
제작자는 각 연산을 QuickCheck를 이용한 속성 기반 테스트로 Data.List의 대응 연산과 비교하고 있다. 다음 단계로 Liquid Haskell을 이용해 연산이 자료구조의 불변 조건을 보존하는지 형식 검증할 계획이다.
모듈은 Prelude의 head, last, reverse 등과 이름이 겹치므로 한정 임포트 방식으로 사용하도록 설계됐다.
import Data.SymmetricList (SymmetricList)
import qualified Data.SymmetricList as SymmetricList

xs :: SymmetricList Int
xs = SymmetricList.snoc 4 (SymmetricList.fromList [1, 2, 3])

-- SymmetricList.last xs == 4
-- SymmetricList.toList (SymmetricList.init xs) == [1, 2, 3]
-- xs <> xs == SymmetricList.append xs xs
타입과 그 연산은 같은 이름의 모듈에 두고 한정 임포트하며, <> 같은 연산자는 한정하지 않고 사용하는 방식이다. 이는 Haskell 라이브러리의 한정 임포트 설계 안내를 따른다.
내부 표현은 리스트를 두 부분으로 나눈 뒤 한쪽을 뒤집어 저장한다. 따라서 첫 원소는 왼쪽 부분의 머리에, 마지막 원소는 오른쪽 부분의 머리에 놓인다. 한쪽 부분이 비어 있으면 다른 쪽에는 원소가 최대 하나만 남도록 하는 불변 조건을 둬 양 끝 원소를 O(1)에 찾는다. 각 부분의 길이도 저장해 length를 O(1)에 처리하고, 재균형 조정 때 길이를 다시 순회해 셀 필요를 줄인다.
재균형 조정 자체는 O(n)이지만 한쪽이 비었을 때만 일어나며, 원소를 양쪽에 절반씩 나눈다. 제작자의 분할 상환 분석에 따르면 양끝에서 수행하는 연속 k회 연산의 총비용은 O(k)다.
벤치마크
벤치마크는 tasty-bench로 [1..n]을 대상으로 실행했다. 컴파일에는 GHC 9.10.3과 -O2를 사용했으며, 절대 시간은 실행 기계에 따라 달라질 수 있다. 결과를 리스트로 반환하는 snoc, init, unsnoc은 지연 평가 때문에 첫 생성자만 측정하지 않도록 [a] 결과를 정규형까지 평가했다.
n = 100,000인 개별 연산 결과는 다음과 같다.
| 연산 | SymmetricList | [a] | 속도 향상 |
|---|---|---|---|
last | 6.88 ns | 939 μs | 약 136,000배 |
reverse | 15.5 ns | 1.19 ms | 약 77,000배 |
snoc | 18.6 ns | 1.65 ms | 약 89,000배 |
init | 15.5 ns | 1.65 ms | 약 106,000배 |
unsnoc | 21.7 ns | 5.25 ms | 약 242,000배 |
length | 8.38 ns | 825 μs | 약 98,000배 |
n을 1,000에서 100,000으로 늘렸을 때 SymmetricList의 last 측정값은 8.11 ns, 6.95 ns, 6.88 ns였고, [a]는 1.50 μs, 17.6 μs, 939 μs였다. 제작자는 이 결과에서 대칭 리스트의 시간은 크기가 커져도 거의 일정하고 일반 리스트의 시간은 선형으로 늘었다고 설명한다.
끝에서 unsnoc을 반복해 리스트를 비울 때는 재균형 조정 비용도 측정에 포함했다. 이 작업은 [a]에서 O(n²), SymmetricList에서 O(n)이다.
| n | SymmetricList | [a] |
|---|---|---|
| 1,000 | 38.1 μs | 13.0 ms |
| 10,000 | 418 μs | 1.41 s |
| 100,000 | 6.50 ms | 실행하지 않음 |
[a]의 100,000개 원소 측정은 시간이 너무 오래 걸려 실행하지 않았다. 이 수치는 프로젝트가 제시한 벤치마크 결과이며, 실행 환경에 따라 절대 시간은 달라질 수 있다.
벤치마크 실행 명령은 다음과 같다.
cabal bench symmetric-list-bench
# export results
cabal bench symmetric-list-bench --benchmark-options='--csv bench.csv --svg bench.svg'
구현은 리처드 버드(Richard Bird)와 제러미 기번스(Jeremy Gibbons)의 *Algorithm Design with Haskell*에 나온 대칭 리스트 설명을 따른다. 참고 자료로 크리스 오카사키(Chris Okasaki)의 *Purely Functional Data Structures*도 제시했다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요