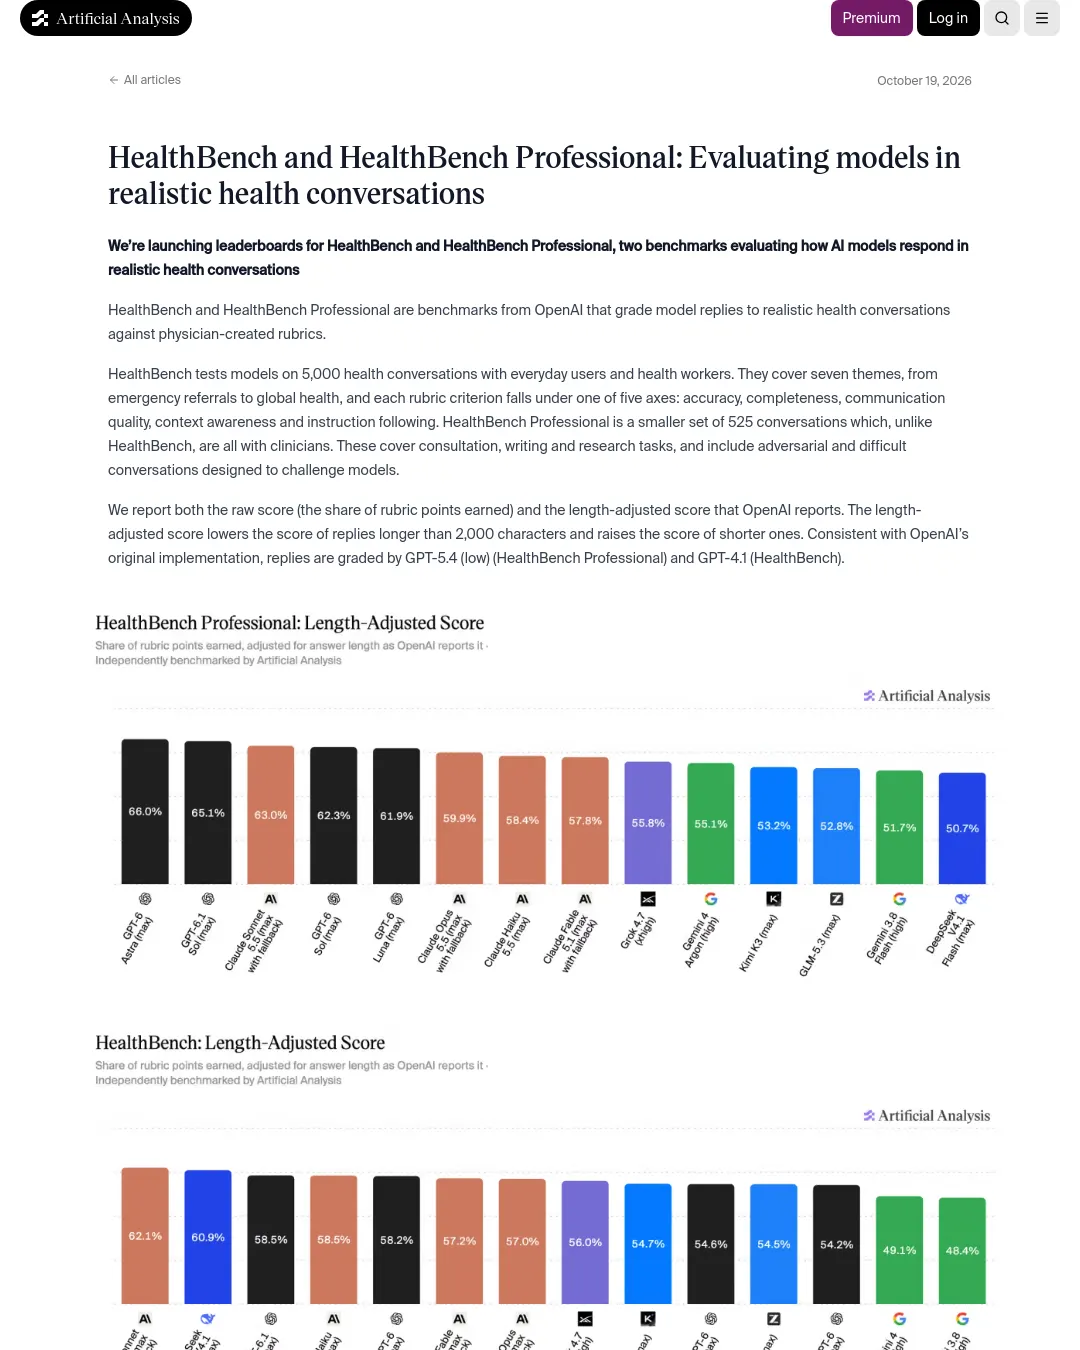
Artificial Analysis가 OpenAI의 두 벤치마크인 HealthBench와 HealthBench Professional을 평가한 모델 순위를 공개했다. 두 벤치마크는 의사가 만든 평가 기준으로 현실적인 건강 상담 대화에 대한 모델의 답변을 채점한다.
HealthBench는 일반 사용자와 의료 종사자가 나누는 건강 관련 대화 5,000건을 평가한다. 응급 진료 의뢰부터 세계 보건까지 7개 주제를 다루며, 평가 기준은 정확성·완전성·소통 품질·맥락 이해·지시 준수의 다섯 축으로 나뉜다. HealthBench Professional은 임상의와 나눈 대화 525건으로 구성되며, 상담·문서 작성·연구 과제와 모델에 도전하도록 설계한 적대적이고 어려운 대화를 포함한다.
Artificial Analysis는 평가 기준에서 얻은 점수의 비율인 원점수와 OpenAI가 보고하는 길이 조정 점수를 함께 제시했다. 길이 조정 점수는 답변이 2,000자를 넘으면 낮아지고, 그보다 짧으면 높아진다. 원래 OpenAI의 평가 방식을 따라 HealthBench Professional은 GPT-5.4 (low), HealthBench는 GPT-4.1이 답변을 채점한다.
HealthBench Professional에서는 GPT-6 Astra (max)가 길이 조정 점수 66.0%로 1위에 올랐다. GPT-6.1 Sol (max)은 65.1%, Claude Sonnet 5.5 (max with fallback)는 63.0%를 기록했다. 점수와 작업당 비용의 파레토 프런티어는 GPT-6 Luna (max, 61.9%, 0.004달러)부터 GPT-6 Sol (max, 62.3%, 0.036달러), GPT-6.1 Sol (max, 65.1%, 0.047달러), GPT-6 Astra (max, 66.0%, 0.27달러)까지 모두 OpenAI 모델로 구성됐다. GPT-6 Luna (max)는 GPT-6 Astra (max)보다 4점 낮았지만 비용은 2% 미만이었다.
Claude Opus 5.5와 Claude Fable 5.1은 답변당 평균 약 5,900자로, 2,000자 기준의 거의 3배였다. 길이 조정 후 두 모델은 11점 넘게 하락했다. 원점수 71.4%로 가장 높았던 Claude Opus 5.5 (max with fallback)는 조정 후 59.9%로 6위가 됐다. GPT-6 Sol (max)은 평균 약 1,600자로 2,000자 미만인 유일한 모델이었고, 길이 조정 후 점수가 오른 유일한 모델이었다.
HealthBench에서는 Claude Sonnet 5.5 (max with fallback)가 길이 조정 점수 62.1%로 1위를 차지했다. DeepSeek V4.1 Flash (max)는 60.9%, GPT-6.1 Sol (max)은 58.5%였다. 점수와 작업당 비용의 파레토 프런티어에는 GPT-6 Luna (max, 54.6%, 0.002달러), DeepSeek V4.1 Flash (max, 60.9%, 0.005달러), Claude Sonnet 5.5 (max with fallback, 평균 0.08달러)가 포함됐다. Claude Sonnet 5.5의 비용은 DeepSeek V4.1 Flash의 약 16배였으며, 점수 차이는 약 1점이었다.
HealthBench의 평가 축에서는 답변 길이에 따라 완전성과 소통 품질이 다르게 나타났다. GPT-6 Sol (max)은 약 1,000자로 가장 짧은 답변을 썼고 원점수 기준 소통 품질 점수는 81%로 가장 높았지만, 완전성 점수는 34%로 가장 낮았다. 완전성에서는 Claude Sonnet 5.5 (max with fallback)가 63%로 앞섰다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요