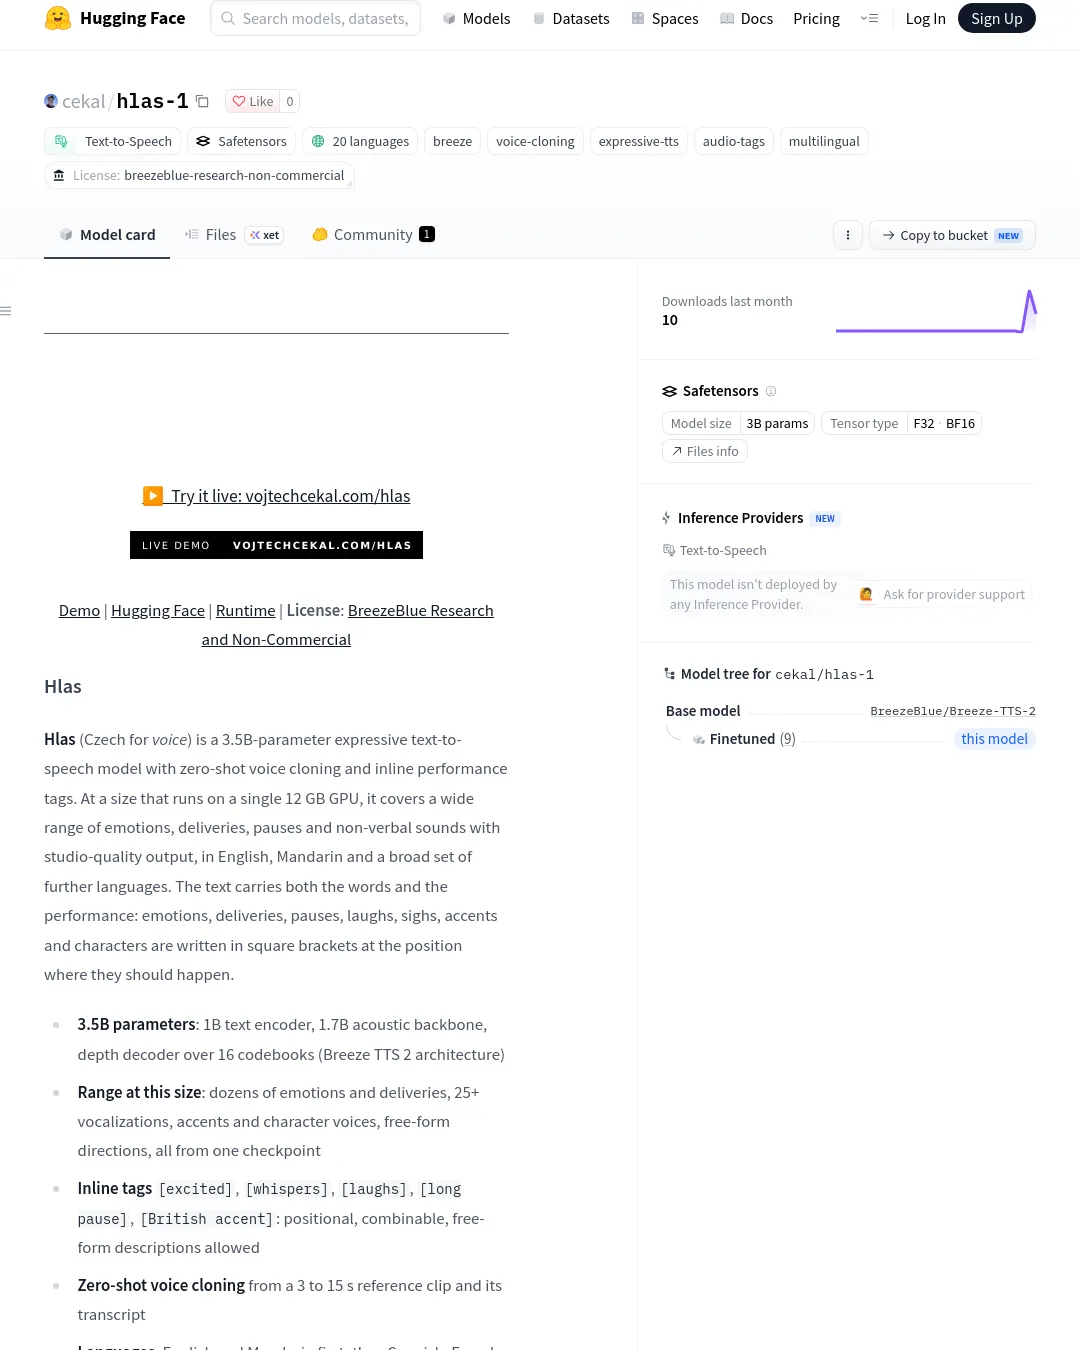
Hlas-1은 텍스트에 감정·말투·쉼표·웃음 같은 태그를 넣어 음성을 생성하는 3.5B 매개변수 텍스트 음성 변환 모델이다. 3~15초 분량의 음성과 정확한 대본을 제공하면 음색·억양·연령대 특성을 유지하는 음성 복제도 지원한다. 제작자는 12GB GPU 한 대에서 실행할 수 있다고 설명한다.
태그는 원하는 위치에 대괄호로 넣는다. [excited], [whispers], [laughs], [long pause], [British accent]처럼 미리 정해진 태그를 조합하거나 짧은 자유 형식 지시를 사용할 수 있다. 태그는 영어로 적으며, 영어와 중국어를 중심으로 스페인어·프랑스어·일본어·한국어 등 여러 언어를 지원한다고 안내한다. 출력은 모노 24kHz다.
브라우저 데모에서는 내장 음성, 음성 복제, 여러 화자가 등장하는 대본, 태그와 지시를 시험할 수 있다. 직접 실행하려면 Breeze TTS 런타임과 모델 파일을 사용한다. 제작자는 12GB GPU에서는 eager 모드를, 24GB GPU에서는 --fast-all 경로를 안내한다. 모델은 BreezeBlue Research and Non-Commercial License로 제공되며, 추론 런타임의 라이선스는 Apache-2.0이다.
모델 페이지 · 기반 모델 Breeze TTS 2 · 라이선스
부록: 원문 예시
text
curl -X POST http://127.0.0.1:7860/v1/audio/speech \ -F "ref_audio=@reference.wav" \ -F "ref_text=The exact transcript of the reference clip." \ -F "text=[sighs] Fine. If we miss it, it's on you. [laughs] Well, maybe that's fair." \ -F "seed=42" \ --output out.pcm
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요