TL;DR
- 사용자 평점이 적은 항목과 많은 항목을 함께 정렬할 때 단순 총점이나 평균 평점 대신 윌슨 점수 신뢰구간의 하한을 사용해야 함.
- 긍정 평점에서 부정 평점을 뺀 값은 평점 수가 많은 항목을 과도하게 높게 정렬할 수 있음.
- 단순 평균 평점은 긍정 평점이 2개이고 부정 평점이 0개인 항목을 긍정 평점이 100개이고 부정 평점이 1개인 항목보다 위에 놓는 문제를 보임.
- 윌슨 점수 하한은 긍정 평점의 비율과 적은 관측 수에 따른 불확실성을 함께 고려하며, 신뢰 수준 95%에는 z 점수 1.96을 사용함.
- 이 방법은 스팸 탐지와 ‘최고’ 목록 같은 비율 추정에도 활용 가능하며, 평점 수 대신 페이지 조회·다운로드·구매 수 대비 긍정 평점을 살펴볼 수도 있음.
문제
- 웹사이트에서 사용자가 항목에 평점을 매기고, 평점이 높은 항목을 위에 낮은 항목을 아래에 표시하려면 정렬에 사용할 점수가 필요함.
잘못된 해결책 1: 긍정 평점 수에서 부정 평점 수 빼기
- 점수를 긍정 평점 수 − 부정 평점 수로 계산하면 항목의 긍정 평점 비율보다 평점 수가 많은 항목이 앞설 수 있음.
- 긍정 평점 600개와 부정 평점 400개인 항목은 긍정 비율이 60%, 점수가 200임. 긍정 평점 5,500개와 부정 평점 4,500개인 항목은 긍정 비율이 55%, 점수가 1,000임.
- 이 방식은 긍정 비율이 더 낮은 두 번째 항목을 첫 번째 항목보다 위에 놓으므로 잘못된 정렬임.
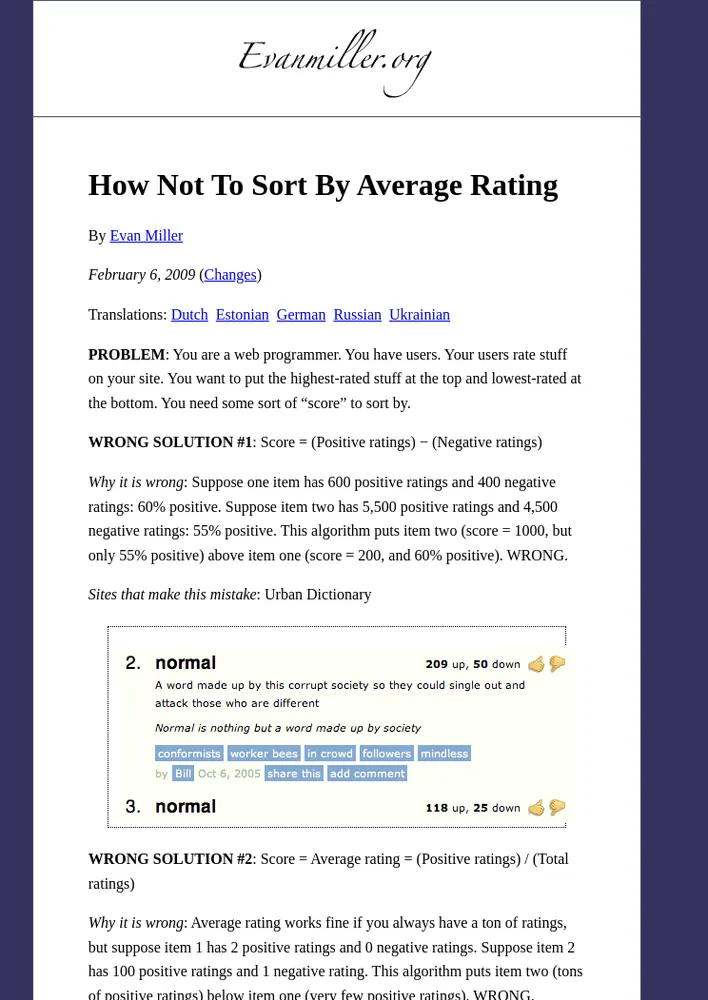
- 이 오류가 있는 사이트의 예시는 Urban Dictionary임.
잘못된 해결책 2: 평균 평점
- 점수를 긍정 평점 수 ÷ 전체 평점 수로 계산하는 평균 평점은 항상 많은 평점이 있는 경우에는 잘 작동하지만, 평점 수가 적은 항목을 제대로 평가하지 못할 수 있음.
- 항목 1은 긍정 평점 2개, 부정 평점 0개이고, 항목 2는 긍정 평점 100개, 부정 평점 1개인 사례임.
- 이 방식은 긍정 평점이 훨씬 많은 항목 2를 긍정 평점이 매우 적은 항목 1보다 아래에 놓으므로 잘못된 정렬임.
- 이 오류가 있는 사이트의 예시는 Amazon.com임.
올바른 해결책: 윌슨 점수 신뢰구간의 하한
- 평점 수가 적을 때는 긍정 평점 비율과 관측값의 불확실성을 함께 고려해야 하며, 이 계산법은 Edwin B. Wilson이 1927년에 정립한 것임.
- 핵심 질문은 “현재 보유한 평점을 바탕으로 실제 긍정 평점 비율이 적어도 어느 정도라고 95% 신뢰할 수 있는가?”이며, 윌슨 점수 신뢰구간이 그 하한을 제공함.
- 별점 5단계가 아닌 긍정·부정 평점만 고려하며, 하한을 계산할 때 공식의 플러스·마이너스 기호 중 마이너스를 사용함.
- 공식에서 p̂는 관측된 긍정 평점 비율, zα/2는 표준 정규분포의 (1−α/2) 분위수, n은 전체 평점 수임.
- 루비(Ruby) 구현에서는 전체 평점 수가 0이면 0을 반환하고, 그 외에는
Statistics2.pnormaldist로 z 점수를 구해 하한을 계산함. - 함수의 입력값 pos는 긍정 평점 수, n은 전체 평점 수, confidence는 통계적 신뢰 수준임. 예를 들어 0.95는 95%, 0.975는 97.5%의 신뢰 수준임.
- 이 함수에서 z 점수는 변하지 않으므로 통계 패키지가 없거나 성능이 중요하면 값을 고정할 수 있으며, 신뢰 수준 95%에는 1.96을 사용함.
SQL 구현
- 2012년 4월 업데이트에서는 긍정·부정 평점 열이 있는
widgets테이블을 대상으로, 평점 합계가 0보다 큰 항목의 95% 신뢰구간 하한을 계산해 내림차순으로 정렬하는 SQL 예시를 제시함. - 복잡한 SQL의 결과가 유용한지 확인하려면 긍정 평점에서 부정 평점을 뺀 순긍정 평점 정렬 및 평균 평점 정렬 결과와 비교할 수 있음.
- 이 계산을 대규모 데이터베이스에서 실행하기 전에 인덱스를 적절히 사용하는 방법을 데이터베이스 관리자와 확인할 필요가 있음.
엑셀 구현
- 2016년 3월 업데이트에서는 긍정 투표와 부정 투표 열을 이용해 같은 신뢰구간 하한을 계산하는 엑셀 수식을 제시함.
- 수식은 오류가 발생하면 0을 반환하도록
IFERROR를 사용함.
적용 사례
- 이 방법은 Chuck Norris식 사실 생성기를 위해 처음 고안됐으며, 이후 Reddit, Yelp, Digg 같은 서비스에서도 사용됨.
그 밖의 활용
- 윌슨 점수 신뢰구간은 정렬에만 쓰이지 않으며, 어떤 행동을 한 사람의 비율을 신뢰도와 함께 추정할 때 활용 가능함.
- 활용 예시는 다음과 같음.
- 스팸·악용 탐지: 항목을 본 사람 중 몇 퍼센트가 스팸으로 표시하는지 추정함.
- ‘최고’ 목록 작성: 항목을 본 사람 중 몇 퍼센트가 해당 항목을 ‘최고’로 표시하는지 추정함.
- ‘이메일 전송 최다’ 목록 작성: 페이지를 본 사람 중 몇 퍼센트가 이메일 전송을 누르는지 추정함.
- ‘최고 평점’ 목록에서는 평점 수 대비 긍정 평점 수보다 페이지 조회·다운로드·구매 수 대비 긍정 평점 수가 더 유용할 수 있음.
- 평범하다고 느낀 많은 사람은 평점을 남기지 않으므로, 항목을 보거나 구매한 뒤 평점을 남기지 않은 행동도 품질에 관한 유용한 정보를 담음.
변경 사항
- 2016년 4월 20일: Alessandro Apolloni의 도움으로 엑셀 구현을 추가함.
- 2012년 4월 4일: 새 SQL 구현을 추가함.
- 2011년 11월 13일: 통계적 신뢰도 설명을 수정하고 그에 맞춰 코드 예시를 변경함.
- 2월 15일: 통계적 검정력 예시를 명확히 함.
- 2월 13일, 두 번째 변경: ‘그 밖의 활용’을 추가함.
- 2월 13일: 전반적인 설명을 명확히 하고 관련 위키백과 문서 링크를 추가함.
- 2009년 2월 12일: ‘잘못된 해결책 1’의 예시 오류를 수정함.
참고 문헌
- 이항 비율 신뢰구간(위키백과).
- Alan Agresti와 Brent A. Coull, 1998년, “이항 비율 구간 추정에서는 ‘정확한’ 방법보다 근사 방법이 낫다”, *The American Statistician*, 52권, 119~126쪽.
- E. B. Wilson, 1927년, “확률적 추론, 계승의 법칙, 통계적 추론”, *Journal of the American Statistical Association*, 22권, 209~212쪽.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요