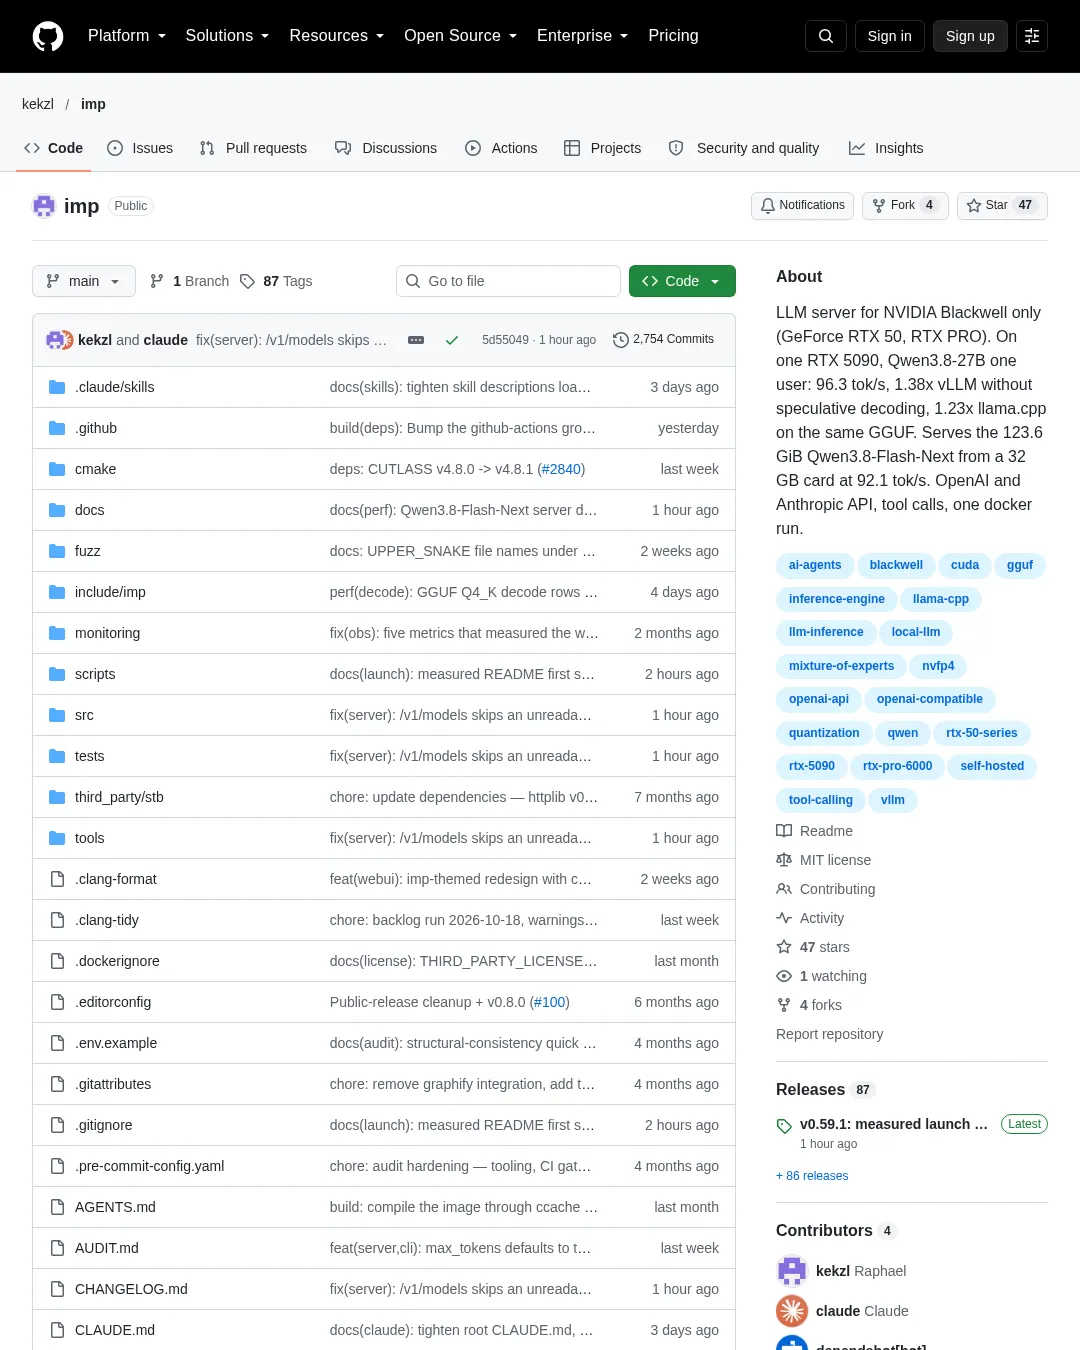
Imp는 NVIDIA Blackwell 기반 GeForce RTX 50 및 RTX PRO 카드 한 장에서 대형 언어 모델을 실행하는 서버다. OpenAI·Anthropic API와 내장 채팅을 제공하며, Linux 또는 WSL2에서 Docker로 구동한다. 제작자는 모든 코드를 Claude Code가 작성했다고 밝혔다.
프로젝트가 RTX 5090에서 측정한 결과, Qwen3.8-27B의 단일 사용자 처리량은 Imp 96.3토큰/초, vLLM 0.31.0은 69.9토큰/초였다. 32명 동시 요청의 총 처리량은 각각 1979.1, 1414.2토큰/초다. 측정은 짧은 프롬프트에 300토큰을 생성하고 서버를 새로 띄워 세 차례 시험한 중앙값이며, Imp와 vLLM은 같은 NVFP4 체크포인트를 사용했다. GGUF 파일을 기준으로 한 비교와 전체 조건·로그는 벤치마크 문서에 공개돼 있다.
Imp는 RTX 5090에서 시험됐으며, 다른 지원 카드에서도 같은 커널을 사용한다고 프로젝트는 설명한다. 멀티 GPU·CPU·다른 GPU는 지원하지 않는다. 고부하의 Qwen3-14B에서는 vLLM이 32명 동시 요청 기준 7.6% 앞섰다고 밝히며, GPU 테스트와 벤치마크는 유지관리자의 RTX 5090에서만 실행된다. 세부 제약은 제한 사항 문서에 정리돼 있다.
실행에는 지원 GPU, Docker와 NVIDIA Container Toolkit, Linux 또는 WSL2가 필요하다. 아래 예시는 Qwen3.8-27B 모델을 내려받아 서버를 시작한다.
git clone https://github.com/kekzl/imp && cd imp
scripts/stage-model.sh kekzle/Qwen3.8-27B-NVFP4-vllm ~/models/Qwen3.8-27B-NVFP4-vllm # 1. weights, 19.2 GiB download
docker run --gpus all -v ~/models:/models -v imp-cache:/home/imp/.cache/imp \\
 -p 127.0.0.1:8080:8080 ghcr.io/kekzl/imp:latest --model /models/Qwen3.8-27B-NVFP4-vllm # 2. serve
로그에 Server listening이 표시되면 http://localhost:8080에서 채팅 화면을 열 수 있다. 앱과 코딩 에이전트는 http://localhost:8080/v1, Anthropic API를 쓰는 앱은 http://localhost:8080/v1/messages를 기본 주소로 지정한다. 설치 절차와 카드별 모델 선택은 빠른 시작 안내에서 확인할 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요