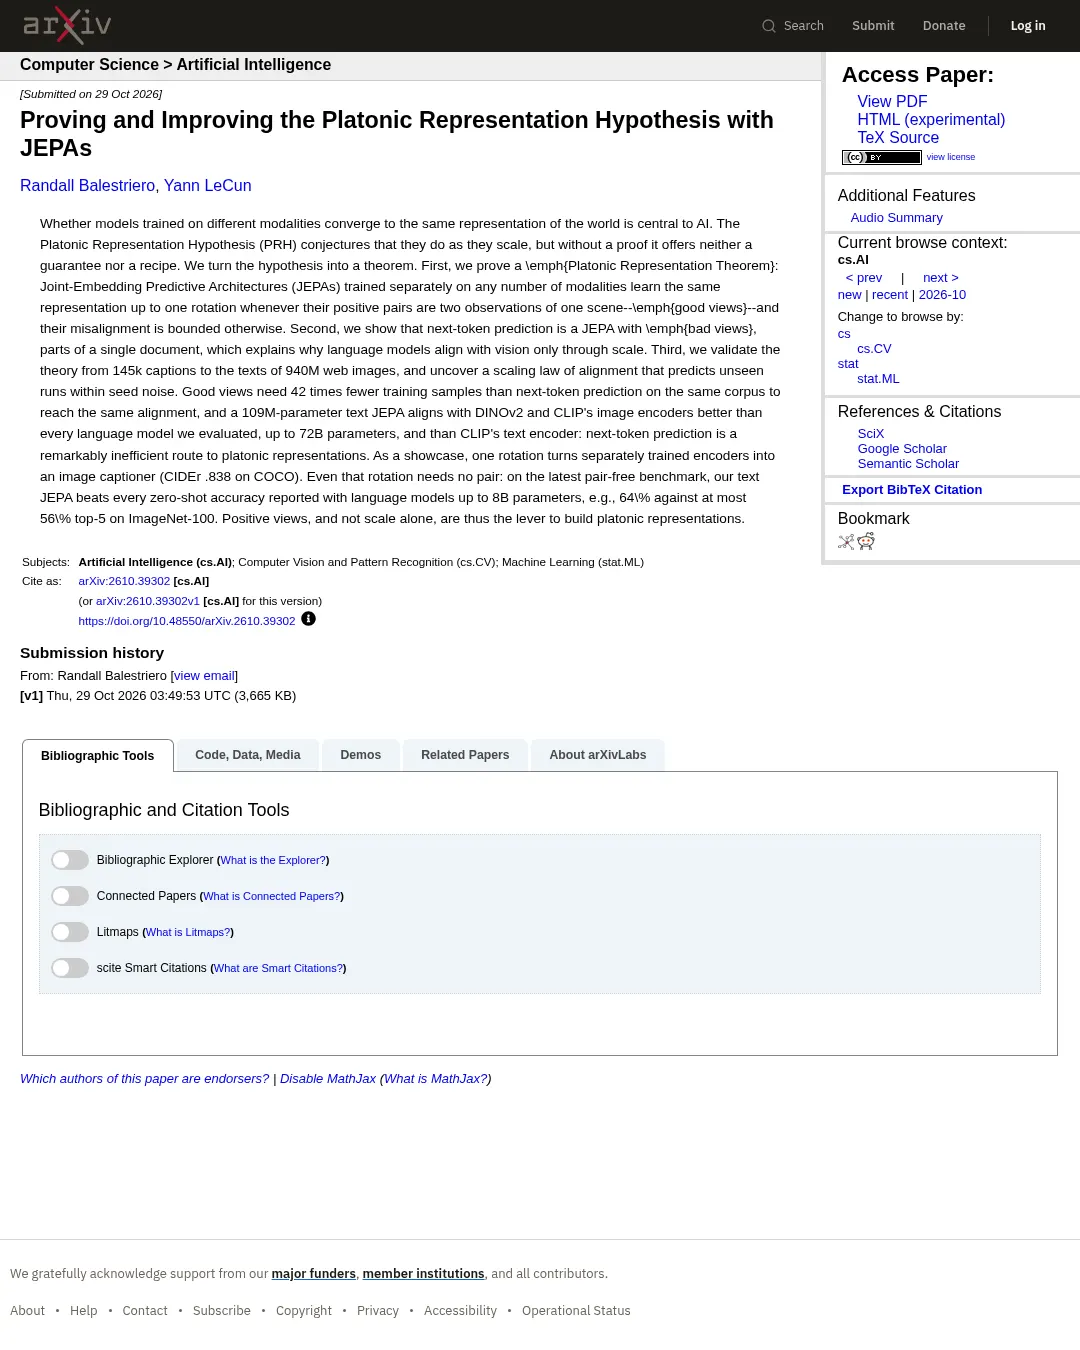
랜들 발레스티에로(Randall Balestriero)와 얀 르쿤(Yann LeCun) 등은 서로 다른 데이터 유형으로 학습한 모델이 같은 세계 표현을 얻는 조건을 정리한 논문을 공개했다. 연구진은 장면을 함께 보여주는 학습 데이터가 다음 토큰 예측보다 적은 학습 표본으로 정렬을 달성할 수 있다고 주장한다.
논문은 공동 임베딩 예측 아키텍처(Joint-Embedding Predictive Architecture, JEPA)를 서로 다른 유형의 데이터로 각각 학습해도, 학습 쌍이 같은 장면을 담은 ‘좋은 뷰’라면 표현이 하나의 회전 변환을 제외하고 같아진다는 정리를 제시한다. 좋은 뷰가 아닌 경우에는 두 표현의 불일치가 제한되는 조건을 둔다.
연구진은 다음 토큰 예측도 JEPA의 한 형태로 볼 수 있지만, 문서의 서로 다른 부분을 학습 쌍으로 삼는 ‘나쁜 뷰’를 사용한다고 설명한다. 이 관점에서 언어 모델이 시각 표현과 정렬되려면 규모가 커져야 하는 이유를 제시한다.
145,000개 캡션부터 9억 4,000만 개 웹 이미지의 텍스트까지 실험했으며, 정렬의 스케일링 법칙이 시드에 따른 변동 범위 안에서 실험하지 않은 실행 결과를 예측했다고 보고했다. 같은 정렬 수준에 이르는 데 좋은 뷰는 동일한 데이터셋의 다음 토큰 예측보다 학습 표본이 42배 적게 필요했다는 게 연구진의 설명이다.
109M 파라미터 텍스트 JEPA는 DINOv2와 CLIP 이미지 인코더에, 평가한 최대 72B 파라미터 언어 모델과 CLIP 텍스트 인코더보다 더 잘 정렬됐다. 연구진은 두 인코더를 학습한 뒤 하나의 회전 변환을 적용해 이미지 설명 생성기로 활용하는 사례도 제시했으며, COCO에서 CIDEr 0.838을 기록했다고 밝혔다. 쌍이 없는 최신 벤치마크에서도 텍스트 JEPA는 최대 8B 파라미터 언어 모델의 제로샷 정확도 보고치를 모두 넘어섰고, ImageNet-100 톱5 정확도는 64%로 언어 모델의 최대 56%와 비교됐다.
논문은 arXiv에서 확인할 수 있으며, PDF와 실험용 HTML도 제공된다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요