TL;DR
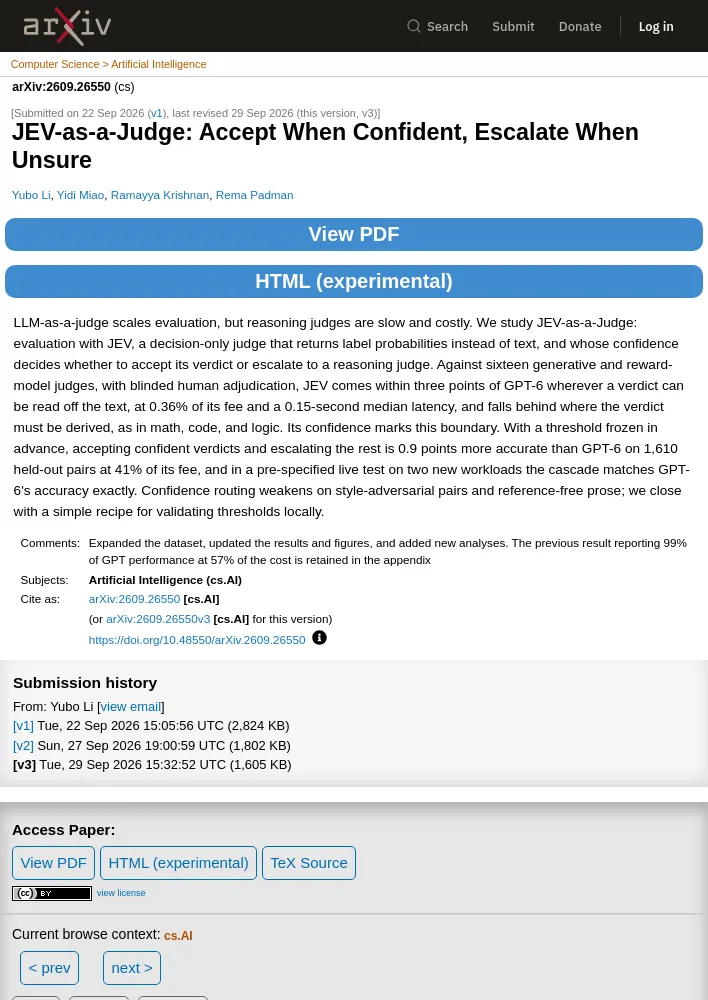
- JEV-as-a-Judge는 판정이 텍스트에서 직접 드러나는 과제에서 GPT-6 비용의 0.36%로 3점 이내의 정확도를 보이며, 자신감이 낮은 판정은 추론형 심판으로 넘기는 방식임.
- JEV는 텍스트 대신 라벨별 확률을 반환하는 판정 전용 심판이며, 자신감 점수로 판정 수용 여부와 상위 심판 이관 여부를 정함.
- 수학·코드·논리처럼 텍스트로부터 판정을 도출해야 하는 과제에서는 JEV의 성능이 뒤처지며, 자신감 점수가 이 경계를 포착함.
- 사전 고정한 임계값으로 자신 있는 판정은 수용하고 나머지는 상위 심판으로 넘긴 결과, 1,610개 홀드아웃 쌍에서 GPT-6보다 정확도가 0.9점 높고 비용은 41%였음.
- 두 가지 신규 작업 부하를 대상으로 사전 지정한 실시간 시험에서는 GPT-6과 정확도가 같았으며, 스타일 교란 쌍과 참조 자료 없는 산문에서는 자신감 기반 라우팅의 성능이 약해짐.
연구 개요
- 대형 언어 모델 심판(LLM-as-a-judge)은 평가를 확장할 수 있지만, 추론형 심판은 속도가 느리고 비용이 높다는 문제를 다룸.
- JEV-as-a-Judge는 텍스트 판정문 대신 라벨 확률을 반환하는 결정 전용 심판 JEV를 평가에 활용하며, 자신감에 따라 판정을 수용하거나 추론형 심판으로 넘기는 방식임.
- 생성형 심판과 보상 모델 심판 16종을 비교 대상으로 삼고, 평가 판정은 블라인드 처리된 사람의 검토를 거침.
성능과 적용 경계
- 정답 판정을 텍스트에서 직접 읽을 수 있는 과제에서 JEV는 GPT-6에 3점 이내로 근접하며, GPT-6 비용의 0.36%와 0.15초 중앙값 지연 시간을 기록함.
- 수학·코드·논리처럼 텍스트로부터 정답을 도출해야 하는 과제에서는 JEV의 성능이 뒤처짐.
- JEV의 자신감 점수는 텍스트에서 판정을 직접 읽을 수 있는 경우와 판정을 도출해야 하는 경우 사이의 경계를 나타냄.
자신감 기반 라우팅 결과
- 사전에 임계값을 고정하고, 자신감이 높은 판정은 수용하며 나머지는 추론형 심판으로 넘기는 방식을 적용함.
- 1,610개 홀드아웃 쌍에서 이 방식은 GPT-6보다 정확도가 0.9점 높았고, 비용은 GPT-6의 41%였음.
- 두 가지 신규 작업 부하에 대한 사전 지정 실시간 시험에서 연쇄 심판 방식은 GPT-6과 정확도가 정확히 같았음.
- 스타일 교란 쌍과 참조 자료가 없는 산문에서는 자신감 기반 라우팅의 성능이 약해짐.
- 임계값을 각 환경에서 검증하는 간단한 절차를 제시함.
논문 정보
- 논문 제목: JEV-as-a-Judge: Accept When Confident, Escalate When Unsure.
- 저자: Yubo Li, Yidi Miao, Ramayya Krishnan, Rema Padman.
- 분야: 인공지능(AI), 컴퓨터 과학.
- 제출일: 2026년 9월 22일(v1); 최종 수정일: 2026년 9월 29일(v3).
- 인용 정보: arXiv:2609.26550 [cs.AI].
- DOI: https://doi.org/10.48550/arXiv.2609.26550.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요