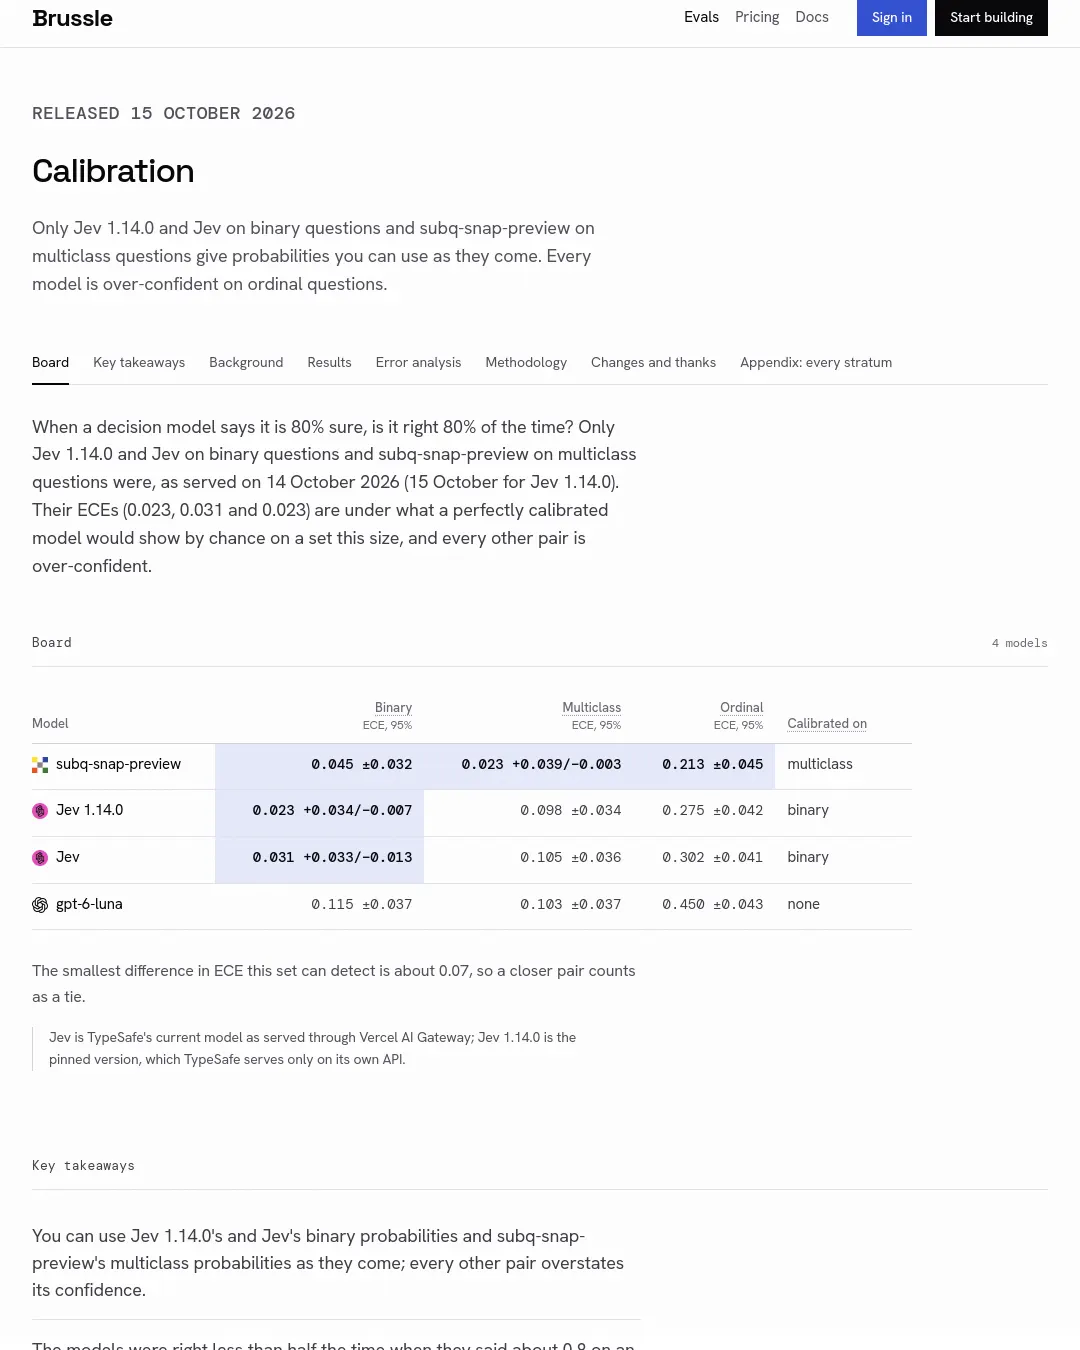
Brussle의 평가에서 Jev 1.14.0은 이진 질문, subq-snap-preview는 다중 선택 질문의 확률을 보정 없이 활용할 수 있는 모델로 나타났다. 하지만 네 모델 모두 서열형 질문에서는 자신감을 실제 정답률보다 높게 제시했다.
평가는 사람 손으로 라벨링한 golden-v1의 질문 1,500개로 진행됐다. 이진·다중 선택·서열형 질문이 각각 500개다. 기대 보정 오차(ECE)는 낮을수록 모델의 확률과 실제 정답률이 잘 맞는다. 평가에선 Jev 1.14.0의 이진 ECE가 0.023, subq-snap-preview의 다중 선택 ECE가 0.023으로 보정 기준 안에 들었다. 그 밖의 모델·질문 유형 조합은 모두 과신으로 분류됐다.
서열형 질문에서는 가장 낮은 ECE를 기록한 subq-snap-preview도 0.213으로 보정 기준 0.066을 크게 웃돌았다. 이 모델이 0.7~0.9의 자신감을 제시한 답변은 실제로 48.2%만 맞았다. Jev 1.14.0은 해당 구간에서 34.5%, gpt-6-luna는 25.8%만 맞았다.
자동 승인처럼 확률에 기준값을 두는 업무에서는 이런 차이가 중요하다. 평가에 따르면 gpt-6-luna는 이진 질문에서 답변의 63.6%에 0.9 이상의 확률을 줬지만, 그 답변의 정답률은 77.8%였다. 모델이 제시한 확률을 그대로 승인 기준에 쓰면 확신이 실제보다 높은 답변을 통과시킬 수 있다.
평가진은 Brussle의 보정 방식을 질문 절반으로 맞춘 뒤 나머지 절반에서 시험했다. 보정 후 ECE는 12개 모델·유형 조합 가운데 8개에서 낮아졌으며, gpt-6-luna의 서열형 ECE는 0.450에서 0.078로 줄었다. 다만 이는 golden-v1에서의 결과이며, 평가진은 실제 사용자의 결과를 보장하지 않는다고 밝혔다. 테스트한 모델은 2026년 10월 14일에 제공된 버전이며 Jev 1.14.0은 10월 15일 기준이다.
부록: 원문 예시
2026-10-1430.0 (0.05)0$0.3654JevTypeSafeVercel AI Gateway
2026-10-1430.009 (0.05)0$0.2178subq-snap-previewSubQSubQ API
2026-10-1430.033 (0.05)0$0.1729Jev 1.14.0TypeSafeTypeSafe API
2026-10-151pinned, not checked1$0.1022KeyValueSet versiongolden-v1Run dates2026-10-14 and 2026-10-15Run, gpt-6-luna
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요