TL;DR
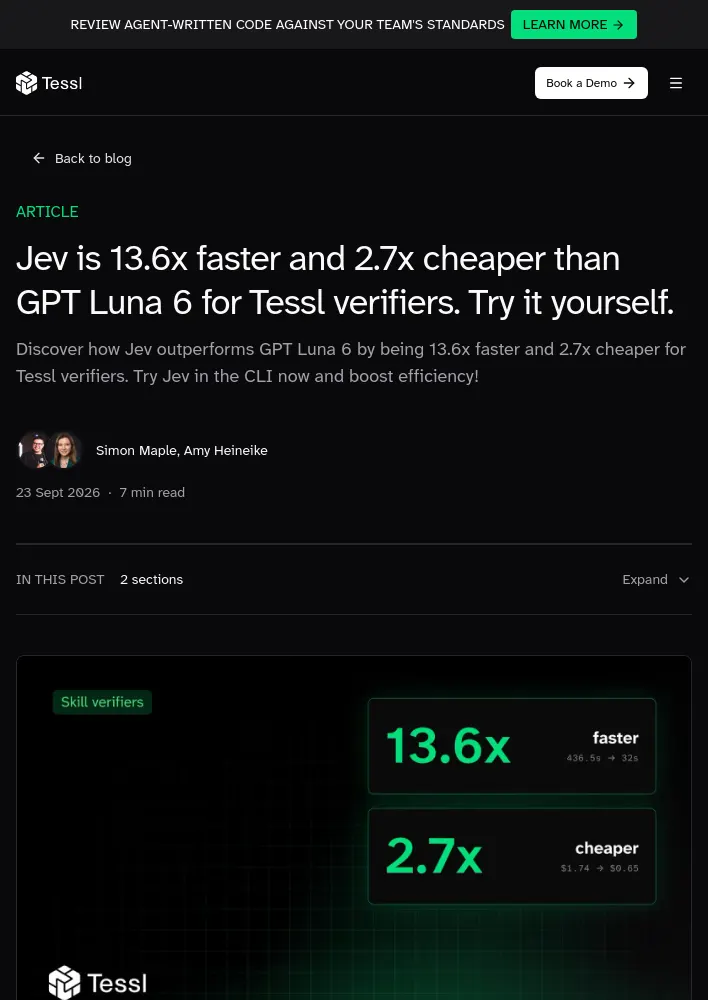
- Tessl의 내부 프로덕션 코드에서 약 2,725개의 verifier·파일 쌍을 평가한 결과, Jev가 GPT Luna 6보다 13.6배 빠르고 2.7배 저렴함.
- 여섯 개 프로젝트의 동일한 대상을 대상으로 게이트웨이 캐시를 우회해 모든 모델 호출이 새로 생성되도록 비교함.
- 전체 실행 비용은 GPT Luna 6의 예시 비용 1.74달러, Jev의 목록 가격 0.65달러이며, 실행 시간은 각각 436.5초와 32초임.
- 두 모델의 verifier 판정 일치율은 85.9%이며, Jev는 경고 수준의 문장 규칙에서 GPT Luna 6보다 관대한 경향을 보임.
- Tessl CLI에서
--model jev옵션으로 직접 실행할 수 있으며, 모델별 판단이 다른 파일을 살펴보는 방식으로 verifier 규칙을 조정할 수 있음.
Jev와 GPT Luna 6 비교 결과
- Tessl의 내부 프로덕션 코드에서 전체 verifier 테스트 스위트를 TypeSafe의 의사결정 모델인 Jev와 기존 판정 모델인 GPT Luna 6로 실행함. 테스트 규모는 여섯 개 프로젝트의 약 2,725개 verifier·파일 쌍이며, 두 모델에 동일한 대상을 적용하고 게이트웨이 캐시를 우회해 매번 새로 생성된 응답을 비교함.
- Jev는 기본 판정 모델인 GPT Luna 6보다 2.7배 저렴하고 13.6배 빠름. 비용과 시간은 다음과 같음.
- 약 2,725개 대상의 비용: GPT Luna 6(
gpt-6-luna) 1.74달러(예시 비용), Jev(jev-1.13.0) 0.65달러(목록 가격). - 대상 1,000개당 비용: GPT Luna 6 0.64달러, Jev 0.24달러.
- 실제 실행 시간: GPT Luna 6 436.5초, Jev 32초.
- 이전 판정 모델인 GPT Luna 5.6과 동일한 테스트 스위트를 비교했을 때 Jev는 6.6배 저렴하고 10배 빠름. Luna 6는 이전 모델보다 저렴하면서 느리므로 Jev의 비용 우위는 줄고 속도 우위는 커짐.
- Jev는 대화 응답을 생성하지 않고 질문과 문맥을 입력받아 확률이 포함된 결정을 반환하는 범용 분류기 형태의 의사결정 모델임.
- 소프트웨어 팀에서는 코딩 에이전트가 변경 사항을 빠르게 만들더라도 코드베이스의 규칙을 지켜야 함. 일부 규칙은 테스트나 기존 린터로 검사할 수 있지만, 사용자에게 표시되는 오류가 해결 방법을 알려주는지 또는 변경 사항이 설계 문서의 아키텍처를 따르는지처럼 코드 검토와 판단이 필요한 규칙도 있음.
- Tessl verifiers의 모델로 Jev를 사용할 수 있으며, Tessl CLI는 무료 설치 가능하고 시작을 위한 무료 사용 단계도 제공함.
Tessl verifiers와 평가 범위
- Tessl verifiers는 코드베이스에 저장하는 규칙으로, 무엇이 참이어야 하는지, 규칙이 언제 적용되는지, 판정 모델이 무엇을 확인해야 하는지를 정의함.
tessl.json에서 verifier가 적용될 파일을 제어함. CLI는 변경 사항이나 전체 코드베이스에서 필요한 검사를 효율적으로 실행하며, 로컬과 지속적 통합(CI) 환경에서 모두 사용할 수 있음.- 예를 들어 사용자에게 표시되는 리소스 누락 오류에는 구체적인 다음 단계가 포함되어야 한다는 규칙을 만들고, 이를 프런트엔드 코드베이스의 TypeScript 파일에만 적용하도록 설정할 수 있음.
- Tessl은 변경 사항에서 관련 파일을 찾거나
main브랜치 전체를 검사할 수 있음. 규칙은 관리 대상 코드와 함께 저장되므로 팀과 에이전트가 확인하고 개선할 수 있음. - 이 과정은 에이전트가 코드를 생성하고, verifiers가 이를 검사하며, 검토 피드백을 통해 규칙을 개선하는 반복 구조를 형성함.
- 예시 verifier는 Git 원격 URL에 인증 정보를 포함하지 않도록 규정함. Git 원격 URL을 구성하거나 기록하는 파일에 적용되며, 파일 내 URL에 토큰·비밀번호·개인 접근 토큰(PAT)이 없어야 하고 필요한 인증 정보는 환경 변수나 인증 정보 도우미에서 가져와야 한다고 검사함. 심각도는 오류 수준임.
판정 차이와 verifier 조정
- Jev와 GPT Luna 6는 verifier 판정의 85.9%에서 일치함. 차이는 주로 주석의 구조와 내용에 관한 규칙에서 나타났으며, Jev가 더 관대한 경향을 보임.
- 경고 수준의 문장 규칙에서는 GPT Luna 6가 파일의 50.1%를 실패로 판정한 반면 Jev는 30.4%를 실패로 판정함. 경고 수준의 코드 규칙에서는 두 모델의 차이가 더 작아 각각 15.3%와 10.3%임.
- 오류 처리 규칙 등 예상하지 못한 불일치도 발견했으며, 해당 차이는 계속 조사 중임.
- 사용할 판정 모델을 기준으로 verifier를 조정하는 방식을 권장함.
tessl-verify스킬의 방법에 따라 정답을 알고 있는 예시에서 두 모델을 모두 실행하고 차이를 살펴볼 수 있음. - 각 판정의 전체 응답도 출력 가능함. GPT Luna 6 결과에는 서술형 추론이 포함되고, Jev 결과에는 판정 확률이 포함되므로 서로 다른 방식으로 결과를 조사하고 규칙을 개선할 수 있음.
직접 재현하는 방법
- 비교는 몇 분 안에 재현할 수 있으며, 다른 팀의 규칙보다 자체 규칙에서 더 유용한 결과를 얻을 수 있음.
- 먼저 검토 의견으로 이미 시행 중인 규칙처럼 정답을 알고 있는 사례를 골라 verifier를 작성함. 전체 스키마와 작업 예시는 verifier 문서에서 확인할 수 있음.
tessl change verify --all로 기준 결과를 실행하고, 이어서--model jev를 지정해 다시 실행한 뒤 두 보고서를 비교함. 주목할 지표는 전체 일치율이 아니라 두 모델이 서로 다르게 판정한 구체적인 파일임.- Tessl CLI를 설치하고 저장소에서 초기화한 뒤, 기존 verifier를 Jev로 실행하려면
tessl change verify --model jev를 사용함. - 판정 호출 전에 전체 실행에서 검사할 파일을 확인하려면
tessl change verify --model jev --dry-run --all --show-files를 사용함. - 표본으로 실행하려면
tessl change verify --model jev --all --sample 20을 사용함. - verifier가 없다면 코딩 에이전트에
tessl-verify스킬을 사용해 검토 의견, 저장소 지침 또는 설계 문서에서 구체적인 규칙을 찾도록 요청할 수 있음. 에이전트가tessl.json의 verifier 파일과 적용 범위를 설정한 뒤 드라이 런과 표본 결과를 함께 검토하는 방식임. - Tessl 문서는 verifiers 구성과 CI에서 실행하는 방법도 안내함. 규칙을 저장소에서 확인하고 편집할 수 있도록 하는 것이 목표이며, 에이전트가 규칙 작성을 돕고 Jev가 검사를 보조하며 팀이 반복적으로 둘 다 개선하는 구조임.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요