TL;DR
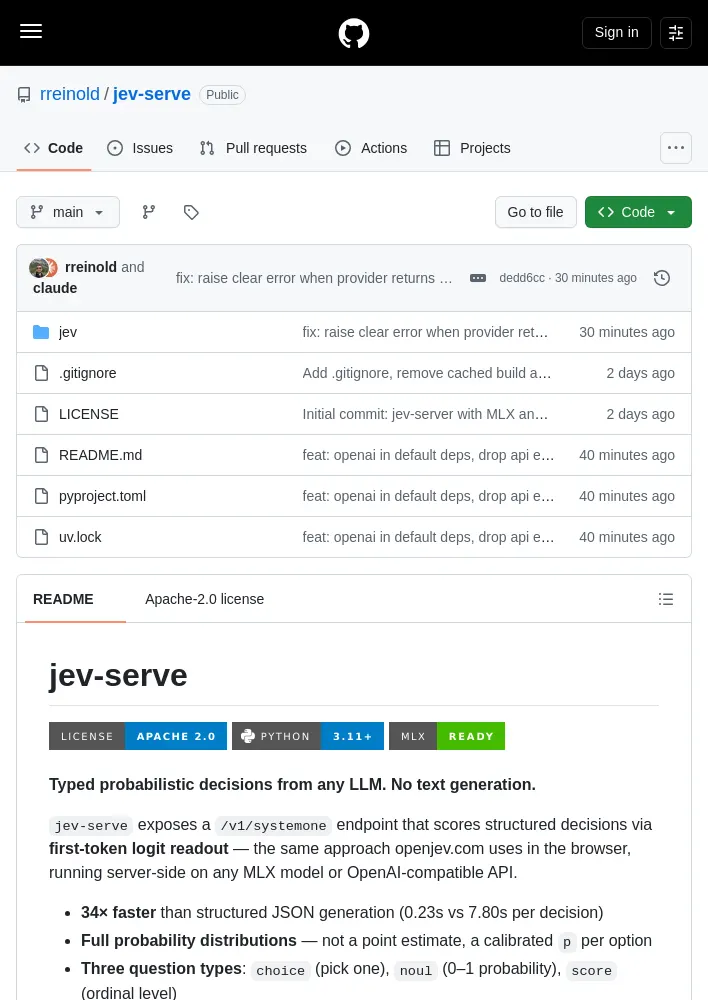
jev-serve는 MLX 모델 또는 OpenAI 호환 API에서 구조화된 판단을 텍스트 생성 없이 수행하고, 첫 토큰 로짓을 읽어 선택지별 확률을 제공함.- 구조화된 JSON 생성 방식보다 결정당 34배 빠르며 평균 지연 시간은 0.23초 대 7.80초임.
- 질문 유형은 선택지 하나를 고르는 choice, 0~1 확률을 출력하는 noul, 순서형 점수를 내는 score임.
- 각 질문에 대해 한 번의 순전파로 전체 확률 분포를 산출하며, 생성 토큰·JSON 파싱·환각 필드가 없음.
- 기본 백엔드는 Apple Silicon에서 실행되는 MLX이며,
--api옵션으로 Ollama·LM Studio·OpenAI 등과 호환되는 API를 사용할 수 있고 라이선스는 Apache 2.0임.
개요
jev-serve는 텍스트를 생성하지 않고 임의의 대형 언어 모델(LLM)에서 유형이 지정된 확률적 판단을 제공함./v1/systemone엔드포인트는 첫 토큰 로짓을 읽어 구조화된 결정을 점수화함. 이는 openjev.com이 브라우저에서 사용하는 방식과 같으며, 서버에서 모든 MLX 모델 또는 OpenAI 호환 API를 대상으로 실행됨.- 구조화된 JSON 생성보다 결정당 34배 빠름(0.23초 대 7.80초).
- 점 추정치가 아닌 선택지별 보정 확률을 포함한 전체 확률 분포를 제공함.
- 세 가지 질문 유형을 제공함: 선택지 하나를 고르는
choice, 0~1 확률인noul, 순서형 수준인score. - 기본 설정은 Apple Silicon에서 직접 추론하는 MLX이며,
--api옵션으로 OpenAI 호환 API로 전환 가능함. - Apache 2.0 라이선스이며 Jared Palmer의
kev에서 파생됨.
설치
- 기본 MLX 백엔드는 Apple Silicon에서 사용하며,
uv pip install -e "."로 설치함. - OpenAI 호환 API 백엔드를 함께 사용하려면
uv pip install -e ".[api]"로 설치함.
실행
- 기본 백엔드인 MLX에서는
jev-serve lmstudio-community/Qwen3.8-27B-MLX-6bit명령으로 로컬 모델을 직접 추론함. - Ollama, LM Studio, OpenAI 등의 API를 사용하려면
jev-serve qwen/qwen3.8-27b --api http://localhost:11434/v1로 실행함.
사용 예시
POST http://localhost:8008/v1/systemone요청은state에 차량과 소유자 정보를,questions에 판단할 질문을 전달함.- 예시의
top_mod질문은 배기·흡기·휠·오디오 중 가장 인기 있는 업그레이드 범주를 선택하는choice유형이며,wants_power질문은 소유자가 출력 향상에 주로 관심이 있는지 판단하는noul유형임. - 응답 예시에서
top_mod의 선택은exhaust, 신뢰도는 0.51, 선택지별 확률은 배기 0.64, 흡기 0.03, 오디오 0.05, 휠 0.28임. wants_power의noul값은 0.87이며, 전체 지연 시간은 190ms임.
질문 유형
choice:choice와 각 키의 확률을 출력하며, N개 선택지 중 하나를 고르는 데 사용함.noul: [0, 1] 범위의noul값을 출력하며, 예·아니요 확률에 사용함.score: 기대 수준인score와 확률을 출력하며, 순서형 평가에 사용함.
벤치마크 — Qwen3.8-27B · MLX · Apple M 시리즈
- 동일한 선택지 4개짜리 질문을 제품 20개에 순차적으로 적용했으며, 배치 처리는 사용하지 않음.
- 제품당 평균 시간은
jev-serve스크래치 모드가 0.23초, 구조화된 출력을 사용하는 디코더가 7.80초임. - 95백분위 지연 시간은 각각 약 0.31초와 약 11.2초임.
- 생성 출력 토큰은 스크래치 모드가 0개, 디코더가 약 23개임.
- 속도 향상은 34배이며, 기준선은 디코더임.
- 제품 1만 개 처리 시 벽시계 시간은 스크래치 모드가 0.6시간, 디코더가 21.7시간임.
- 확률 출력은 스크래치 모드가 선택지별 전체 확률이며, 디코더는 점 추정치만 제공함.
- 스크래치 모드는 스키마에 고정되어 환각 필드가 없으며, 디코더에서는 환각 필드가 관찰됨.
- 스크래치 모드는 순전파 한 번을 실행하고 로짓 위치 하나를 읽음. 디코더는 EOS가 나올 때까지 토큰을 하나씩 생성한 다음 JSON을 파싱함.
- 선택지 수와 출력 길이가 늘어날수록 성능 차이가 커짐.
작동 방식
- 텍스트를 생성하는 대신 프롬프트 다음 경계 위치에서 모델의 다음 토큰 로짓 분포를 읽고, 각 선택지의 첫 토큰을 추출한 뒤 소프트맥스로 정규화함.
- 질문마다 순전파 한 번을 수행하며, 샘플링·JSON 파싱·환각 필드가 없음.
- 브라우저에서
wllama를 사용하는 openjev.com의 방식과 동일함.
출처 및 라이선스
- openjev.com
kev, 저작권 2026 Jared Palmer, Apache 2.0 라이선스임.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요