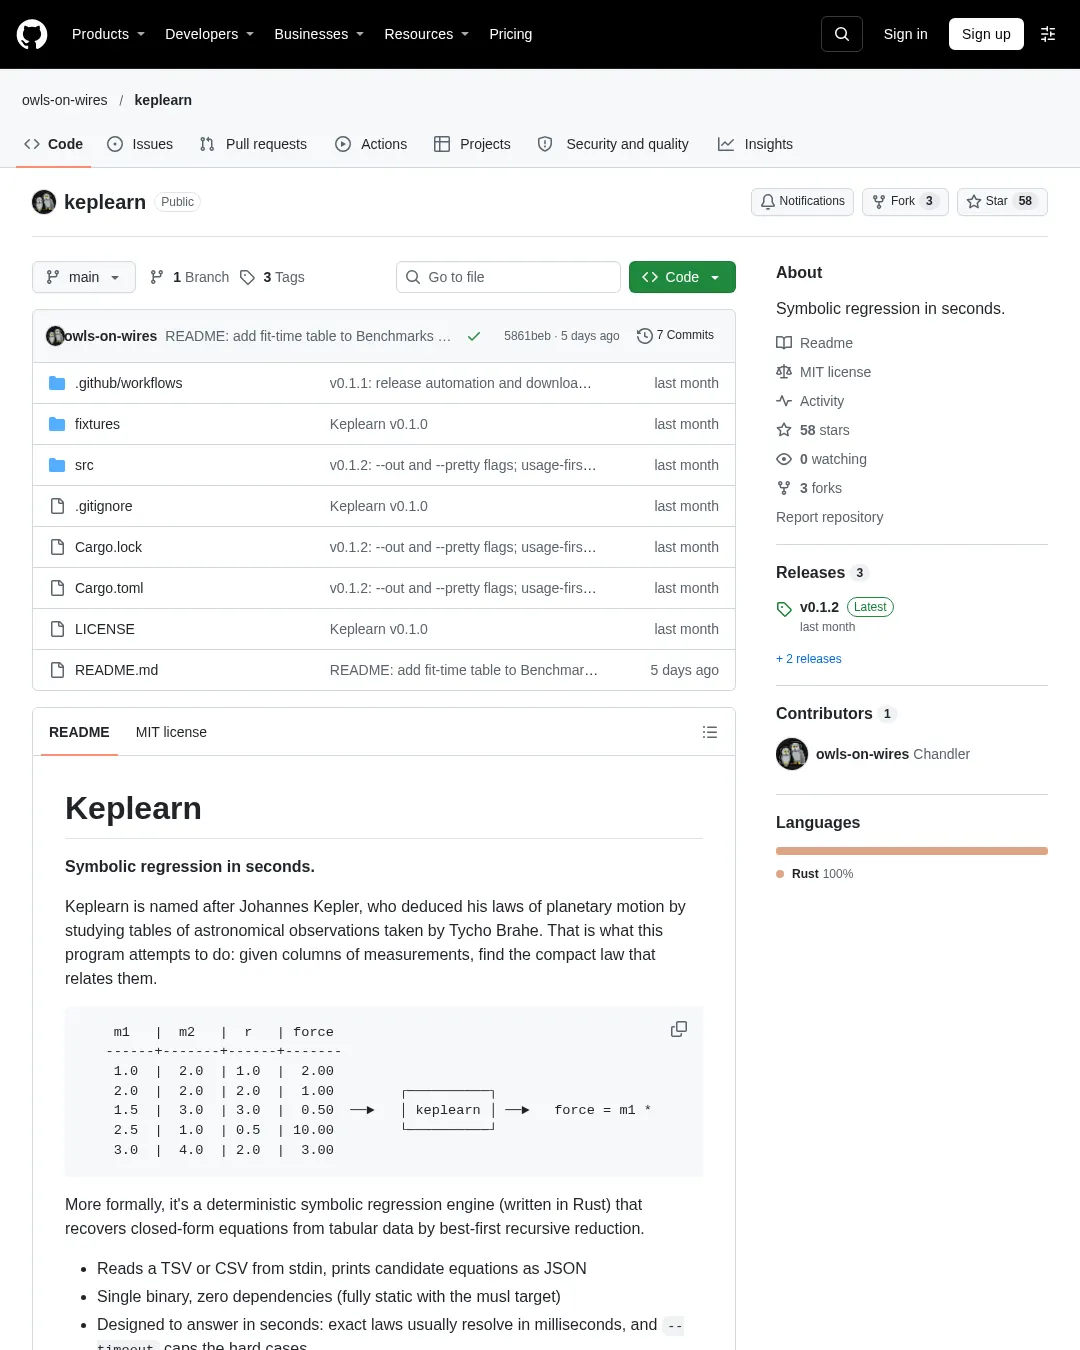
Keplearn은 CSV나 TSV 측정값에서 변수 사이의 수식을 찾는 Rust 기반 도구다. 제작자 Chandler Freeman은 정확한 법칙은 보통 밀리초 안에 찾도록 설계했으며, 어려운 경우에는 --timeout으로 탐색 시간을 제한할 수 있다고 설명한다.
입력 파일에는 헤더 행이 있어야 한다. 예측할 열은 --target으로 지정하며, 기본값은 target이다. 구분자는 헤더에 탭이 있으면 탭, 없으면 쉼표로 판단한다. 열 이름 대신 파일에서의 순서로 변수를 표시하므로, 예를 들어 입력 열이 m1, m2, r이면 출력 수식 m1*m2/r**2는 중력 데이터의 예시와 같은 방식으로 해석한다.
$ ./keplearn --target force --top-k 1 --pretty --out laws.json < gravity.tsv
$ cat laws.json
--top-k는 출력할 상위 후보 수를, --sample은 탐색에 사용할 행 수를 지정한다. 결과는 JSON으로 출력하며 후보는 높은 순위부터 나온다. 진단 정보는 stderr로 보내 stdout에는 JSON 객체 하나만 출력한다. 결과의 r2는 내부 단계의 점수를 재사용하지 않고, 출력된 수식 자체를 평가해 계산한다.
macOS(Apple Silicon·Intel), Windows x86_64, Linux x86_64용 단일 실행 파일을 제공하며, 제작자는 의존성이 없고 Linux 빌드는 정적 바이너리라고 설명한다. 전체 사용법과 파일은 Keplearn 저장소와 다운로드 안내에서 확인할 수 있다.
탐색 방식과 성능 조건
Keplearn은 목표 열에 역변환 가능한 연산을 반복 적용해 수식을 탐색한다. 로그·제곱근·아크사인 변환이나 인자 나누기 등을 시도하고, 거듭제곱 항과 몇 가지 복합 형태를 맞춘다. 후보 순위에는 내부 데이터의 25%를 보류한 검증 결과와 수식 복잡도 페널티를 반영한다. 유리수와 π, e, √2의 배수에 가까운 상수는 검증을 통과할 때만 채택한다.
프로젝트는 이 방법을 기호 회귀 벤치마크인 SRBench에 추가했으며, 관련 변경은 SRBench PR #223에서 확인할 수 있다. 아래 수치는 SRBench 컨테이너 파이프라인에서 데이터셋마다 한 번씩 실행하고, 적합당 60초 제한을 둔 결과다. 정답 수식과의 동등성은 SymPy 검사로 평가했다.
| 벤치마크 | 잡음 수준 | 정답 수식 발견 |
|---|---|---|
| Feynman (116개) | 0 | 75 (64.7%) |
| Feynman (116개) | 0.001 | 65 (56.0%) |
| Feynman (116개) | 0.01 | 51 (44.0%) |
| Feynman (116개) | 0.1 | 10 (8.6%) |
| Strogatz (14개) | 0 | 6 (42.9%) |
| Strogatz (14개) | 0.001 | 6 (42.9%) |
| Strogatz (14개) | 0.01 | 3 (21.4%) |
| Strogatz (14개) | 0.1 | 1 (7.1%) |
프로젝트는 같은 SRBench의 Feynman 결과에서 기존 최고 발표 수치인 AIFeynman의 55.8%보다 높은 64.7%를 기록했다고 밝혔다. 다만 닫힌 형태의 정답 수식이 없는 블랙박스 데이터셋 138개에서는 테스트 R² 중앙값이 약 -0.003이었다. Keplearn은 일반적인 곡선 맞춤보다 정확한 해석적 법칙을 찾는 데 초점을 두며, 프로젝트는 이 차이가 결과에 반영됐다고 설명한다.
잡음이 없는 Feynman 데이터에서는 적합 시간 중앙값이 1.3초였고, 116개 중 55개가 1초 이내에 끝났다. 잡음이 있는 Feynman 데이터는 적합 시간이 대체로 11~14초였으며, 프로젝트 설명에 따르면 잡음이 있으면 정확한 수식을 찾았을 때 일찍 종료하는 경로가 작동하지 않아 제한 시간까지 탐색할 수 있다. 벤치마크와 측정 조건은 저장소의 벤치마크 안내에 공개돼 있다.
Keplearn은 MIT 라이선스로 배포된다. 제작자는 Chandler Freeman이다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요