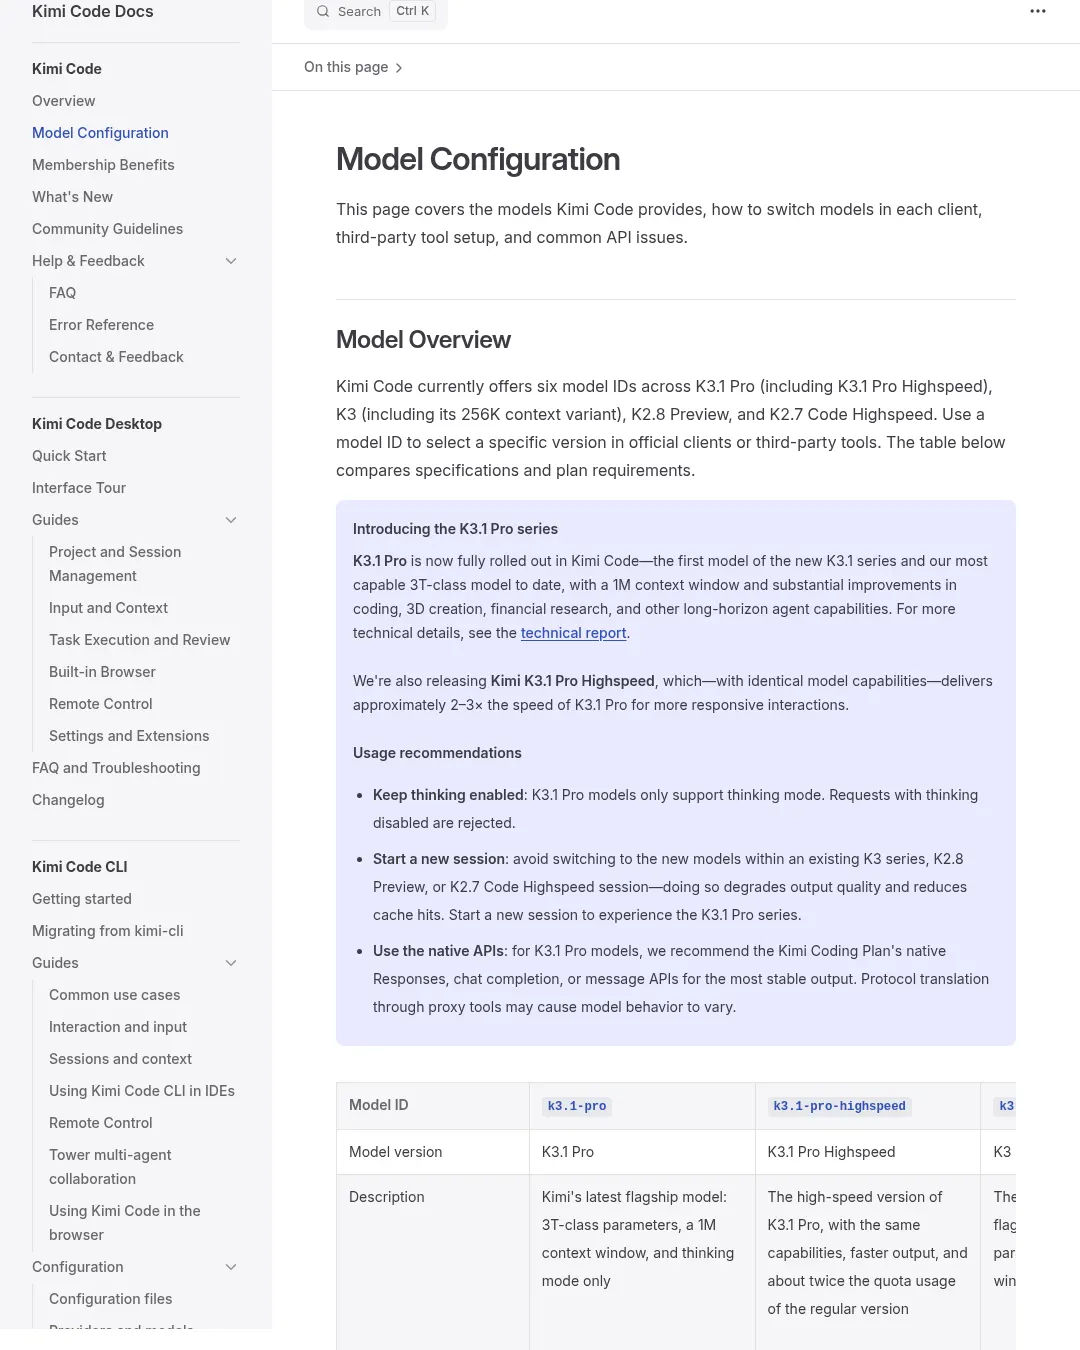
Kimi Code가 1M 토큰 문맥 창을 지원하는 K3.1 Pro와 같은 기능을 더 빠르게 제공하는 K3.1 Pro Highspeed를 출시했다. 두 모델은 추론 모드를 항상 켜야 하며, 기존 세션에서 모델을 바꾸지 말고 새 세션을 시작해야 한다.
Kimi Code 모델 설정 문서에 따르면 Kimi Code는 K3.1 Pro 계열을 포함해 6개 모델 ID를 제공한다. Kimi 측은 K3.1 Pro를 새 K3.1 시리즈의 첫 모델이자 현재까지 가장 역량이 높은 3T급 모델이라고 소개하며, 코딩·3D 제작·금융 연구 및 모델링이 개선됐다고 설명한다. Highspeed는 기능은 같고 출력 속도는 약 2~3배 빠르지만, 일반 버전보다 할당량을 약 2배 사용한다.
| 구분 | k3.1-pro | k3.1-pro-highspeed | k3 | k3-256k | kimi-for-coding | kimi-for-coding-highspeed |
|---|---|---|---|---|---|---|
| 모델 | K3.1 Pro | K3.1 Pro Highspeed | K3 | K3 | K2.8 Preview | K2.7 Code Highspeed |
| 문맥 창 | 최대 1048576(상위 요금제) | 최대 1048576(상위 요금제) | 최대 1048576(상위 요금제) | 최대 262144 | 최대 1048576 | 최대 262144 |
| 속도·할당량 | 일반 | 약 2~3배 빠름, 할당량 약 2배 | 일반 | 일반 | 일반 | 약 5~6배 빠름, 할당량 약 3배 |
| 추론 모드 | low / high / max, 기본 max; 끌 수 없음 | low / high / max, 기본 max; 끌 수 없음 | low / high / max, 기본 high | low / high / max, 기본 high | low / high / max, 기본 max | 조절 불가, Thinking:ON |
| 입력 | 이미지·영상 | 이미지·영상 | 이미지·영상 | 이미지만 | 이미지·영상 | 이미지·영상 |
Kimi Code는 요금제에 따라 사용할 수 있는 모델과 문맥 창이 다르다. 신규 요금제 기준으로 K3.1 Pro는 Plus 이상에서 제공되며 1M 문맥은 Pro 이상이 필요하다. K3.1 Pro Highspeed는 Pro 이상, K3는 Plus 이상이며 1M 문맥은 Pro 이상, k3-256k와 K2.8 Preview는 Plus 이상, K2.7 Code Highspeed는 Pro 이상이다. 기존 요금제의 이용 조건은 각각 K3.1 Pro가 Moderato 이상(1M 문맥은 Allegretto 이상), Highspeed가 Allegretto 이상, K3가 Moderato 이상(1M 문맥은 Allegretto 이상), k3-256k와 K2.8 Preview가 Moderato 이상, K2.7 Code Highspeed가 Allegretto 이상이다.
모델 전환과 사용 조건
K3.1 Pro 모델은 추론 모드만 지원한다. 추론을 끈 요청은 거부된다. Kimi는 안정적인 출력을 위해 Kimi Coding Plan의 기본 Responses, Chat Completions 또는 메시지 API 사용을 권장한다. 프록시 도구를 통한 프로토콜 변환은 모델 동작을 달라지게 할 수 있다.
모델이나 추론 수준을 바꾸면 기존 문맥 캐시가 무효화돼 다시 입력을 처리해야 하고 토큰 사용량이 늘어난다. 서로 다른 모델의 추론 과정이 영향을 줄 수도 있으므로 세션 중에는 모델과 추론 수준을 유지하는 편이 좋다. K3 시리즈, K2.8 Preview, K2.7 Code Highspeed 세션에서 K3.1 Pro로 전환하지 말고 새 세션을 시작하라는 안내도 있다.
공식 클라이언트에서는 Desktop의 Composer 모델 선택기, CLI의 /model, VS Code 입력창의 드롭다운에서 모델을 바꾼다. 최신 모델이 목록에 없으면 Desktop이나 VS Code를 재시작하거나 다시 로그인한다. CLI에서는 /logout 후 /login으로 다시 로그인할 수 있다. 클라이언트는 Kimi Code 홈페이지에서 받을 수 있다.
외부 도구를 쓰려면 Kimi Code Console에서 API 키를 만든 뒤 Base URL과 모델 ID를 입력한다. 모델 ID를 써야 하며, K3.1 Pro 같은 버전 이름을 입력하면 안 된다. 잘못된 ID는 오류를 내는 대신 추론 기능이 꺼진 K2.8 Preview로 연결될 수 있다. Responses API를 지원하는 도구에는 기본 Responses 형식이 권장된다.
- OpenAI 호환(Responses / Chat Completions): 중국
https://api.kimi.com/coding/v1, 해외https://api.kimi.ai/coding/v1 - Anthropic 호환: 중국
https://api.kimi.com/coding/, 해외https://api.kimi.ai/coding/
도구별 설정은 Claude Code 안내, OpenCode 안내, Codex 안내에서 확인할 수 있다.
오류와 문맥 제한
K3.1 Pro 계열에서 추론 수준은 low, high, max를 지원하며 기본값은 max다. off, none, disabled를 지정하면 HTTP 400으로 거부된다. K3 시리즈와 K2.8 Preview의 기본값은 high다. 이 모델들과 K2.7 Code Highspeed에서 추론을 끄면 K2.8 Preview의 추론 기능이 꺼진 상태로 처리된다. 알 수 없는 추론 값도 HTTP 400을 반환한다. 추론 수준 변환 및 라우팅 규칙에서 세부 내용을 확인할 수 있다.
HTTP 403은 계정 요금제에 해당 모델이나 1M 문맥 권한이 없을 때 발생할 수 있다. HTTP 400은 K3.1 Pro에서 추론을 껐거나, 선택한 모델이 1M 문맥을 지원하지 않거나, 요청이 문맥 한도를 넘었을 때 발생할 수 있다. k3-256k와 kimi-for-coding-highspeed는 1M 문맥을 지원하지 않는다.
K3의 1M 문맥 버전에서 k3-256k로 바꿀 때 현재 문맥이 256K를 넘으면 일부 도구가 자체적으로 문맥을 압축한다. 전환 전에 수동으로 압축하면 대화의 핵심을 유지하면서 세션을 이어갈 수 있다. 대화에 영상 파일이 있으면 영상 입력을 지원하지 않는 k3-256k로 바로 전환할 수 없으므로 먼저 압축해야 한다. 반대로 k3-256k의 256K 한도에 가까운 상태에서 정보를 잃지 않으려면 1M 버전으로 바로 전환할 수 있으며, 문서에 따르면 현재 버전에서는 이 전환이 캐시에 영향을 주지 않는다.
Highspeed가 눈에 띄게 빠르지 않다면 모델 ID가 정확한지 확인해야 한다. 도구 호출과 스크립트 실행 속도는 빨라지지 않으므로, 한 작업에서 이 과정이 대부분을 차지하면 전체 속도 향상이 작게 느껴질 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요