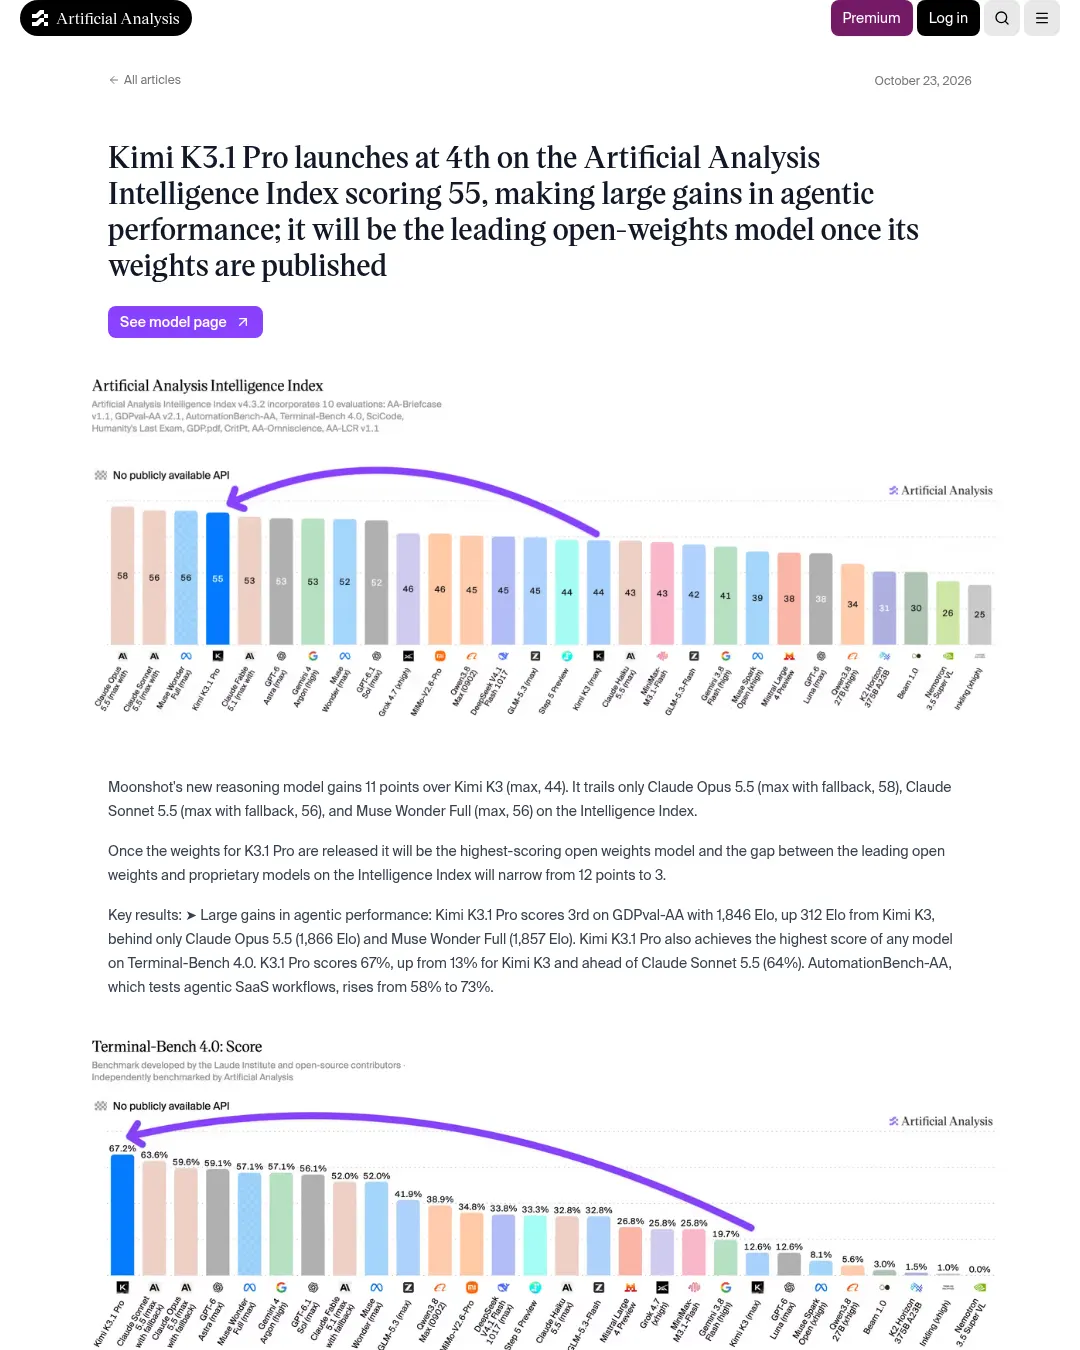
Artificial Analysis의 Intelligence Index에서 Kimi K3.1 Pro가 55점을 받아 전체 4위에 올랐다. Moonshot의 새 추론 모델은 에이전트 성능 평가에서 큰 폭으로 개선됐으며, 가중치가 공개되면 오픈 웨이트 모델 중 가장 높은 점수를 기록할 전망이다. 모델 페이지
Kimi K3.1 Pro는 Kimi K3의 최고 점수 44점보다 11점 높다. Intelligence Index에서 이 모델보다 점수가 높은 모델은 Claude Opus 5.5(max with fallback, 58점), Claude Sonnet 5.5(max with fallback, 56점), Muse Wonder Full(max, 56점)뿐이다. 가중치가 공개되면 오픈 웨이트 모델과 독점 모델의 선두 점수 차이는 12점에서 3점으로 줄어들 것이라고 Artificial Analysis는 내다봤다.
에이전트 성능 평가인 GDPval-AA에서는 1,846 Elo를 기록해 3위에 올랐다. Kimi K3보다 312 Elo 높은 점수로, Claude Opus 5.5(1,866 Elo)와 Muse Wonder Full(1,857 Elo) 다음이다. Terminal-Bench 4.0에서는 평가 모델 중 가장 높은 점수인 67%를 기록했다. Kimi K3의 13%와 Claude Sonnet 5.5의 64%보다 높다. 에이전트 기반 SaaS 작업 흐름을 평가하는 AutomationBench-AA 점수도 58%에서 73%로 상승했다.
다른 평가의 개선 폭은 상대적으로 작다. Humanity’s Last Exam은 47%에서 52%로, CritPt는 23%에서 25%로, SciCode는 59%에서 61%로 올랐다. AA-Omniscience Index는 20점에서 30점으로 상승했다. 환각률은 53%에서 44%로 낮아졌고 정확도는 48%에서 51%로 높아졌다.
작업당 비용은 1.98달러로 Kimi K3와 대체로 비슷하다. Kimi K3.1 Pro는 Intelligence Index 작업당 출력 토큰 55K를 사용해 Kimi K3의 48K보다 14% 많지만, Moonshot의 토큰 가격은 입력·출력·캐시 적중 모두 Kimi K3보다 33% 낮다. 가격은 입력 토큰 100만 개당 2달러, 출력 토큰 100만 개당 10달러, 캐시 적중 토큰 100만 개당 0.20달러다.
컨텍스트 창은 1M 토큰이며, 전체 매개변수는 2.8T, 활성 매개변수는 104B다. 입력으로 텍스트와 이미지를 받는다. 가중치는 아직 공개되지 않았으며, Moonshot은 출시 직후 공개할 것으로 예상된다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요