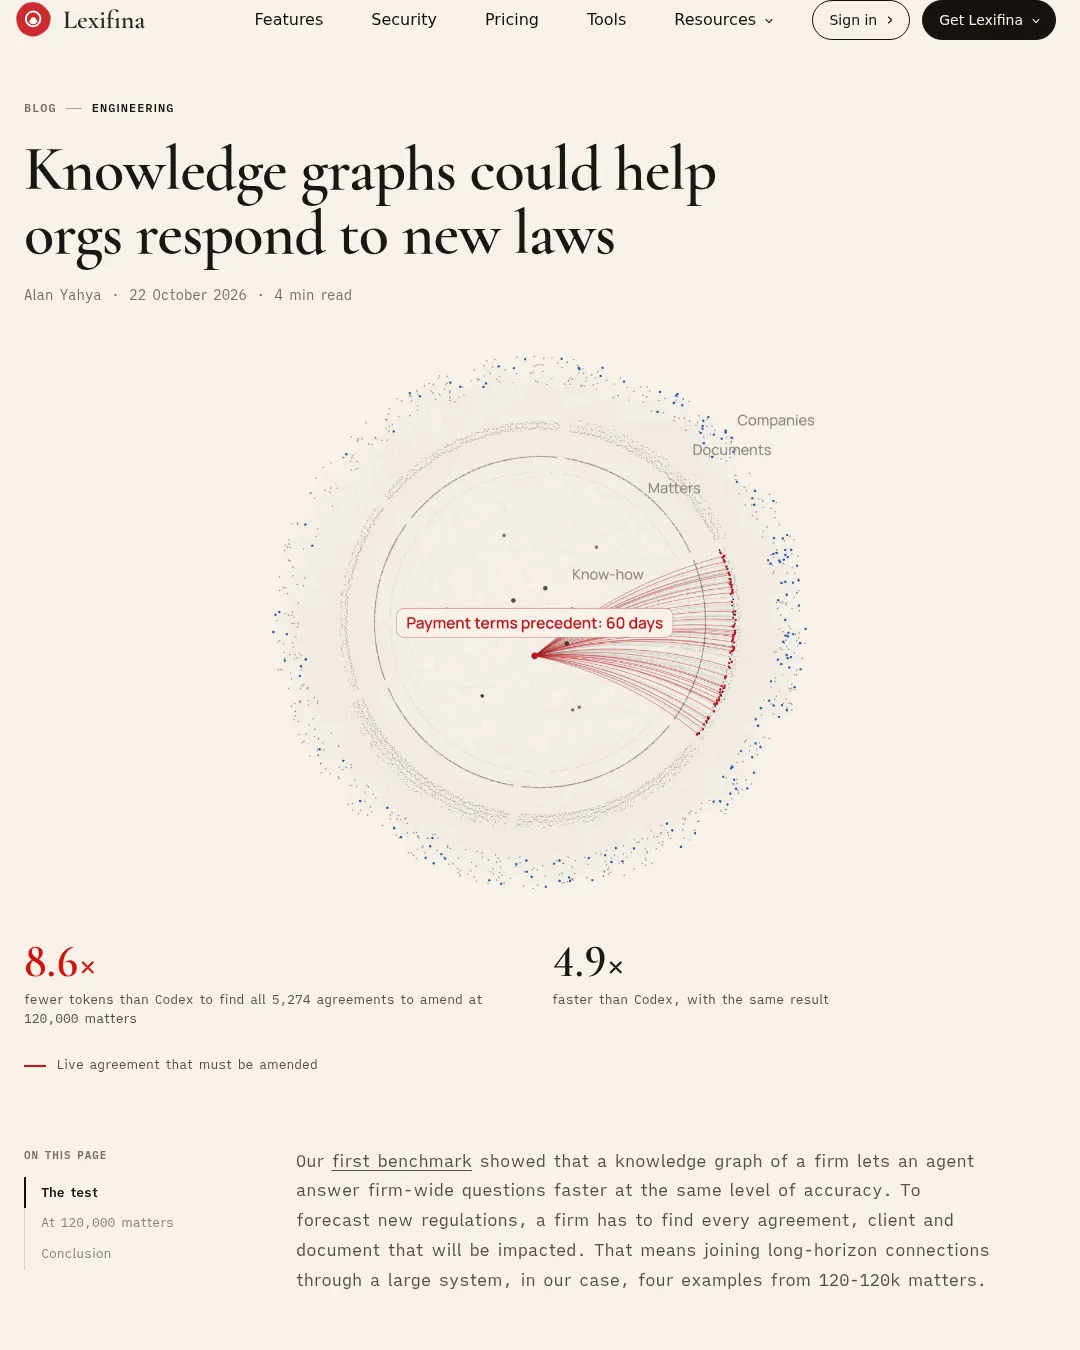
첫 벤치마크에서는 기업의 지식 그래프를 이용하면 에이전트가 기업 전체에 관한 질문에 같은 정확도로 더 빠르게 답할 수 있음을 보였다. 새 규제의 영향을 예측하려면 영향을 받는 계약과 고객, 문서를 모두 찾아야 한다. 이 자료는 가상의 기업을 대상으로 그 작업에서 지식 그래프와 파일 검색·코딩 에이전트의 성능을 비교했다.
시험과 결과
시험에서는 규모가 다른 가상의 기업 네 곳을 만들고, 특정 거래 상대방과 허용되는 결제 조건을 바꾸는 가상의 규제를 설정했다. 과제는 수정이 필요한 유효 계약을 모두 찾는 것이었다. 계약이 대상인지는 당사자, 계약 조건, 해당 사안이 아직 진행 중인지에 따라 달라진다. 조건이 기업의 선례 문서를 가리키는 경우도 있어 단일 문서만으로는 판단할 수 없다.
| 기업 규모 | 문서 수 | 수정 대상 계약 | 그래프 구축 시간 |
|---|---|---|---|
| 120개 사안 | 245 | 6 | 4초 |
| 1,200개 사안 | 2,465 | 50 | 52초 |
| 12,000개 사안 | 24,315 | 562 | 9.3분 |
| 120,000개 사안 | 243,547 | 5,274 | 50분 |
그래프 없이 시험한 에이전트는 기업 파일을 나열하고 검색해 읽었다. 그래프를 사용한 경우에는 같은 파일로 만든 그래프도 질의할 수 있었다. 각 설정은 세 차례 실행했고, 답변을 생성할 때 사용한 대상 계약 목록과 대조해 점수를 매겼다. 아래 결과는 GPT-6 Sol을 사용한 에이전트의 세 차례 평균이다.
| 기업 규모 | 그래프 유무 | 찾은 계약 비율 | 시간 | 입력 토큰 |
|---|---|---|---|---|
| 120개 사안 | 그래프 없음 | 100% | 84초 | 190k |
| 120개 사안 | 그래프 사용 | 100% | 24초 | 48k |
| 1,200개 사안 | 그래프 없음 | 100% | 3.8분 | 937k |
| 1,200개 사안 | 그래프 사용 | 100% | 1.6분 | 166k |
자료는 파일을 하나씩 읽는 방식을 그래프 없는 검색의 가장 약한 기준으로 보고, 12,000개 사안에서는 다른 방법도 비교했다. 기업을 12개로 나눠 에이전트 12개를 돌리는 방식과 OpenAI의 Codex, Anthropic의 Claude Code를 같은 파일에 적용했다. 코딩 에이전트는 검색만 하도록 제한하거나, 과제에 맞는 스크립트를 직접 작성하도록 했다.
| 접근 방식 | 찾은 계약 비율 | 시간 | 입력 토큰 | 모델 비용 |
|---|---|---|---|---|
| 그래프를 사용한 에이전트 | 100% | 2.2분 | 213k | $0.27 |
| 에이전트 12개로 분할 | 96% | 27분(병렬 실행 시 3.2분) | 7.5M | $3.78 |
| Codex, 검색만 사용 | 100% | 11분 | 1.5M | $0.72 |
| Codex, 스크립트 작성 | 100% | 5.8분 | 683k | $0.31 |
| Claude Code, 검색만 사용 | 100% | 19분 | 8.9M | $6.48 |
| Claude Code, 스크립트 작성 | 100% | 9.9분 | 1.1M | $1.61 |
위 결과는 12,000개 사안에서 수정할 계약 562건을 찾은 세 차례 실행의 평균이다. Claude Code는 Claude Opus 5.5를 사용했고, 나머지 설정은 모두 GPT-6 Sol을 사용했다. 비용은 정가 기준이다.
에이전트를 나눠 실행한 방식은 계약의 96%를 찾았지만 그래프 방식보다 토큰을 35배 많이 읽었다. 36개 에이전트 가운데 3개는 계약의 한 부류를 통째로 놓치고도 이를 알리지 않았다. 두 코딩 에이전트는 검색 패턴이나 짧은 스크립트로 파일마다 당사자와 조건을 추출해 모든 계약을 찾았다. 그래프는 질문이 들어왔을 때 다른 방식들이 계산하는 관계를 그래프 구축 시점에 한 번 연결해 두기 때문에 가장 빨랐고, 토큰도 다른 방식의 3분의 1 이하를 사용했다.
120,000개 사안에서의 비교
120,000개 사안에는 문서 243,547건 가운데 수정 대상 계약이 5,274건 있었다. 그래프가 시험 장비의 메모리에 들어가지 않아 10개 파티션으로 나눠 구축한 뒤 질의 결과를 합쳤다. 모든 설정에서 모델 호출 횟수와 시간, 비용을 제한하지 않았다.
| 접근 방식 | 찾은 계약 비율 | 시간 | 입력 토큰 | 모델 비용 |
|---|---|---|---|---|
| 그래프와 내보내기 도구를 사용한 에이전트 | 100% | 54초 | 73k | $0.05 |
| Codex, 스크립트 작성 | 100% | 4.5분 | 622k | $0.27 |
| Claude Code, 스크립트 작성 | 100% | 28분 | 599k | $0.74 |
| Codex, 검색만 사용 | 0% | 4.5분 | 654k | $0.30 |
| Claude Code, 검색만 사용 | 0% | 9.4분 | 1.2M | $0.97 |
이 결과는 세 차례 실행의 평균이다. 목록을 링크된 파일로 전달한 경우도 정답으로 인정했다. 검색만 사용한 두 코딩 에이전트는 5~10분 뒤 스스로 작업을 포기했고, 계약을 12건도 찾지 못했다. 스크립트를 작성하도록 하자 두 에이전트 모두 계약을 전부 찾았다. Codex는 4.5분이 걸렸고, 문서 243,547건을 하나씩 연 Claude Code는 28분이 걸렸다.
그래프를 사용한 에이전트는 첫 질의부터 정답 계약 수를 계산했다. 다만 당시 제품에서는 그래프 질의 결과를 한 페이지에 70행씩 텍스트로 모델에 돌려줬고, 실행은 모두 첫 페이지만 처리한 뒤 멈췄다. 에이전트는 전체 목록을 답변에 76페이지나 복사하는 대신 목록이 불완전하다고 알리고 총수를 제시했다. 이를 막는 제한이 있었던 것은 아니며, 에이전트가 그렇게 선택했다.
그래프 결과의 실행 시간에는 디스크에서 그래프를 불러오는 시간이 포함되지 않았다. 그래프 데이터베이스는 한 번 불러온 뒤 준비 상태를 유지하지만, 시험 환경에서는 가장 큰 그래프를 메모리에 둘 수 없어 질의마다 다시 불러왔다. 이 과정이 각 실행 시간의 대부분을 차지했다.
Codex는 두 규모에서 모두 비슷한 속도를 냈다. 기업 규모가 커져도 접근 방식의 작업량이 거의 늘지 않았기 때문이다. Codex는 매번 각 문서의 유형과 사안을 기록한 기업 문서 색인을 읽고, 진행 중인 사안의 계약만 추려 짧은 스크립트를 실행했다. 토큰은 결과 목록 자체보다 기업의 파일 구조를 파악하고 스크립트를 작성하는 데 쓰였기 때문에 12,000개와 120,000개 사안에서 사용량이 비슷했다. 자료는 이 색인을 지식 그래프의 단순한 형태로 설명한다. 색인이 없으면 코딩 에이전트는 Claude Code처럼 모든 파일을 열어야 한다.
자료는 기업 규모가 120개에서 120,000개 사안으로 1,000배 커졌지만, 그래프를 사용한 에이전트의 토큰 사용량은 최대 네 배만 늘었다고 설명한다. 관계를 연결하는 작업을 그래프를 만들 때 해두기 때문이다. 다만 지식 그래프를 구축하려면 정보를 모아야 한다. 정보 상당 부분은 사람들의 머릿속에 있으므로, 먼저 사안별 거래 상대방과 관련 문서처럼 기업이 이미 기록하는 정보에서 출발하고 규칙과 언어 모델로 그래프를 확장해야 한다는 설명이다. 초기 작업은 필요하지만, 그래프를 계속 확장하면 이후 새 법률 대응을 비롯한 기업 전체 질의의 비용을 그래프가 없을 때보다 줄일 수 있다고 자료는 주장한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요