TL;DR
- KnowNote 1.3.0은 문서와 임베딩을 기기에 보관하고 검색을 오프라인으로 실행하며, 모든 답변에 근거 구절과 문서 내 위치를 연결하는 로컬 우선 데스크톱 워크스페이스임.
- 문서 경계를 보존하는 가져오기 방식으로 문장 중간에서 잘린 구절의 검색·인용 품질 저하를 막고, 인용은 원문 구절을 가리킴.
- 노트북에 질문, 답변, 출처, 인용, 메모를 함께 축적하며 질문 색인에서 근거와 결론을 확인할 수 있음.
- 채팅 모델을 번들로 제공하지 않고 OpenAI·Anthropic·Google 호환 엔드포인트나
Ollama같은 로컬 서버를 연결하며, 다국어 검색용 임베더는 앱에 포함됨. - GPL-3.0 프로젝트로,
Windowsx64와 Apple SiliconmacOS용이며 Docker·서버·계정 없이 사용할 수 있음.
KnowNote 소개
- KnowNote 1.3.0은 자체 문서를 읽고 질문하는 로컬 우선 데스크톱 워크스페이스임.
- 모든 답변에는 답변이 나온 구절이 연결되며, 검색은 다른 사람의 클라우드가 아니라 사용자 컴퓨터에서 실행됨.
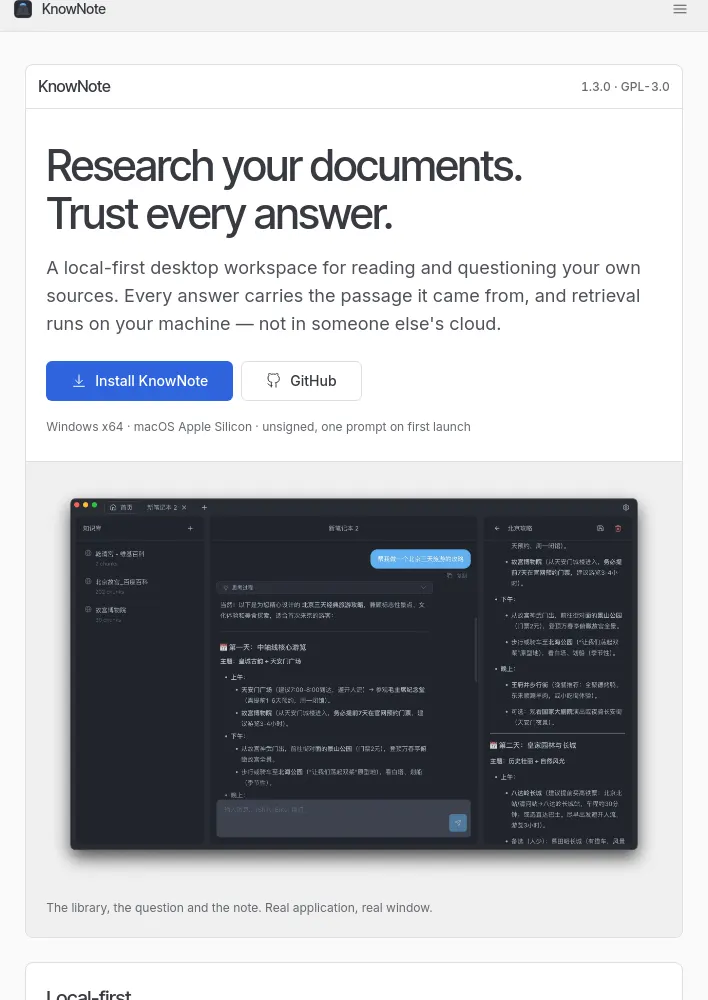
- 라이브러리, 질문, 메모가 한 애플리케이션 창에 표시됨.
Windowsx64와 Apple SiliconmacOS용으로 제공되며, 서명되지 않은 앱은 첫 실행 때 확인 메시지가 한 번 표시됨.
로컬 우선·추적 가능·경량
- 문서, 노트북, 임베딩은 사용자 컴퓨터에 보관되며 임베더도 앱 안에서 실행되어 오프라인 검색이 가능함.
- 모든 답변에 근거가 된 원문 구절과 문서 내 위치가 기록됨.
- 내려받아 열면 바로 읽을 수 있으며 Docker, 서버, 계정이 필요하지 않음.
확인 가능한 답변
- 인용 표식을 선택하면 답변을 뒷받침하는 구절로 돌아갈 수 있음.
- 예시의 원문 텍스트는 설명을 위해 작성된 내용이며, 실제 출처에서 가져온 것이 아님.
- 예시 문서는
handbook.pdf140쪽이며, 문장 중간에서 자른 구절은 검색 결과와 인용 품질이 나빠지고 순위 조정만으로 분할 과정에서 사라진 의미를 복구할 수 없다는 내용을 담음. - 구절의 시작과 끝은 추출된 텍스트 기준으로 기록되어, 인용이 파일 전체가 아니라 해당 구절을 가리킴.
- 검색 품질은 벡터 저장소만의 속성이 아니라 전체 파이프라인의 속성이며, 문서가 가진 경계를 가져오기 단계에서 보존하는 비용은 거의 없음.
질문이 지식으로 쌓이는 방식
- 노트북에는 답변보다 질문이 먼저 축적될 수 있으며, 각 질문을 열어 답변의 근거, 원문 구절, 도출한 결론을 확인할 수 있음.
- 검색 품질은 왜 떨어지는가? 4개 출처와 12개 인용을 바탕으로, 검색 전에 정해진 구절 경계가 문장 중간에 걸리면 검색과 인용 모두를 오도한다는 답변을 제시함. 출처는
handbook.pdf,survey-2024.pdf,notes-week-3.docx,draft-methods.pdf임. 메모는 구절 경계가 순위 산정이 아니라 가져오기 단계의 결정임을 강조함. - 밀집 검색과 BM25 중 어느 쪽인가? 6개 출처와 18개 인용을 바탕으로, 의미 기반 질의에는 밀집 검색이, 드문 용어가 질의에 포함될 때는 BM25가 유리하며 차이는 주로 말뭉치에 달려 있다는 답변을 제시함. 출처는
survey-2024.pdf,benchmark-notes.pdf,course-reader.pdf,slides-w7.pptx,blog-post.html,draft-methods.pdf임. 말뭉치가 서로 다른 비교는 비교가 아니므로 두 방식을 하나의 말뭉치에서 비교하라는 메모와, 도메인 밖 분할에서 하이브리드 점수가 격차 대부분을 회복해 밀집 요소는 의미를, 희소 요소는 드문 용어를 담당했다는 구절이 포함됨. - 어텐션은 시퀀스 길이에 따라 어떻게 증가하는가? 3개 출처와 9개 인용을 바탕으로, 시퀀스 차원에서 이차적으로 증가하며 실용적 한계는 연산보다 메모리라는 답변을 제시함. 출처는
attention-paper.pdf,efficient-transformers.pdf,course-reader.pdf임. 메모는 어텐션 비용이 시퀀스 길이의 제곱으로 늘어나므로 효율화 연구의 관점을 바꾸는 제약이 메모리임을 강조함. - 무엇이 생각을 바꾸는 증거인가? 5개 출처와 21개 인용을 바탕으로, 동일 말뭉치에서 희소 기준선이 하이브리드와 맞먹거나 드문 용어 질의 없이도 하이브리드 결과가 유지되는 실험을 제시함. 두 증거 모두 노트북에는 없음. 출처는
draft-methods.pdf,survey-2024.pdf,notes-week-3.docx,benchmark-notes.pdf,rebuttal.pdf임. 희소 요소를 제거해도 종합 점수는 2점 이내였지만 질의별 분석은 보고되지 않았다는 구절과, 종합 점수는 이를 가리므로 질의별 표를 요청하라는 메모가 포함됨. - 이 논문들이 공유하는 방법은 무엇인가? 4개 출처와 24개 인용을 바탕으로, 네 방법 중 세 가지가 초기 풀링 단계를 공유하고 이후 단계에서만 차이가 있으며 네 번째는 구조적으로 달라 수치를 직접 비교할 수 없다는 답변을 제시함. 출처는
survey-2024.pdf,attention-paper.pdf,efficient-transformers.pdf,benchmark-notes.pdf임. 세 방법 모두 점수 계산 전에 고정 폭 표현을 만들며, 메모는 구조적으로 다른 한 방법이 흥미로운 대상임을 짚음.
문서에서 메모까지
- 출처 추가: 형식별 파서가 페이지와 슬라이드 구조를 보존하며
pdf,docx,pptx,http를 지원함. - 질문하기: 사용자가 직접 표현한 질문을 받으며 검색은 다국어를 지원하고 노트북 안에서 실행됨.
- 근거 확인: 모든 답변이 근거 구절로 연결됨.
- 메모 작성: 도출한 결론이 출처 옆에 구조화된 로컬 형태로 남음.
원하는 모델과 함께 사용
- 채팅 모델이나 계정을 번들로 제공하지 않으며, OpenAI·Anthropic·Google 호환 엔드포인트 또는
Ollama같은 로컬 서버를 연결할 수 있음. - 자격 증명은 디스크에 저장되며 검색에는 모델이 필요하지 않음.
- 사용할 수 있는 엔드포인트 예시는 OpenAI, Gemini, Claude, DeepSeek,
Ollama로컬 서버, 기타 호환 엔드포인트임. - 앱에 포함된 다국어
multilingual-e5-small임베더는 리비전761b726dd, 양자화 형식q8, 차원 384임. 앱에 포함된 유일한 모델이며 검색 전용이고 채팅용은 아님.
공개 개발
- KnowNote 1.3.0은 GPL-3.0으로 제공되며 저장소가 프로젝트의 중심임.
- 저장소에서 확인한 수치는 스타 1,101개, 포크 147개, 열린 이슈 25개임.
- 모든 이슈, 풀 리퀘스트, 릴리스가 공개되어 있으며 아직 제공되지 않는 항목은 다운로드 페이지에서 확인할 수 있음.
마무리
- 문서, 질문, 지식을 한 화면에서 다루며 모델 연결은 사용자가 제공함. 임베더는 앱에 포함됨.
- KnowNote 설치 및 모든 릴리스 제공.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요