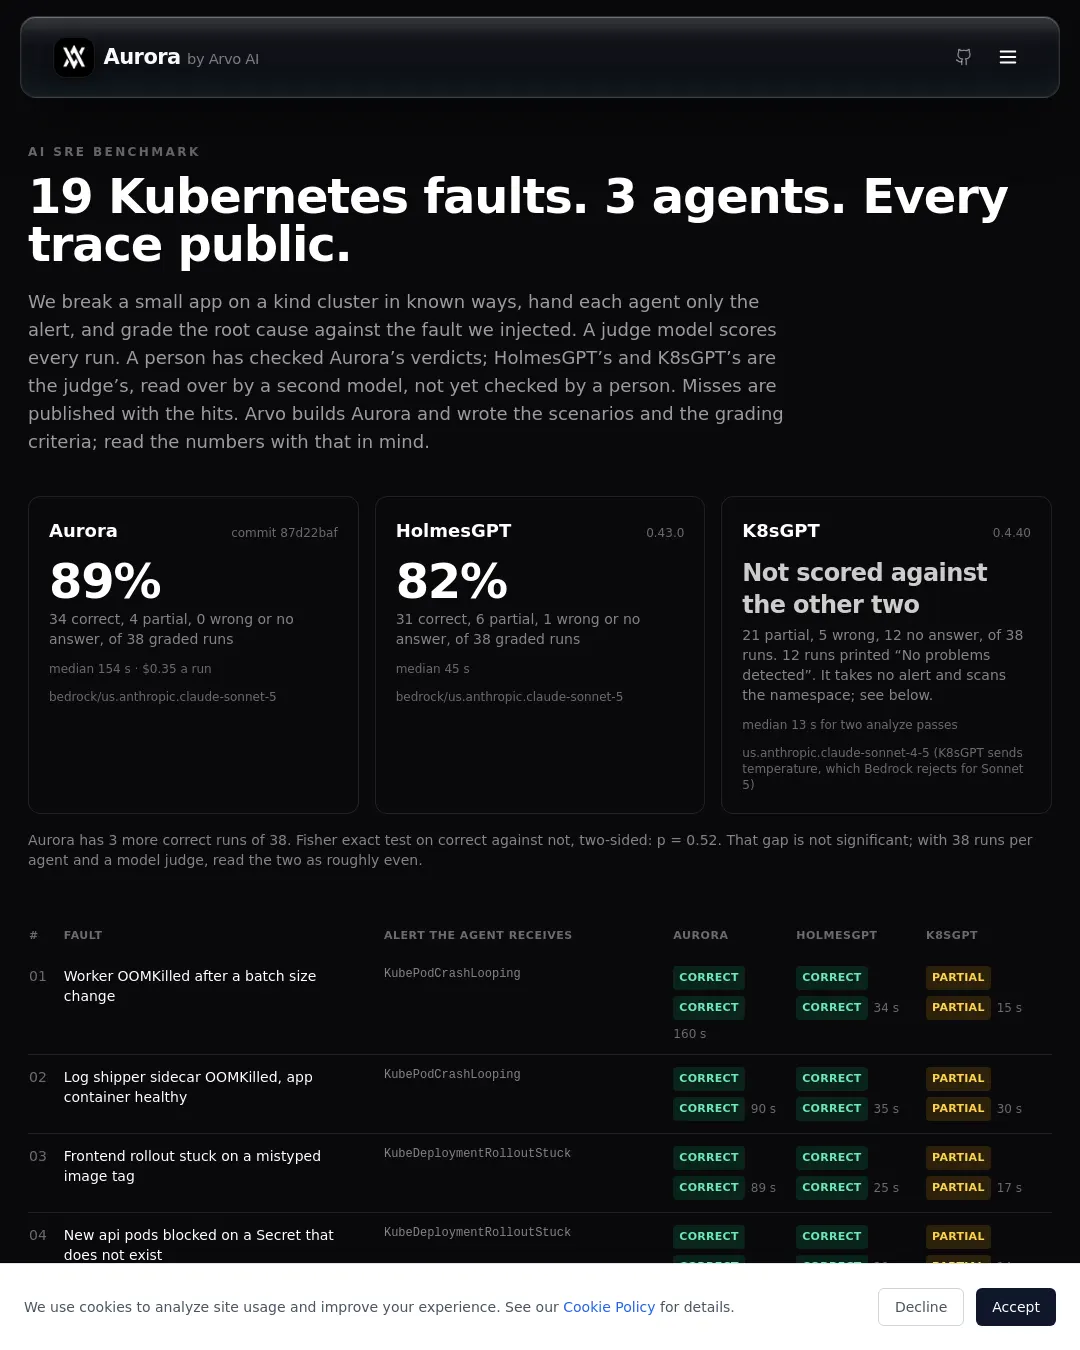
Arvo가 19가지 쿠버네티스 장애를 주입해 AI SRE 도구 Aurora, HolmesGPT, K8sGPT를 비교했다. Aurora는 38회 중 34회, HolmesGPT는 31회 정확히 진단했지만, 통계 검정에서 차이는 유의하지 않았다. K8sGPT는 평가 방식과 실행 모델이 달라 두 도구와 직접 비교할 수 없다.
세 도구는 kind 클러스터에서 같은 장애 시나리오를 각각 두 번 진단했다. 각 시도에는 알림 문구가 주어졌지만 K8sGPT는 알림을 받지 않고 네임스페이스를 검사했다. Aurora의 결과는 사람이 확인했고, HolmesGPT와 K8sGPT의 결과는 판정 모델이 채점한 뒤 별도 모델이 재검토했다. HolmesGPT는 두 모델의 판정이 모두 일치했지만, K8sGPT는 6개 판정에서 의견이 달랐다. 사람은 이 76개 결과를 아직 확인하지 않았다.
- Aurora: 정답 34회, 부분 정답 4회, 오답·무응답 0회. 중앙값 154초, 실행당 0.35달러.
- HolmesGPT: 정답 31회, 부분 정답 6회, 오답·무응답 1회. 중앙값 45초.
- K8sGPT: 부분 정답 21회, 오답 5회, 무응답 12회. 중앙값 13초. 실행 12회에서 “문제가 감지되지 않았다”고 출력했다.
Aurora와 HolmesGPT의 정답 횟수 차이는 38회 중 3회다. 정확 답변과 그 외 답변을 놓고 실시한 양측 피셔 정확 검정의 p값은 0.52였다. Arvo는 표본이 각 도구당 38회이고 모델이 판정에 관여했다는 점을 고려해 두 도구의 결과를 대체로 비슷한 수준으로 읽어야 한다고 밝혔다.
결과에는 평가 조건의 차이도 반영해야 한다. Aurora는 기본 읽기 전용 정책으로 실행됐고, HolmesGPT와 K8sGPT에는 클러스터 관리자 kubeconfig가 제공됐다. 다만 기록상 변경 명령이 실행된 흔적은 없다. HolmesGPT의 명령 허용 목록은 12회에서 kubectl rollout history를 막았으며, 해당 실행을 허용 상태로 다시 시험하지 않았다.
K8sGPT의 점수는 경고 기반 조사 도구에 맞춘 기준으로 평가해 직접 비교할 수 없다. 또 K8sGPT가 보내는 temperature 매개변수를 Bedrock이 Sonnet 5에서 거부해, K8sGPT는 Sonnet 4.5로 실행됐다. Aurora의 시간에는 자체 백그라운드 작업으로 인한 실험 환경의 대기가 포함됐다. K8sGPT 시간은 JSON과 텍스트 형식으로 두 차례 분석한 결과다. 비용은 Aurora만 기록했고 HolmesGPT의 토큰 사용량은 수집하지 않았다.
실험은 kind v0.33.0, Kubernetes v1.37.0, 3개 노드에서 진행했다. 합성 애플리케이션 shop에는 nginx, Python API, 워커, redis, 부하 생성기가 포함됐으며 고객 코드는 쓰지 않았다. 장애는 시나리오별 break.sh로 주입하고 check.sh로 확인했다. 전체 실행 기록과 채점 자료는 Arvo-AI/aurora-lab에 공개돼 있다. 결과 데이터는 results.json, 실험 설명은 lab report v1에서 볼 수 있다.
git clone https://github.com/Arvo-AI/aurora-lab && cd aurora-lab
./lab.sh up && ./lab.sh break 03-bad-image-tag
./runner/h2h.sh 03-bad-image-tag runs/mine
결과는 2026-10-21에 갱신됐다. 시나리오와 도구 버전은 저장소의 각 실행 기록에 적혀 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요