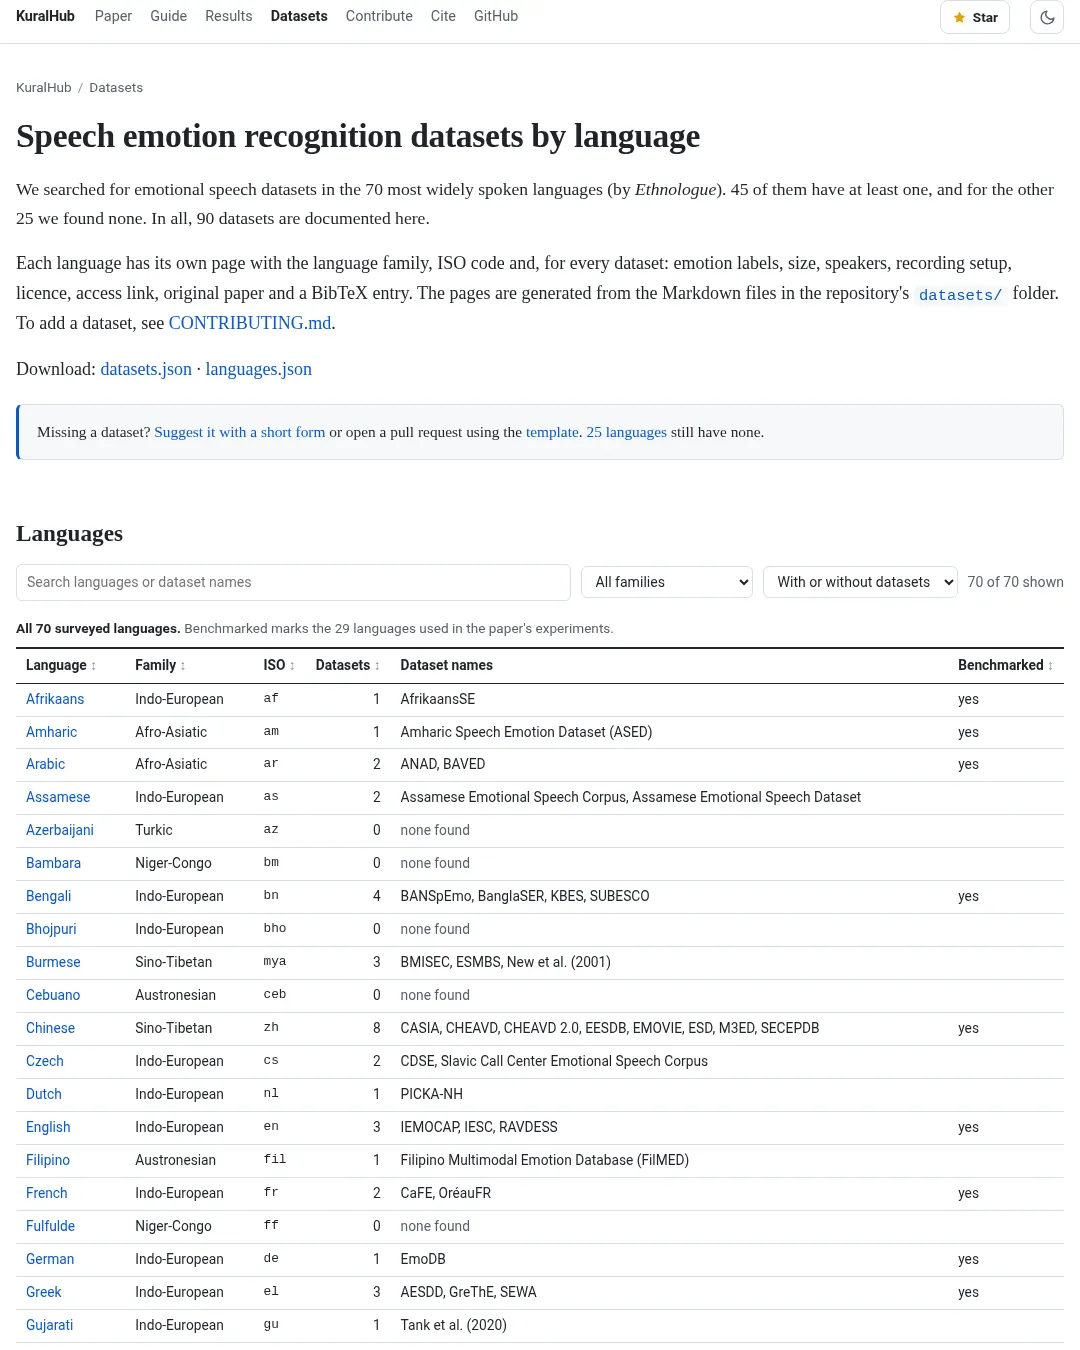
KuralHub는 에스놀로그(Ethnologue) 기준 사용 인구가 많은 70개 언어의 음성 감정 데이터셋 90개를 정리했다. 45개 언어에는 데이터셋이 하나 이상 있으며, 나머지 25개 언어에서는 찾지 못했다. 음성 감정 인식 자료를 찾는 사람은 언어별 페이지에서 데이터셋의 감정 라벨, 규모, 화자, 녹음 방식, 이용 허가와 원 논문을 확인할 수 있다.
데이터는 datasets.json과 languages.json으로 내려받을 수 있다. 데이터셋을 추가하려면 제안 양식을 작성하거나 기여 안내를 따라 풀 리퀘스트를 제출하면 된다. 언어별 페이지는 저장소의 datasets/ 폴더에 있는 마크다운 파일을 바탕으로 생성된다.
이용 가능 여부와 라이선스는 각 데이터셋의 문서에서 가져온 정보이므로, 실제 사용 전에는 원래 라이선스를 확인해야 한다. KuralHub는 데이터셋을 사용하면 해당 저자를 인용하고, KuralHub가 자료를 찾는 데 도움이 됐다면 KuralHub 논문도 인용해 달라고 안내한다. 데이터셋이 빠졌다면 데이터셋이 없는 25개 언어 목록에서 확인할 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요