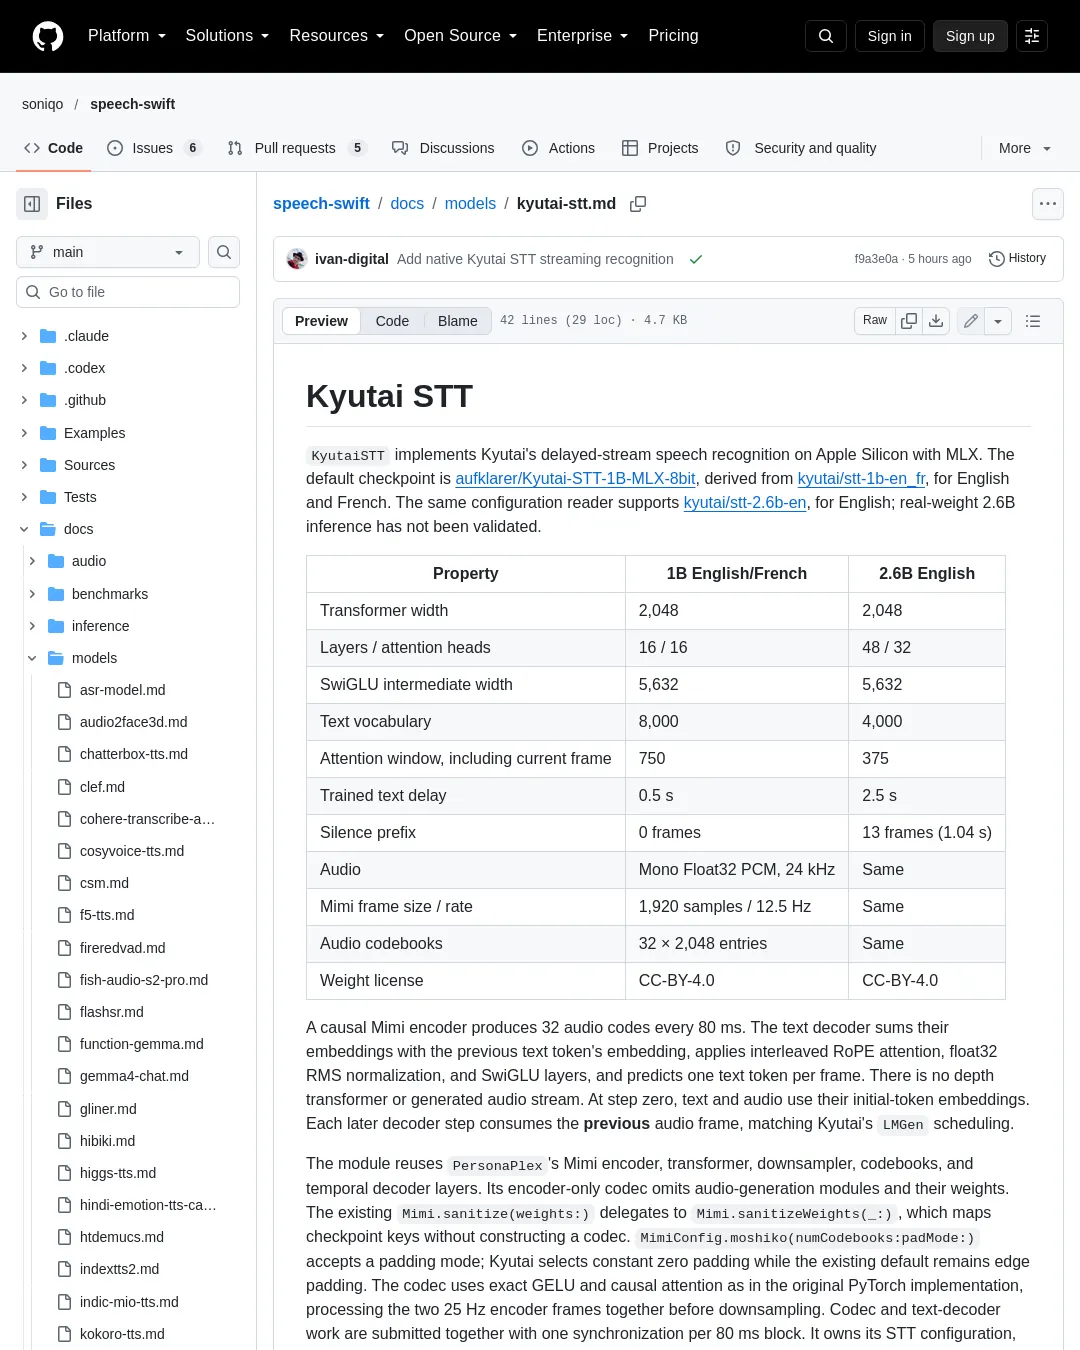
Kyutai STT 문서는 MLX를 사용해 애플 실리콘에서 Kyutai의 지연 스트리밍 음성 인식을 구현한 KyutaiSTT를 소개한다. 기본 체크포인트는 영어와 프랑스어를 지원하는 aufklarer/Kyutai-STT-1B-MLX-8bit이며, kyutai/stt-1b-en_fr에서 파생됐다. 같은 설정 로더는 영어용 kyutai/stt-2.6b-en도 지원하지만, 실제 가중치를 사용한 2.6B 추론은 검증되지 않았다.
모델 구조와 체크포인트
1B 모델은 트랜스포머 폭 2,048, 레이어 16개와 어텐션 헤드 16개, 텍스트 어휘 8,000개를 사용한다. 2.6B 모델은 폭 2,048, 레이어 48개와 헤드 32개, 어휘 4,000개다. 두 모델 모두 SwiGLU 중간 폭은 5,632이며, 1B 모델의 어텐션 윈도는 현재 프레임을 포함해 750, 학습된 텍스트 지연은 0.5초다. 2.6B 모델은 각각 375와 2.5초다. 2.6B 설정에는 13프레임, 즉 1.04초의 무음 접두부가 있고 1B 설정에는 없다. 두 모델의 가중치 라이선스는 CC-BY-4.0이다.
인과적 Mimi 인코더는 80밀리초마다 오디오 코드 32개를 만든다. 텍스트 디코더는 코드 임베딩과 이전 텍스트 토큰 임베딩을 더하고, 인터리브 RoPE 어텐션, float32 RMS 정규화, SwiGLU 계층을 거쳐 프레임마다 텍스트 토큰 하나를 예측한다. 깊이 트랜스포머나 생성 오디오 스트림은 없다. 첫 단계에서는 텍스트와 오디오의 초기 토큰 임베딩을 사용하고, 이후 단계는 이전 오디오 프레임을 입력으로 받아 Kyutai의 LMGen 스케줄링을 따른다.
이 모듈은 PersonaPlex의 Mimi 인코더, 트랜스포머, 다운샘플러, 코드북, 시간 디코더 계층을 재사용한다. 인코더 전용 코덱에서는 오디오 생성 모듈과 해당 가중치를 제외한다. 코덱은 원본 PyTorch 구현처럼 정확한 GELU와 인과적 어텐션을 사용하고, 다운샘플링 전에 25Hz 인코더 프레임 두 개를 함께 처리한다. 코덱과 텍스트 디코더 작업은 함께 제출하며 80밀리초 블록마다 한 번 동기화한다. 세션은 최근 어텐션 상태를 유지하면서 RoPE의 절대 위치를 보존하고, 과거 오디오 프레임 전체를 저장하지 않는다.
로더는 두 업스트림 저장소의 원본 PyTorch 형식 safetensors와 weight_layout: speech_swift_v1, format_version: 1을 지정한 네이티브 내보내기를 받는다. 실행에 필요한 파일은 아키텍처와 STT 타이밍이 담긴 config.json, 전체 STT 디코더 가중치가 담긴 model.safetensors, Float32로 읽는 원본 Mimi 텐서 레이아웃 파일인 mimi_name, 그리고 text_card에 맞는 SentencePiece 어휘 파일인 tokenizer_name이다.
원본 transformer.layers.*, .in_proj_weight, RMSNorm의 .alpha 키를 Swift 매개변수 트리에 대응시킨다. 디코더 가중치가 없거나 사용되지 않거나 모양이 맞지 않으면 무작위 초기화 상태로 남기지 않고 로딩을 실패시킨다. 지원하지 않는 아키텍처, 0이 아닌 코드북 지연, 잘못된 타이밍, 지원하지 않는 양자화도 모델을 할당하기 전에 거부한다.
내보내기는 FP16, affine INT4, affine INT8을 지원하며 그룹 크기는 64다. 양자화 대상은 트랜스포머의 어텐션 및 피드포워드 행렬뿐이다. 임베딩, 텍스트 출력 투영, 정규화는 FP16으로 유지하고 Mimi는 양자화하지 않고 복사한다. export.json에는 업스트림 저장소, 고정된 리비전, 정밀도, 파일 크기가 기록된다. KyutaiSTTVariant로 FP16·INT4·INT8 내보내기를 선택하며 기본값은 INT8이다. KyutaiSTTModel.upstreamModelId는 원본 1B 레이아웃을 선택하고, 로컬 내보내기는 디렉터리로 지정할 수도 있다. 실행 파일 크기에는 업스트림 Mimi 파일 전체가 포함되지만 실제로 로드하는 것은 인코딩 텐서뿐이다. 인코딩 텐서가 없거나 모양이 맞지 않으면 엄격한 로딩이 실패하며, 알 수 없는 텐서 접두사도 거부한다.
이용 범위와 제약
텍스트 언어는 오디오에서 추론한다. 언어 프롬프트와 문맥 편향 기능은 제공하지 않는다. 토큰 타임스탬프는 강제 단어 정렬 결과가 아니라, 무음 접두부와 학습된 텍스트 지연을 보정한 대략적인 프레임 위치다. Semantic VAD 추가 헤드가 포함된 체크포인트는 지원하지 않는다. 2.6B 설정과 내보내기는 지원하지만, 실제 가중치를 이용한 검증 결과는 1B 검사 결과와 구분해 보고해야 한다.
API와 CLI 예시는 추론 문서에 있다. 업스트림 구현은 delayed-streams-modeling과 Moshi다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요