기울기 없는 학습
역전파(backpropagation)는 모델을 최적화하는 유일한 방법이 아니다. 분류나 회귀처럼 정답과 오차를 하나로 정하기 쉬운 작업에서는 경사하강법으로 가중치를 갱신하기 수월하다. 하지만 여러 단계를 거치는 개방형 작업에는 하나의 ‘정답’이나 정답에 이르는 단일한 경로가 없을 수 있다. 강화학습은 한 가지 대안이지만, 작업 결과와 모델 갱신에 쓸 기울기를 연결하는 데 여러 복잡성이 따른다.
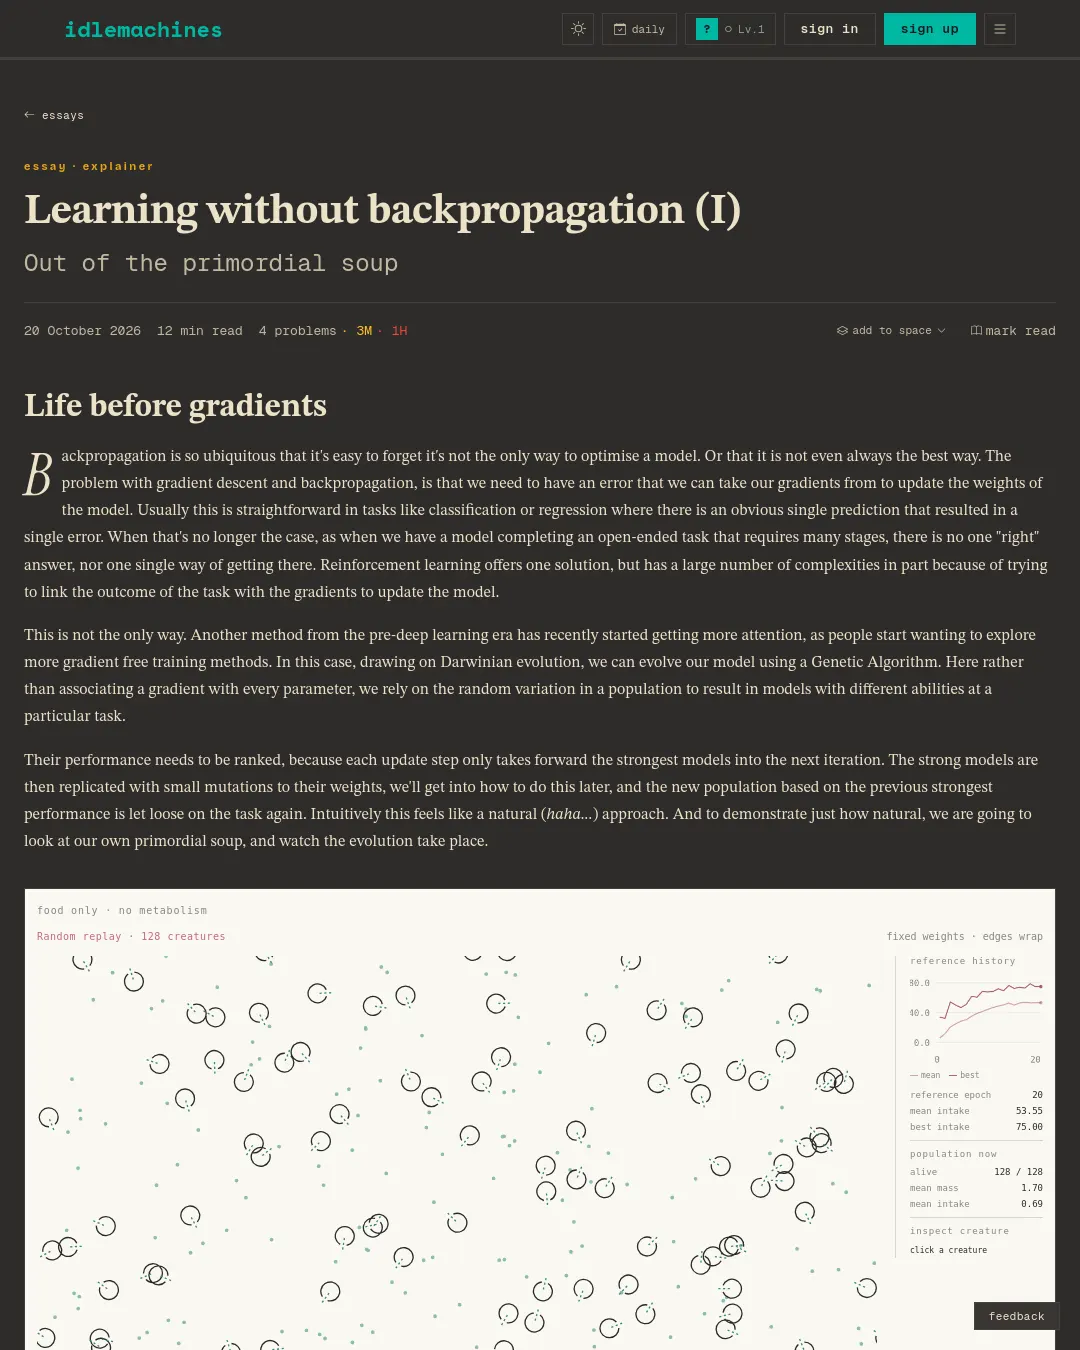
기울기 없이 학습하는 방법으로는 유전 알고리즘(Genetic Algorithm)도 있다. 개체 집단에 무작위 변이를 주고 특정 작업에서의 성과를 비교해, 성과가 좋은 모델을 다음 세대에 남기는 방식이다. 살아남은 모델은 복제되거나 가중치에 작은 변이를 겪고, 새 집단이 다시 작업을 수행한다. 이 글은 먹이를 찾는 생물 시뮬레이션을 통해 이런 행동이 어떻게 나타나는지 살펴본다.
적합도와 생존 비용
개체의 순위를 매기려면 적합도 함수가 필요하다. 앞선 예에서는 먹은 먹이의 양을 점수로 삼았다. 각 개체는 여러 세계(이 경우 4개)에서 얻은 평균 점수로 평가해, 한 세계의 우연만으로 선택되는 일을 줄인다.
\(F = \sum_i f_i\)
먹이 섭취량만 고려하면 개체들은 허용 한도에 이를 때까지 가장 가까운 먹이를 향해 빠르게 움직인다. 이동 속도에 벌점을 주면 먹이를 찾는 이득과 이동 비용을 저울질할 수 있지만, 벌점이 너무 이르면 먹이를 발견하는 행동까지 억제해 개체가 움직이지 않게 된다. 이를 조정하기 위해 움직이지 않아도 누적되는 기본 대사 비용을 함께 둔다.
\(F = \sum_i f_i - \sum_t (\beta + \alpha v_t^2)\)
이 시뮬레이션은 처음에 \(\alpha=0.0016\), \(\beta=0.002\)를 스텝마다 적용한다. 개체를 누르면 옆 패널에서 현재 대사량과 다른 속성을 볼 수 있다. 몸집이 커지면 큰 몸을 유지하는 데 드는 에너지를 반영해 대사량도 증가한다. 시뮬레이션에서는 개체가 덜 부산하게 움직이고, 근처에 먹이가 없으면 기다리다가 먹이가 나타날 때 달려가는 행동이 관찰된다.
개체의 신경망과 세대 교체
각 개체의 ‘뇌’는 비선형성을 포함한 은닉층 두 개짜리 작은 신경망이다. 입력은 가장 가까운 먹이와 시야 범위 안의 가장 가까운 다른 개체에 관한 감각 정보다. 먹이와 개체까지의 방향은 개체 자신의 진행 방향을 기준으로 한 사인과 코사인으로, 거리는 거리값으로 나타낸다. 다른 개체에 대해서는 자기 몸무게와의 상대적 질량도 입력한다. 개체 자체에서 오는 입력 두 개를 더해 총 입력은 9개다.
은닉층은 각각 16개 유닛으로 구성되고, 모든 유닛에 tanh 비선형성을 적용해 전체 매개변수는 466개다. 포식 기능을 끄면 간단히 하기 위해 개체 감각 입력은 항상 시야 안에 아무것도 없는 상태로 둔다. 처음에는 가중치가 무작위라 개체가 이리저리 돌아다니지만, 세대가 지나며 환경 자극에 대응하는 행동을 학습한다.
유전 알고리즘은 적합도가 높은 상위 K개 개체를 다음 세대의 기반으로 삼는다. 성과가 좋은 개체를 그대로 남기는 복제는 나쁜 변이로 성능이 떨어지는 일을 막는다. 변이는 각 가중치에 표준편차 0.05의 가우스 잡음을 더한다. 대부분은 성능을 떨어뜨릴 수 있지만, 일부 변이는 더 나은 가중치를 찾는다.
좋은 개체끼리 가중치를 평균 내는 교배도 가능하다. 하지만 서로 다른 계통에서 나온 신경망 가중치를 평균 내면 두 모델의 성능이 모두 희석될 수 있다. 이 시뮬레이션에서는 단순화를 위해 신경망 뇌에 교배를 적용하지 않았다. 다양성을 유지하기 위해 성과가 낮더라도 무작위 개체를 일정 비율 포함한다. 시뮬레이션에서는 128개 중 79개가 어떤 형태로든 변이를 거친 개체이고, 12개는 새 무작위 유전체다.
변이와 선택은 명시적으로 기울기를 찾지 않지만, 적합도에 변이 잡음을 반영하면 다음과 같은 기울기 추정식으로 표현할 수 있다.
\(J(\theta)=\mathbb{E}_{\varepsilon}[F(\theta+\sigma\varepsilon)]\)
\(\nabla_\theta J(\theta)=\frac{1}{\sigma}\mathbb{E}_{\varepsilon}[F(\theta+\sigma\varepsilon)\varepsilon]\)
변이 개체들의 순위를 매기면 이 기대값의 잡음이 있는 표본을 얻는다. 즉, 기울기를 직접 계산하지 않고 선택을 통해 기울기를 추정한다. 여기서 ‘기울기 없음’은 학습 과정에서 기울기 정보를 얻지 못한다는 뜻이라기보다, 기울기를 직접 계산하지 않는다는 뜻에 가깝다.
이 시뮬레이션은 각 전략을 별도로 실행해 서로 비교하지 않았다. 대신 몸집을 키우고 그 몸집을 유지하는 비용을 추가한 뒤, 기존에 저장한 신경망을 새 규칙에서 실행한다.
포식과 회피
새 규칙에서는 질량이 더 큰 개체가 다른 개체를 먹고, 먹힌 개체의 질량을 얻는다. 먹힌 개체는 다음 세대의 후보에서 제외된다. 먹이를 먹는 일은 점수를 높이는 동시에 방어 수단이 된다. 자신보다 약간 약한 개체를 먹으면 큰 보상을 얻을 수 있지만, 먹이 또는 다른 개체가 먹은 먹이로 상대가 더 강해질 위험도 있다. 시뮬레이션에서는 진화 압력에 따라 추격과 회피 행동이 나타난다.
감각 범위와 일반화
시야 반경과 추적하는 대상 수는 가중치처럼 변이할 수 있다. 감각을 자유롭게 진화시킨 개체는 처음 보는 세계에서 먹이를 평균 10.21개 먹었고, 먹이와 경쟁자를 각각 하나씩만 추적하도록 제한된 개체는 8.04개를 먹었다. 반면 생존율은 자유롭게 감각을 진화시킨 경우 43.4%, 제한한 경우 51.8%였다. 시야 거리를 제한해도 두 수치는 달라지지 않았다. 이 결과에서는 얼마나 멀리 보는지보다 몇 가지 대상을 추적하는지가 차이를 보였다.
추가 입력이 탐색을 어렵게 할 수 있지만, 이 실험에서는 개체마다 탐색 공간의 크기가 달라지지는 않는다. 실행 하나 안의 유전체 길이는 모두 1,474개 가중치와 감각 유전자 3개로 같다. 뇌 크기는 각 개체가 실제로 진화시킨 감각 수가 아니라 슬롯 상한으로 정해져, 슬롯 하나만 쓰는 개체도 열 개 모두에 해당하는 가중치를 보유하고 변이시킨다. 따라서 차원 비용은 슬롯 상한을 정할 때 한 번 발생하고, 감각을 실제로 사용하는 비용은 생존율에 나타난다.
선택은 개체가 실제로 경험한 세계만을 기준으로 이뤄진다. 이 실험에서 24세대 동안 개체들은 두 세계를 경험했다. 가중치를 고정한 채 먹이 위치를 바꾸자, 학습에 사용한 두 세계에서는 먹이를 10.19개 먹고 생존율은 43.2%였다. 처음 보는 12개 세계에서는 먹이를 10.21개 먹고 생존율은 43.4%였다. 새 세계에서의 수치가 근소하게 높았다.
신경망에 입력되는 것은 세계 안의 위치가 아니라 가장 가까운 먹이와 경쟁자의 방향 및 거리다. 따라서 새 배치는 개체가 보는 관점에서 같은 분포에서 새로 뽑힌 환경에 해당하며, 외울 만한 배치별 정보가 없다. 하지만 환경 배치가 아니라 조건이 바뀌면 성과가 떨어진다. 먹이 양을 절반으로 줄이면 섭취량은 10.21개에서 4.34개로 감소하고, 생존율은 39.0%까지 낮아진다.
장난감 시뮬레이션을 넘어
이 시뮬레이션은 단순한 예시다. 다만 상태가 오래 이어지는 복잡한 환경에서 모델을 활용하려는 관심이 커지면서 기울기 없는 학습 방법도 다시 주목받고 있다. 글은 강화학습이 여전히 이 분야의 지배적인 학습 방식이라고 설명하면서, 기울기 없는 방법도 활용될 여지가 있다고 본다. 다음 편에서는 익숙한 문제를 다루며 장난감 시뮬레이션에서 실제 적용으로 넘어가는 방법을 살펴볼 예정이다.
관련 연습 문제: 진화 전략의 기울기 추정, 평균을 내기 전 은닉 유닛 정렬하기, 유전 알고리즘의 세대 갱신, 교차 엔트로피 방법의 단계
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요