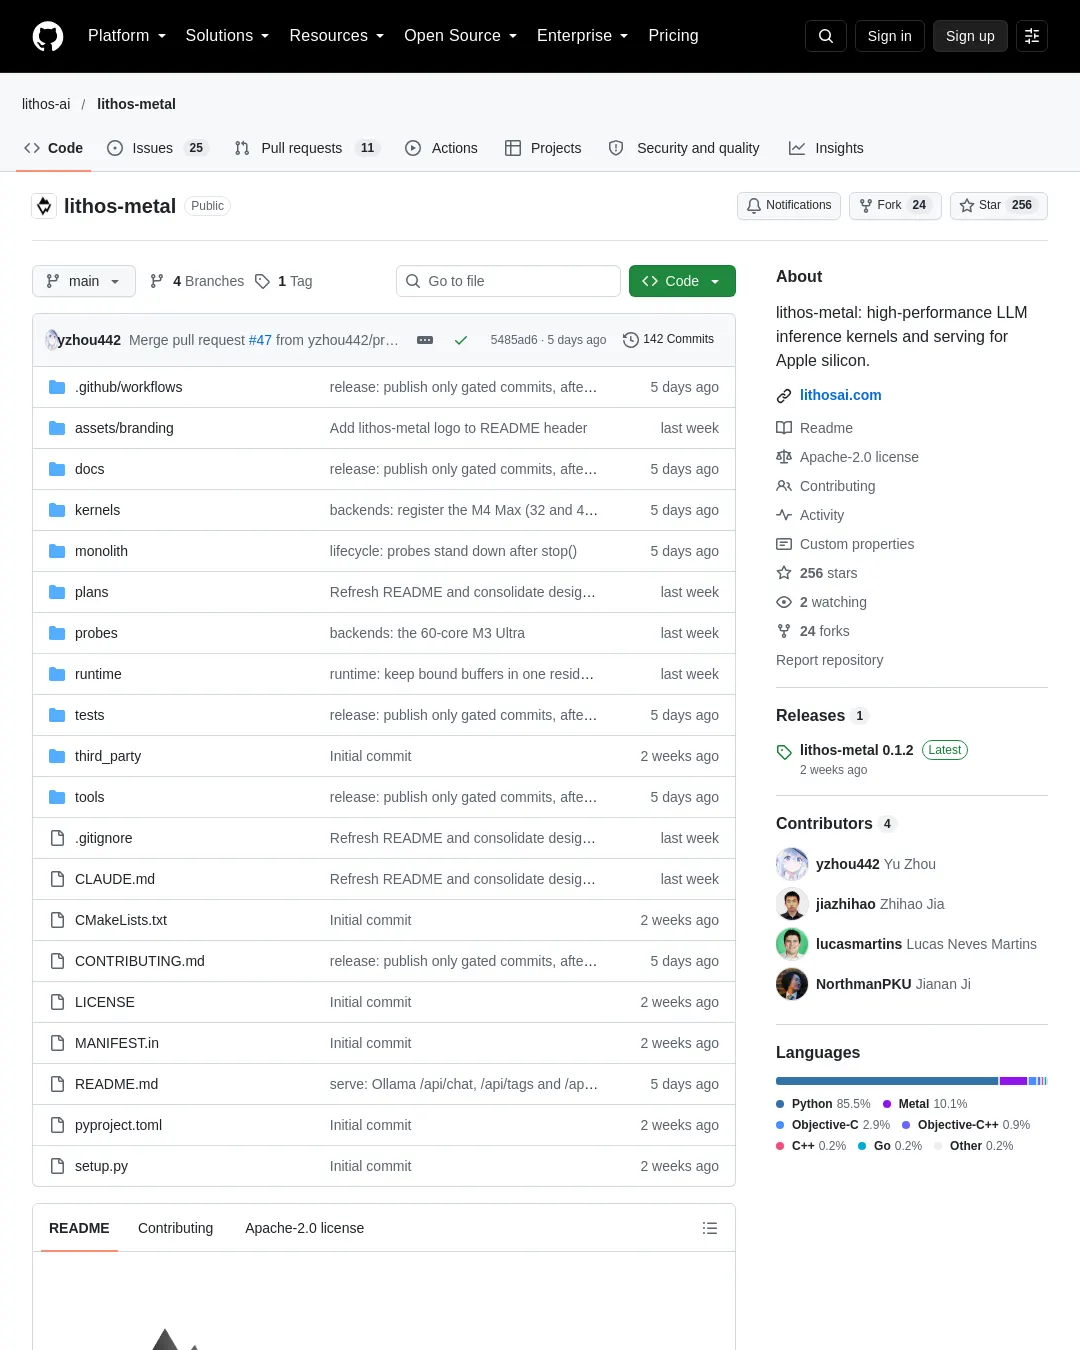
lithos-metal은 애플 실리콘 맥에서 대형 언어 모델을 로컬로 실행하는 오픈소스 추론 엔진이다. 제작자는 40코어 M5 Max와 통합 메모리 48GB에서 Qwen3.8-27B-NVFP4를 구동했을 때, 128토큰 문맥 기준 목표 모델 계산량이 초당 약 168토큰이라고 제시했다. 이는 초안 생성과 토큰 승인 처리 등을 제외한 수치이므로 실제 전체 생성 속도나 다른 엔진 대비 속도 향상을 뜻하지 않는다.
사용하려면 macOS 26 이상을 실행하는 애플 실리콘 맥과 모델·초안 모델·문맥을 담을 충분한 통합 메모리가 필요하다. 사전 컴파일 패키지는 Homebrew 탭에서 설치할 수 있다.
brew install lithos-ai/tap/lithos-metal
lithos-metal serve --model nvidia/Qwen3.8-27B-NVFP4
서버는 대상 모델과 짝을 이루는 DSpark 초안 모델을 내려받고, 가중치 팩을 준비한 뒤 기기에 맞는 커널 설정을 선택한다. 시작 과정에는 컴파일과 워밍업이 포함된다. 기본 문맥 용량은 32K이며 --max-context로 조정할 수 있다. 기본 설정에서 DSpark는 토큰 7개를 제안하고 대상 모델은 이를 앵커 토큰 하나와 함께 검증한다. 초안 생성 없이 실행하려면 --no-draft를, 다른 초안 체크포인트를 지정하려면 --draft PATH_OR_HUB_ID를 사용한다.
이 엔진은 Apple GPU용 Metal 메가커널과 GPU 상주 생성 제어를 사용한다. DSpark는 여러 토큰 후보를 한 번의 대상 모델 처리에서 검증해 대상 모델의 가중치 읽기 비용을 나누는 방식이다. 다만 저장소는 35B 하이브리드 MoE 통합을 실험 단계라고 밝히며, 칩 백엔드에 따라 측정 여부와 메가커널 최적화 지원이 다르다고 설명한다. 지원 모델과 하드웨어, 설치 방법은 lithos-metal 저장소에서 확인할 수 있다.
성능 수치는 8행 대상 모델 처리 한 번에 평균 6개 토큰이 승인된다는 가정에 따른 목표 모델 계산량이다. 초안 생성, 승인 처리, 되감기 비용은 제외됐으며, 저장소는 이를 실제 종단 간 생성 속도나 직접적인 종단 간 속도 비교로 볼 수 없다고 명시한다. 비교 자료와 재현 정보는 백엔드 비교 보고서에서 확인할 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요